 spdx/tools-python
Eine Python-Bibliothek zum Parsen, Validieren und Erstellen von SPDX-Dokumenten.

CI-Status (Linux, macOS und Windows): 
Bitte beachten Sie, dass die kommende Version 0.8 einem umfassenden Refactoring unterzogen wurde, um die bevorstehende SPDX-v3.0-Veröffentlichung vorzubereiten, was zu Breaking Changes an der API führt. Bitte lesen Sie die Migrationsanleitung, um Ihren vorhandenen Code anzupassen.
Die Hauptfunktionen von v0.8 sind:
Beachten Sie, dass v0.8 nur das Schreiben, nicht das Lesen von SPDX-3.0-Dokumenten unterstützt. Einzelheiten finden Sie unter #760.
Diese Bibliothek implementiert SPDX-Parser, Konverter, Validatoren und Handler in Python.
Wichtige Aktualisierungen zu dieser Bibliothek werden über die SPDX-Tech-Mailingliste bekannt gegeben: https://lists.spdx.org/g/Spdx-tech.
AGraph.
Hinweis: Dies ist eine optionale Funktion und erfordert
die zusätzliche Installation optionaler AbhängigkeitenSiehe Schnellstart zu SPDX 3.0 weiter unten. Die Implementierung basiert auf den beschreibenden Markdown-Dateien im Repository https://github.com/spdx/spdx-3-model (commit: a5372a3c145dbdfc1381fc1f791c68889aafc7ff). Das neueste SPDX-3.0-Modell ist verfügbar unter https://spdx.github.io/spdx-spec/v3.0/serializations/.
Wie immer sollten Sie in einer virtuellen Umgebung (venv) arbeiten. Sie können einen lokalen Klon
dieses Repos mit yourenv/bin/pip install . installieren oder es von PyPI installieren
(prüfen Sie die neueste Version und installieren Sie sie z. B. mit
yourenv/bin/pip install spdx-tools==0.8.3). Beachten Sie, dass es unter Windows Scripts
statt bin wäre.
PARSEN/VALIDIEREN (zum Parsen jedes Formats):
Verwenden Sie pyspdxtools -i <filename>, wobei <filename> der Speicherort der Datei ist. Das Eingabeformat wird automatisch anhand der Dateiendung erkannt.
Wenn Sie eine Source-Distribution verwenden, versuchen Sie Folgendes auszuführen:
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json
KONVERTIEREN (zum Konvertieren von einem Format in ein anderes):
Verwenden Sie pyspdxtools -i <input_file> -o <output_file>, wobei <input_file> der Speicherort der zu konvertierenden Datei
und <output_file> der Speicherort der Ausgabedatei ist. Die Eingabe- und Ausgabeformate werden automatisch anhand der Dateiendungen erkannt.
Wenn Sie eine Source-Distribution verwenden, versuchen Sie Folgendes auszuführen:
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json -o output.tag
Wenn Sie den Validierungsprozess überspringen möchten, geben Sie das Flag --novalidation an, wie folgt:
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json -o output.tag --novalidation
(Verwenden Sie dies mit Vorsicht: Beachten Sie, dass unerkannte ungültige Dokumente zu unerwartetem Verhalten des Tools führen können)
Für Hilfe verwenden Sie pyspdxtools --help
GRAPHERZEUGUNG (optionale Funktion)
Diese Funktion erzeugt einen Graphen, der alle Elemente im SPDX-Dokument und ihre Verbindungen basierend auf den angegebenen
Beziehungen darstellt. Der Graph kann als Bild gerendert werden. Nachfolgend finden Sie ein Beispiel für die Datei tests/spdx/data/SPDXJSONExample-v2.3.spdx.json:
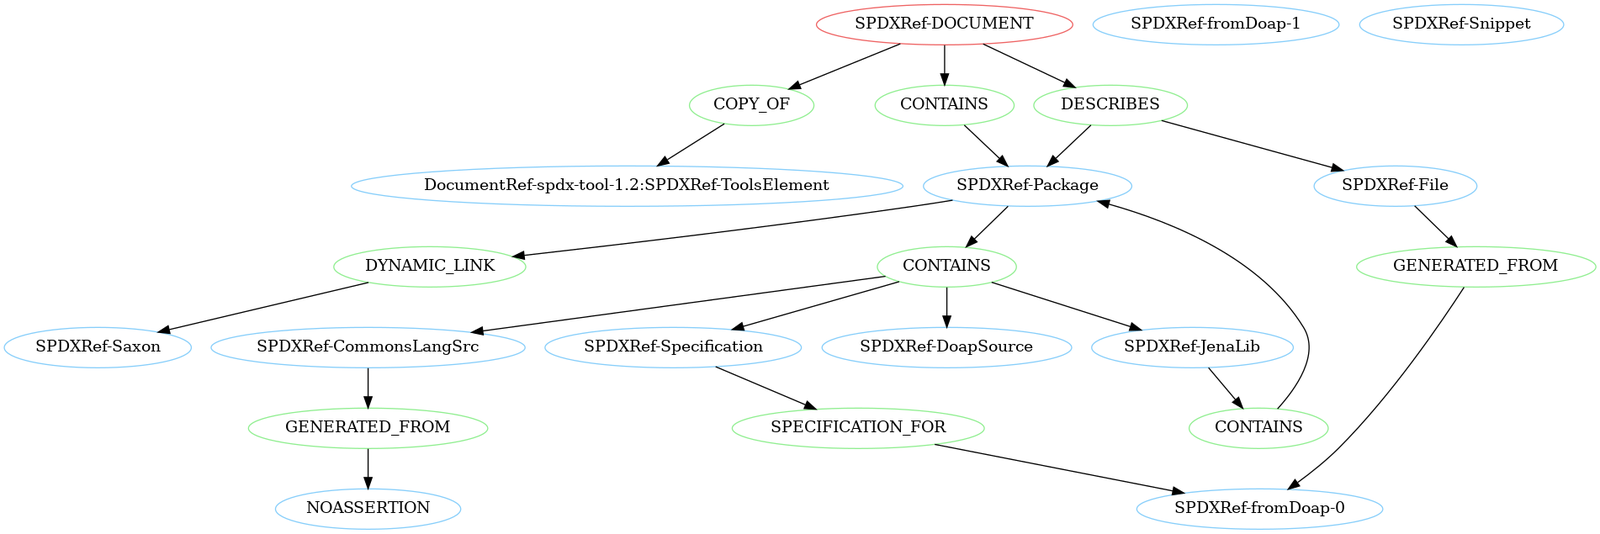
Stellen Sie sicher, dass Sie die optionalen Abhängigkeiten networkx und pygraphviz installieren. Führen Sie dazu pip install ".[graph_generation]" aus.
Verwenden Sie pyspdxtools -i <input_file> --graph -o <output_file>, wobei <output_file> ein Ausgabedateiname mit gültigem Format für pygraphviz ist (sehen Sie
sich die Dokumentation hier an).
Wenn Sie eine Source-Distribution verwenden, versuchen Sie Folgendes auszuführen:
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json --graph -o SPDXJSONExample-v2.3.spdx.png, um
ein PNG mit einer Übersicht über die Struktur der Beispieldatei zu erzeugen.
DATENMODELL
spdx_tools.spdx.model bildet das interne SPDX-v2.3-Datenmodell (v2.2 ist lediglich eine Teilmenge davon). Alle relevanten Klassen für die Erstellung von SPDX-Dokumenten werden in der __init__.py bereitgestellt, die Sie hier finden.@dataclass_with_properties implementiert, eine benutzerdefinierte Erweiterung von @dataclass.ConstructorTypeError bzw. TypeError aus). Dadurch lassen sich ungültige Eigenschaften frühzeitig erkennen und es werden nur gültige Dokumente erstellt.list.append(item) umgehen die Typprüfung (ein TypeError wird dennoch ausgelöst, wenn list erneut gelesen wird). Wir empfehlen, stattdessen list = list + [item] zu verwenden.Document aus dem Modul document.py, die mit allen anderen Klassen verknüpft ist.documentDescribes und hasFiles: Diese Felder werden im internen Datenmodell in Beziehungen umgewandelt. Da sie veraltet sind, werden diese Felder nicht in die Ausgabe geschrieben.PARSEN
