
 protectai/modelscan
Schutz vor Modell-Serialisierungsangriffen


Modelle des maschinellen Lernens (ML) werden öffentlich über das Internet, innerhalb von Teams und teamübergreifend geteilt. Der Aufstieg der Foundation Models hat dazu geführt, dass öffentliche ML-Modelle zunehmend für weiteres Training beziehungsweise Fine-Tuning verwendet werden. ML-Modelle werden immer häufiger eingesetzt, um kritische Entscheidungen zu treffen und geschäftskritische Anwendungen zu betreiben. Trotzdem werden Modelle noch nicht mit der gleichen Sorgfalt gescannt wie eine PDF-Datei in Ihrem Posteingang.
Das muss sich ändern, und die richtigen Werkzeuge sind der erste Schritt.
ModelScan ist ein Open-Source-Projekt von Protect AI, das Modelle scannt, um festzustellen, ob sie unsicheren Code enthalten. Es ist das erste Modell-Scan-Tool, das mehrere Modellformate unterstützt. ModelScan unterstützt derzeit die Formate H5, Pickle und SavedModel. Das schützt Sie bei der Verwendung von PyTorch, TensorFlow, Keras, Sklearn, XGBoost – weitere folgen.
Wenn Sie bereit sind, mit dem Scannen Ihrer Modelle zu beginnen, ist es einfach:
pip install modelscan
Nach der Installation scannen Sie ein Modell:
modelscan -p /path/to/model_file.pkl
Modelle werden oft von automatisierten Pipelines erstellt, andere stammen möglicherweise vom Laptop eines Data Scientists. In beiden Fällen muss das Modell von einer Maschine zur anderen bewegt werden, bevor es verwendet wird. Dieser Prozess des Speicherns eines Modells auf der Festplatte wird als Serialisierung bezeichnet.
Ein Model-Serialization-Angriff liegt vor, wenn schädlicher Code während der Serialisierung (Speichern) vor der Verteilung zu den Inhalten eines Modells hinzugefügt wird – eine moderne Version des Trojanischen Pferdes.
Der Angriff nutzt den Speicher- und Ladevorgang von Modellen aus. Wenn Sie ein Modell mit model = torch.load(PATH) laden, öffnet PyTorch den Inhalt der Datei und beginnt, den darin enthaltenen Code auszuführen. In dem Moment, in dem Sie das Modell laden, ist der Exploit bereits ausgeführt.
Ein Model-Serialization-Angriff kann verwendet werden, um Folgendes auszuführen:
Diese Angriffe sind unglaublich einfach auszuführen, und funktionierende Beispiele finden Sie in unserem 📓-Ordner notebooks.
ModelScan bietet ein robustes Open-Source-Scanning. Wenn Sie umfassende KI-Sicherheit benötigen, ziehen Sie Guardian in Betracht. Es ist unser Unternehmensprodukt für das Scannen von Modellen.
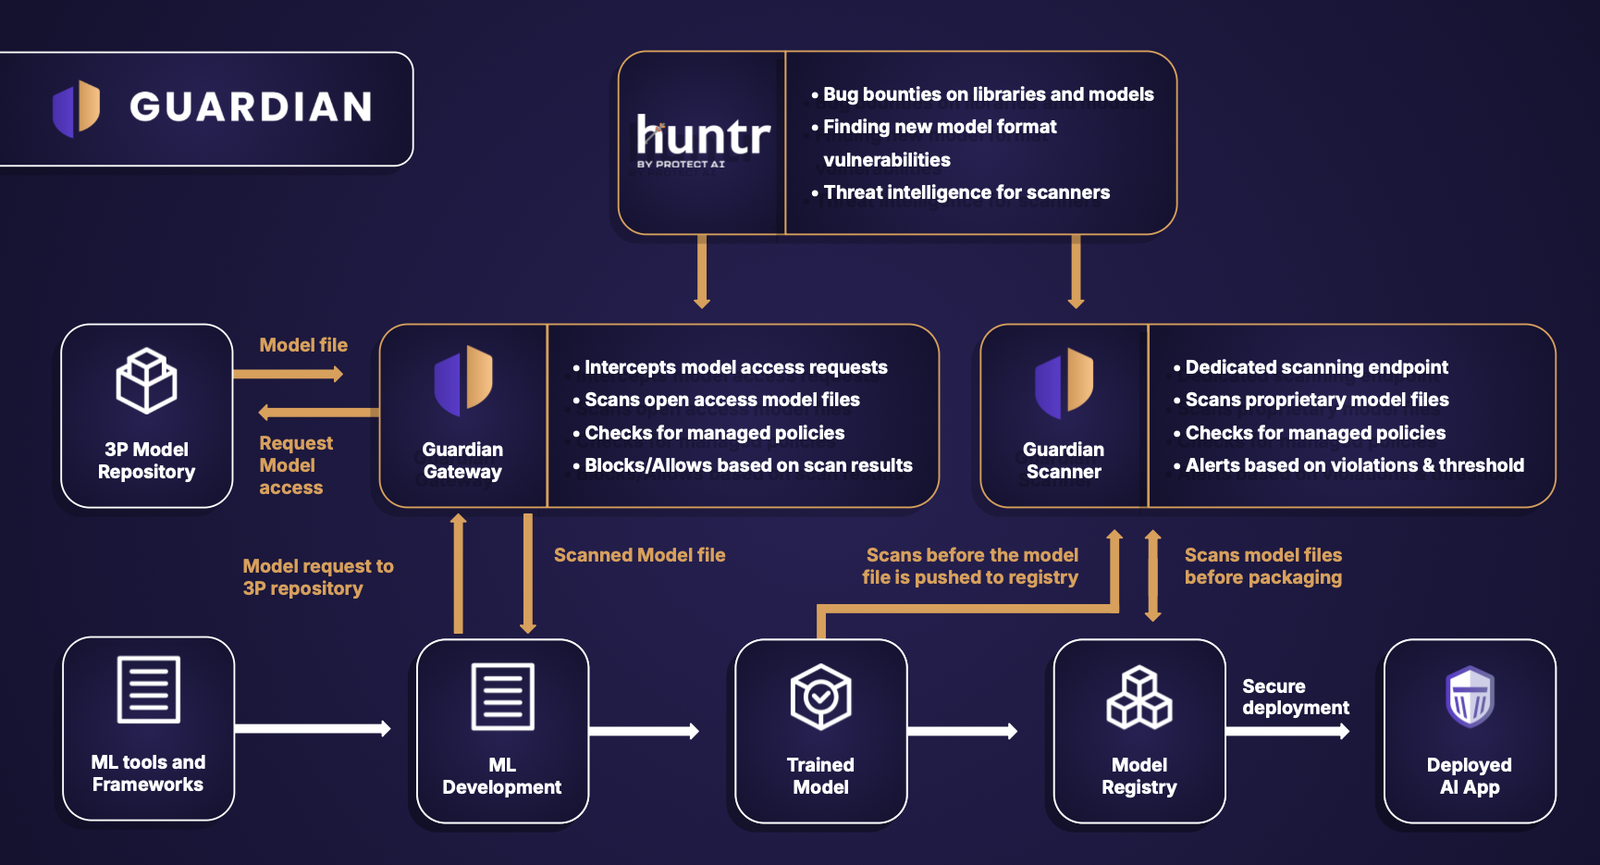
Wenn das Laden eines Modells mit Ihrem Machine-Learning-Framework den Angriff automatisch ausführt, wie prüft ModelScan den Inhalt, ohne den bösartigen Code zu laden?
Einfach: Es liest den Inhalt der Datei Byte für Byte wie eine Zeichenkette und sucht nach unsicheren Codesignaturen. Das macht es unglaublich schnell – Modelle werden in der Zeit gescannt, die Ihr Computer benötigt, um die gesamte Dateigröße von der Festplatte zu verarbeiten (in den meisten Fällen Sekunden). Außerdem ist es sicher.
ModelScan stuft den unsicheren Code wie folgt ein:
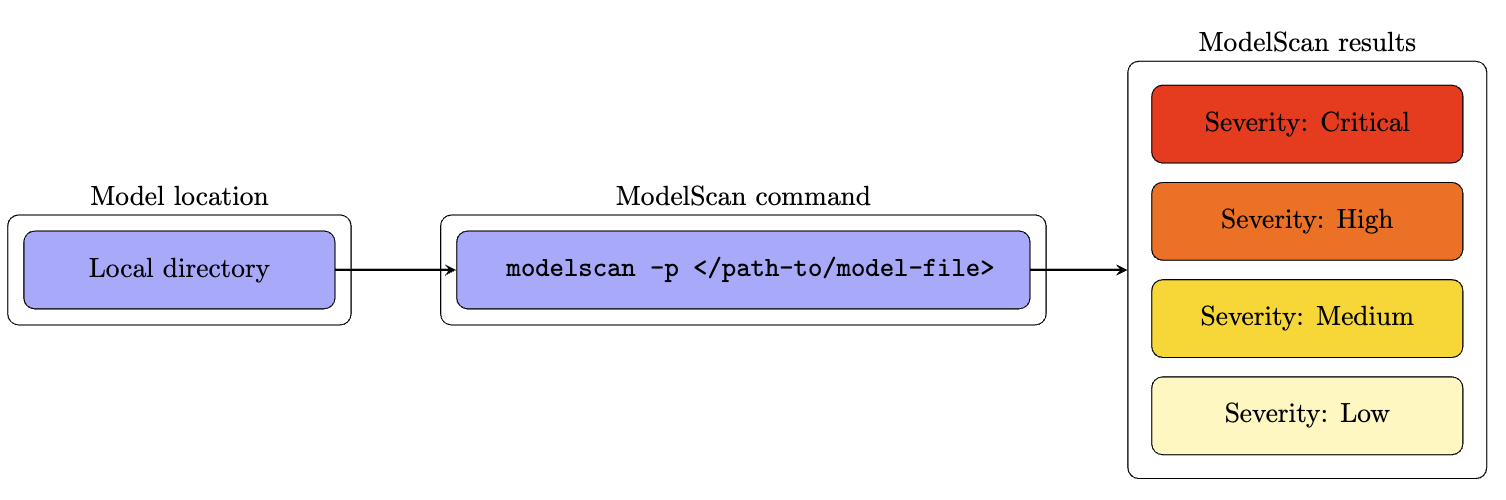
Wenn ein Problem erkannt wird, wenden Sie sich sofort an die Autoren des Modells, um die Ursache zu ermitteln.
In einigen Fällen kann Code in das Modell eingebettet sein, um die Reproduktion als Data Scientist zu erleichtern, aber das macht Sie angreifbar. Nutzen Sie Ihr Ermessen, um zu entscheiden, ob das für Ihre Arbeitslasten angemessen ist.
Dies wird kontinuierlich erweitert. Achten Sie also auf Änderungen in unseren Versionshinweisen.
Derzeit unterstützt ModelScan jedes von Pickle abgeleitete Format und viele weitere: