 p-e-w/heretic
Vollautomatische Zensurentfernung für Sprachmodelle

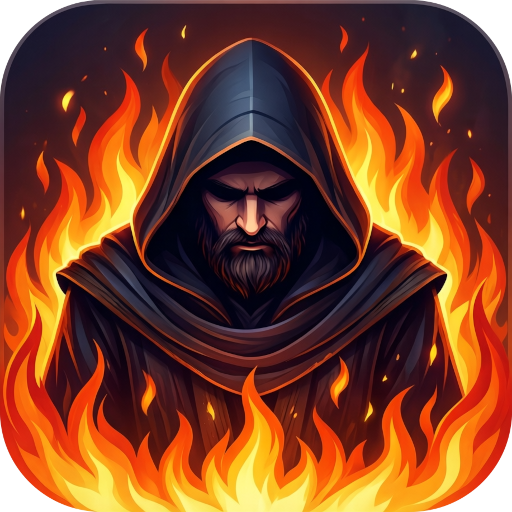


Heretic ist ein Werkzeug, das Zensur (auch „Safety Alignment" genannt) aus transformerbasierten Sprachmodellen entfernt, ohne teures Post-Training. Es kombiniert eine fortschrittliche Implementierung der direktionalen Ablation, auch bekannt als „Abliteration" (Arditi et al. 2024, Lai 2025 (1, 2)), mit einem TPE-basierten Parameteroptimierer, der von Optuna angetrieben wird.
Dieser Ansatz ermöglicht es Heretic, vollständig automatisch zu arbeiten. Heretic findet hochwertige Abliteration-Parameter, indem es gleichzeitig die Anzahl der Verweigerungen und die KL-Divergenz vom Originalmodell minimiert. Das Ergebnis ist ein entzensiertes Modell, das so viel von der Intelligenz des Originalmodells wie möglich beibehält. Die Verwendung von Heretic erfordert kein Verständnis der Interna von Transformern. Tatsächlich kann jeder, der weiß, wie man ein Kommandozeilenprogramm ausführt, Heretic zur Entzensierung von Sprachmodellen verwenden.
Heretic unterstützt die meisten dichten Modelle, einschließlich vieler multimodaler Modelle, verschiedener MoE-Architekturen und sogar einiger Hybridmodelle wie Qwen3.5. Reine State-Space-Modelle und bestimmte andere Forschungsarchitekturen werden noch nicht out of the box unterstützt.
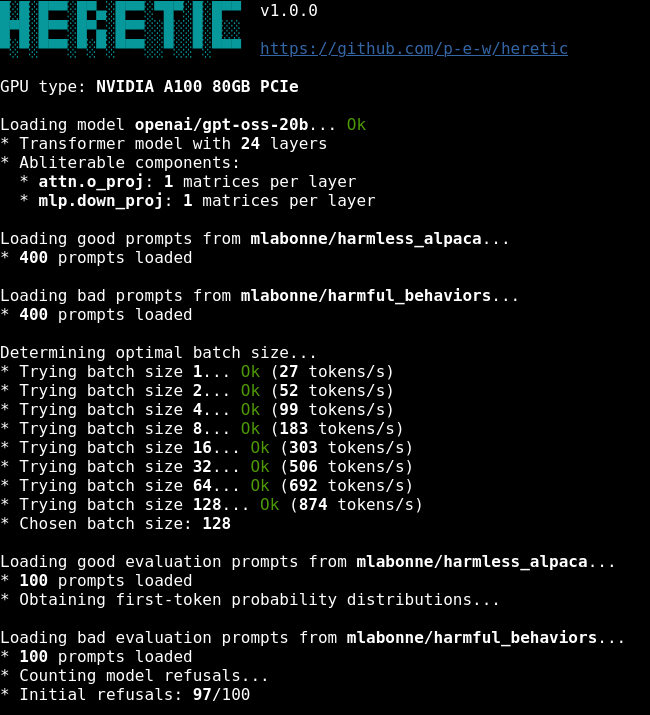
Im unbeaufsichtigten Betrieb mit der Standardkonfiguration kann Heretic entzensierte Modelle erzeugen, die in ihrer Qualität mit manuell von menschlichen Experten erstellten Abliterationen konkurrieren:
| Modell | Verweigerungen bei „schädlichen" Prompts | KL-Divergenz vom Originalmodell bei „harmlosen" Prompts |
|---|---|---|
| google/gemma-3-12b-it (Original) | 97/100 | 0 (per Definition) |
| mlabonne/gemma-3-12b-it-abliterated-v2 | 3/100 | 1.04 |
| huihui-ai/gemma-3-12b-it-abliterated | 3/100 | 0.45 |
| p-e-w/gemma-3-12b-it-heretic (unseres) | 3/100 | 0.16 |
Die Heretic-Version, die ohne jeglichen menschlichen Aufwand erzeugt wurde, erreicht
dasselbe Maß an Verweigerungsunterdrückung wie andere Abliterationen, jedoch mit
einer viel geringeren KL-Divergenz, was auf weniger Schaden für die Fähigkeiten des
Originalmodells hindeutet.
(Sie können diese Zahlen mit der in Heretic integrierten Evaluierungsfunktion
reproduzieren, z. B. heretic --model google/gemma-3-12b-it --evaluate-model p-e-w/gemma-3-12b-it-heretic.
Beachten Sie, dass die genauen Werte plattform- und hardwareabhängig sein können.
Die obige Tabelle wurde mit PyTorch 2.8 auf einer RTX 5090 erstellt.)
Natürlich erzählen mathematische Metriken und automatisierte Benchmarks nie die ganze Geschichte und sind kein Ersatz für menschliche Bewertung. Mit Heretic erzeugte Modelle wurden von Nutzern gut aufgenommen (Links und Hervorhebungen hinzugefügt):
„Ich war vorher skeptisch, aber ich habe gerade GPT-OSS 20B Heretic heruntergeladen und heilige Scheiße. Es gibt ordentlich formatierte lange Antworten auf sensible Themen, verwendet genau die unzensierten Wörter, die man von einem unzensierten Modell erwarten würde, erzeugt Markdown-Tabellen mit Details und so weiter. Sieht so aus, als wäre dies die beste abliterierte Version dieses Modells bisher..." (Link zum Kommentar)
„Heretic GPT 20b scheint das beste unzensierte Modell zu sein, das ich bisher ausprobiert habe. Es zerstört nicht die Intelligenz des Modells und es beantwortet Prompts, die vom Basismodell normalerweise abgelehnt würden." (Link zum Kommentar)
„[Qwen3-4B-Instruct-2507-heretic] war das beste nicht quantisierte abliterierte Modell, das ich auf 16 GB VRAM ausführen konnte." (Link zum Kommentar)
Heretic-Modelle wurden auch unabhängig mit Standardmetriken wie MMLU und GSM8K benchmarkt und schnitten im Vergleich zu Modellen, die von konkurrierenden Abliteration-Werkzeugen erzeugt wurden, günstig ab: 1, 2.
Die Community hat weit über 5000 Modelle mit Heretic erstellt und veröffentlicht.
Bereiten Sie eine Python-3.10+-Umgebung mit PyTorch 2.2+ vor, das für Ihre Hardware geeignet installiert ist. Führen Sie dann aus:
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507
Ersetzen Sie Qwen/Qwen3-4B-Instruct-2507 durch das Modell, das Sie entzensieren möchten.
[!IMPORTANT]
Obwohl PyTorch 2.2 die Mindestversion von PyTorch ist, die für Heretic benötigt wird, können einige Modelle und Konfigurationen Funktionen erfordern, die nur in späteren Versionen zu finden sind. Beispielsweise verwendet das Laden von MXFP4-quantisierten Modellen wie gpt-oss
torch.accelerator, das in PyTorch 2.6 hinzugefügt wurde.
[!TIP]
Heretic verwendet uv für die Abhängigkeitsverwaltung, und das Repository enthält eine
uv.lock-Datei, die jede Paketversion fixiert. Wenn Sie uv bereits verwenden (und das sollten Sie wahrscheinlich!), können Sie einfach das Repo klonen und Heretic mituv run hereticausführen, was sicherstellt, dass Ihre Abhängigkeiten mit denen übereinstimmen, die von den Entwicklern verwendet werden, was Zuverlässigkeit und Sicherheit verbessert.
Der Prozess ist vollautomatisch und erfordert keine Konfiguration; jedoch
verfügt Heretic über eine Vielzahl von Konfigurationsparametern, die für
mehr Kontrolle geändert werden können. Führen Sie heretic --help aus, um die verfügbaren
Kommandozeilenoptionen zu sehen, oder schauen Sie sich config.default.toml an, wenn Sie
eine Konfigurationsdatei bevorzugen.
