
 jev-sec/jev-ids
Blitzschnelles, token-effizientes Intrusion Detection System (IDS) auf Basis von TypeSafe's Jev.


Intrusion Detection in einer Anfrage. Zeigen Sie TypeSafe's Jev einen Netzwerkfluss und fünf beschriftete Beispiele. Es antwortet, ob der Fluss ein Angriff ist und welcher Art, in einer halben Sekunde, ohne Text zu parsen.
Jev IDS wurde auf NSL-KDD getestet, einem Referenz-Benchmark der Cybersecurity-Community, gegen ein State-of-the-Art-LLM (Gemini 3.6 Flash auf Vertex AI), ein klassisches Machine-Learning-Modell (Random Forest) und ein unüberwachtes (Isolation Forest): 2.000 Flüsse, drei Seeds, k von 0 bis 8 Beispielen pro Kategorie. Mit denselben fünf Beispielen (k = 1) war Jev IDS:
Das LLM ist der bessere Detektor bei F1: 0,880 gegenüber Jevs 0,856 bei k = 1, und bei jedem k voraus (McNemar p < 0,001), weil es mehr Angriffe der in den Beispielen gezeigten Arten erkennt. Jev ist der zweitbeste, und bei Zero-Day-Angriffen, Arten, die in den Beispielen fehlen, erkennt es mehr als das LLM von k = 1 bis k = 8 (0,747 gegenüber 0,713 bei k = 1). Die Zahlen, die Abbildungen und ihre Grenzen stehen in Evidenz und Grenzen und docs/results.md.
Die Schleife lesen · Die Anfragevorlage · Glossar
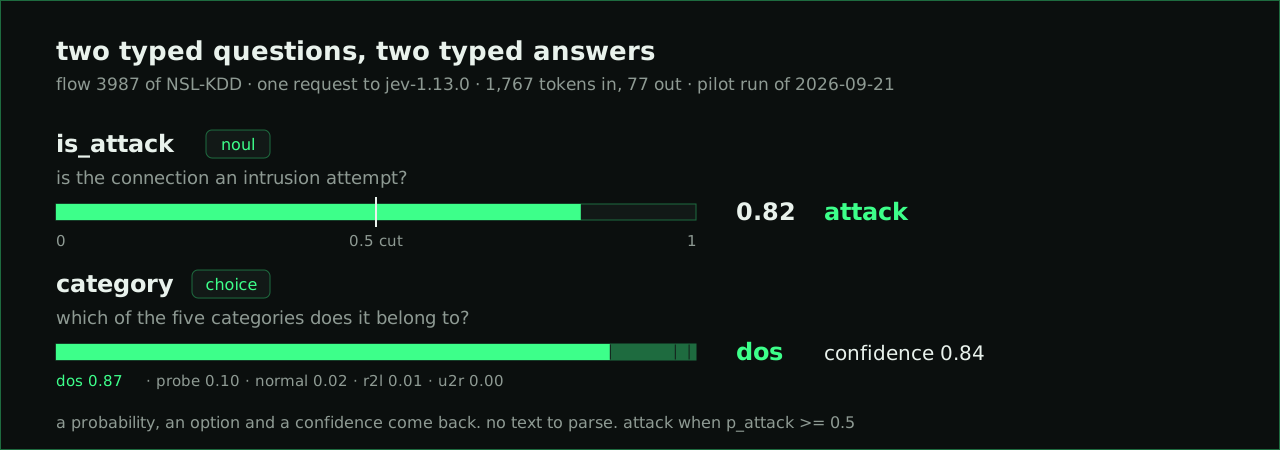
Jev ist ein System-One-Modell. Statt Text zu schreiben, liest es einen state und beantwortet typisierte Fragen darüber mit Wahrscheinlichkeiten. Jev IDS legt einen Fluss in den State, neben die Anweisungen, die Spaltennamen, die fünf Kategoriebeschreibungen und die beschrifteten Beispiele, und stellt zwei Fragen. is_attack kommt als Wahrscheinlichkeit zurück. category kommt als eine von fünf Optionen mit einer Konfidenz zurück. Das Urteil lautet Angriff, wenn die Wahrscheinlichkeit 0,5 erreicht.
Jede Anfrage folgt demselben Pfad:
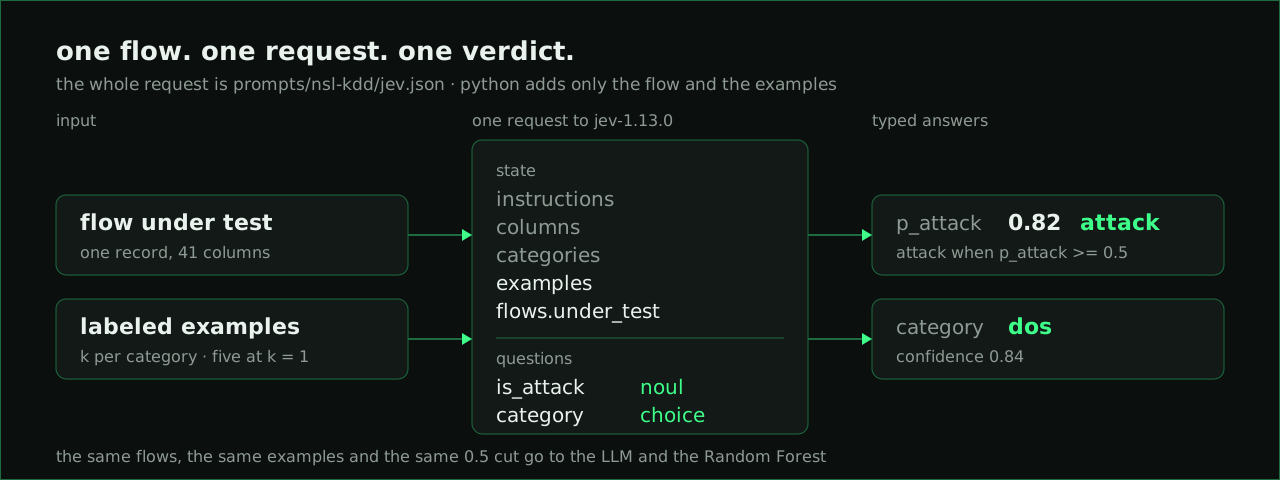
Die gesamte Anfrage ist eine Datei, prompts/nsl-kdd/jev.json. Python fügt nur den Fluss und die Beispiele hinzu, und der sha256 der Datei wandert in jede Vorhersagezeile als prompt_hash, sodass Läufe, die unterschiedliche Dinge gefragt haben, niemals als gleich verglichen werden. Beispiele werden nur nach Kategorie beschriftet: Angriffsnamen wie neptune erreichen niemals ein Modell.
Dieselben Flüsse, Beispiele und die 0,5-Grenze gehen an zwei Baselines: ein LLM über einen Agno-Agenten mit einem JSON-Ausgabeschema (Gemini 3.6 Flash über Vertex AI im Paper; GPT-5.6 über das ChatGPT-Codex-Backend oder DeepSeek als Alternativen) und einen scikit-learn Random Forest, der auf denselben Beispielen trainiert wurde. Eine dritte Baseline, ein Isolation Forest, der allein auf den benignen Flüssen des Pools angepasst wurde, sieht niemals ein Beispiel: es ist die unüberwachte Referenz, nur bei k = all.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
Laden Sie NSL-KDD nach data/raw/nsl-kdd/ herunter und bereiten Sie es einmal vor:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
Der Smoke-Split umfasst fünf Flüsse. Der Lauf schreibt results/<timestamp>-nsl-kdd-jev-smoke/ mit config.json, einer JSON-Zeile pro Fluss in predictions.jsonl (das Urteil, die Wahrheit, p_attack, die Kategorie, die Konfidenz, die Latenz und der Token-Bericht des Gateways) und die Rohantworten in responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k ist die Anzahl der beschrifteten Beispiele pro Kategorie. k = 1 mit fünf Kategorien bedeutet fünf Beispiele, und all bedeutet den gesamten Pool. metrics gibt eine CSV-Zeile pro Detektor und k aus mit F1, Recall bei Zero-Day-Angriffen (novel im Code) und pro Kategorie, PR-AUC und ROC-AUC von p_attack, Tokens, Latenz und Kosten. compare paart zwei Läufe Fluss für Fluss und führt McNemars Test auf den diskordanten Paaren durch, denn nur die Flüsse, bei denen zwei Detektoren uneinig sind, unterscheiden sie. Die Kosten werden offline als Tokens mal die Listenpreise in prices.json berechnet, für jeden Detektor gleichermaßen.

