
Skip to content
KitploitKITPLOIT
ToolsExploitsBlog
Log in
Einreichen
ToolsExploitsBlog
Einreichen

Hacking-, PenTest- und Cybersicherheits-Tools für Ihr Sicherheitsarsenal!

Kitploit ist ein Verzeichnis von Hacking-, Cybersicherheits- und Pentesting-Tools. Entdecken Sie die neuesten Projekt-Updates, um Schwachstellen zu finden, Systeme zu analysieren, Tests zu automatisieren und Ihre Sicherheit zu stärken.

FeedsKontaktDatenschutz© 2026 Kitploit

Tool-Verzeichnis

Kategorien

Alle Kategorien anzeigen
Loading categories
ColonelClustered — Ein Java-Burp-Plugin, das Text-Clustering auf Antworten durchführt, um Ausreißer/Gruppen basierend auf dem tatsächlichen Inhalt der Server-Antworten zu identifizieren, beispielsweise aus einem Intruder-Lauf. | Kitploit
Tools/GitHubGitHub/hoodoer/colonelclustered
SchwachstellenanalyseWeb-Proxys & AbfangenWebanwendungs-ExploitationWebsicherheitFuzzingPenetrationstestsDienstprogramme & FrameworksMaschinelles Lernen
GitHubhoodoer/colonelclustered

ColonelClustered

Ein Java-Burp-Plugin, das Text-Clustering auf Antworten durchführt, um Ausreißer/Gruppen basierend auf dem tatsächlichen Inhalt der Server-Antworten zu identifizieren, beispielsweise aus einem Intruder-Lauf.

121vor 16 TagenNoch nicht geprüft
Repository anzeigen

Beliebteste

Alle anzeigen →

Entdecken Sie die meistgenutzten Tools unserer Community.

Alle Tools erkunden

Durchsuchen Sie unsere Tool-Sammlung

Alle Tools anzeigen →
Teilen

Colonel Clustered - Response Similarity Clustering (v1.0.1)

Eine Burp Suite-Erweiterung zum Clustern von HTTP-Antworten, um Ausreißer zu finden.

Einführung

Dies ist ein Plugin, über dessen Entwicklung ich schon viele Jahre nachgedacht habe, einfach weil ich mäßig genervt davon bin, wie wir die Ergebnisse von Fuzzing-Angriffen im Burp Intruder analysieren. Wir suchen bei unseren Fuzzing-Angriffen typischerweise nach Änderungen in den Serverantworten. Und wir suchen nach diesen Unterschieden, indem wir Statuscodes, Antwortzeit und Antwortgröße betrachten. All dies sind indirekte Maße für den Inhalt der Antwort. Natürlich haben wir als Pentester keine Zeit, den Inhalt von Tausenden von Serverantworten zu lesen, um nach Unterschieden im Antwortinhalt zu suchen. Aber sicherlich können wir Algorithmen das für uns erledigen lassen.

Hier kommt dieses Plugin ins Spiel. Es verwendet Textclustering-Techniken, um den Inhalt der Antworten zu analysieren und sie basierend auf ihrer Ähnlichkeit in Cluster einzuteilen. Es bietet Ihnen eine weitere Möglichkeit, die Ergebnisse Ihrer Intruder-Fuzzing-Angriffe zu betrachten und schnell diejenigen Serverantworten zu identifizieren, die sich unterscheiden.

Funktionsweise

Colonel Clustered bietet zwei verschiedene Algorithmen zur Durchführung des Antwort-Clusterings. Der Standardalgorithmus ist relativ schnell, mit einem optionalen tiefergehenden Analysealgorithmus, der sich hervorragend zum Erkennen von Ausreißern eignet, aber nicht gut skaliert. Nun, keiner von beiden skaliert gut, ich würde zögern, 50k Antworten auf dieses Plugin zu werfen. Der schnellere/Standardalgorithmus hat eine Komplexität von O(n^2), während der Deep-Analysis-Algorithmus O(n^3) ist. Behalten Sie das im Hinterkopf, wenn Sie Intruder-Ergebnisse zur Verarbeitung an es senden.

  1. Inhaltsbewusste Tokenisierung: Die Erweiterung inspiziert zunächst den Content-Type-Header jeder Antwort, um die intelligenteste Tokenisierungsstrategie anzuwenden:

    • HTML: Entfernt alle Tags und Skripte und generiert dann zeichenbasierte 5-Gramme auf dem sichtbaren Text. Dies beinhaltet die Bereinigung von Ziffern, um Widerstandsfähigkeit gegenüber geringfügigen Variationen (wie IDs) in templatisierten Inhalten zu gewährleisten.
    • JSON: Extrahiert alle Schlüssel und ihre verschachtelten Pfade als Token und ignoriert Werte. Bei Arrays wird die Struktur aller enthaltenen Objekte analysiert.
    • Text: Generiert zeichenbasierte 5-Gramme auf Klartextinhalt, wobei ebenfalls Ziffern für Template-Widerstandsfähigkeit bereinigt werden.
    • Binär/Sonstiges: Wenn der Inhalt nicht textbasiert ist, generiert es eine Menge von 5-Byte-n-Grammen, um Ähnlichkeiten in den Binärdaten zu finden.
  2. Vor-Gruppierung: Um auch bei Tausenden von Antworten schnell zu bleiben, führt die Erweiterung einen einzigen Durchlauf durch, um alle perfekt identischen Antworten zu gruppieren. Sie berechnet einen Hash des Token-Sets jeder Antwort und gruppiert alle Elemente, die denselben Hash teilen. Das bedeutet, dass der teure Clustering-Algorithmus nur auf der viel kleineren Menge eindeutiger Antwortkörper ausgeführt werden muss.

  3. Duale Clustering-Algorithmen: Colonel Clustered bietet zwei verschiedene Clustering-Algorithmen:

    • Fast Scan (Standard): Ein hochperformanter DBSCAN-basierter Algorithmus läuft automatisch, wenn Sie mehrere Anfragen/Antworten an die Erweiterung senden.

      • Automatische Epsilon-Abstimmung: Es verwendet den Kneedle-Algorithmus, um automatisch das optimale Epsilon (Dichtheitsradius) zu bestimmen und sich an die Eigenschaften des Datensatzes anzupassen.
      • Ausreißererkennung (minPts=2): minPts ist auf 2 festgelegt, was es hocheffektiv für die Identifizierung von Antworten macht, die einzigartig sind oder Ähnlichkeit mit nur einem anderen Element teilen, wodurch eine sensible Ausreißererkennung gewährleistet wird.
    • Deep Analysis (Manueller Auslöser): Der ursprüngliche, rechenintensivere hierarchische Clustering-Algorithmus ist über eine Schaltfläche "Deep Analysis" verfügbar. Diese Option ist für Szenarien konzipiert, die eine granularere und potenziell andere Clustering-Perspektive erfordern, und verwendet Average Linkage für verbesserte Cluster-Kohäsion.

      • Es konstruiert eine Ähnlichkeitsmatrix unter Verwendung der Jaccard-Distanz zwischen eindeutigen Antworten.
      • Es führt iterativ die ähnlichsten Cluster zusammen und zeichnet die Zusammenführungsdistanzen auf, um optimale Schwellenwerte zu bestimmen.
  4. Ausreißer-Konsolidierung: Nach dem Clustering wird jede resultierende Gruppe, die nur ein einzelnes eindeutiges Mitglied enthält, als Ausreißer betrachtet. Alle diese Ausreißer werden dann in der UI in einer einzigen, praktischen "Outliers"-Gruppe zusammengefasst.

Diese beiden Algorithmen sollten eine einfache Möglichkeit bieten, Serverantworten automatisch zu identifizieren, die sich im Inhalt unterscheiden, selbst wenn die Antwortgröße ein unzuverlässiges Maß für Antwortunterschiede ist.

Verwendung

  1. Laden der Erweiterung:

    • Gehen Sie zum Tab Extensions in Burp Suite.
    • Klicken Sie auf Add und wählen Sie die Datei ColonelClustered.jar aus.
    • Ein neuer Tab namens "Col. Clustered" sollte erscheinen.
    • Hinweis: Hoffentlich kann ich das bald in den BAPP-Store bringen, ich werde die README aktualisieren, falls es akzeptiert wird.
  2. Senden von Antworten zur Analyse:

    • Gehen Sie zu einem beliebigen Tool in Burp, wie z. B. Intruder-Ergebnisse oder Proxy-Verlauf.
    • Wählen Sie ein oder mehrere Anfrage/Antwort-Elemente aus.
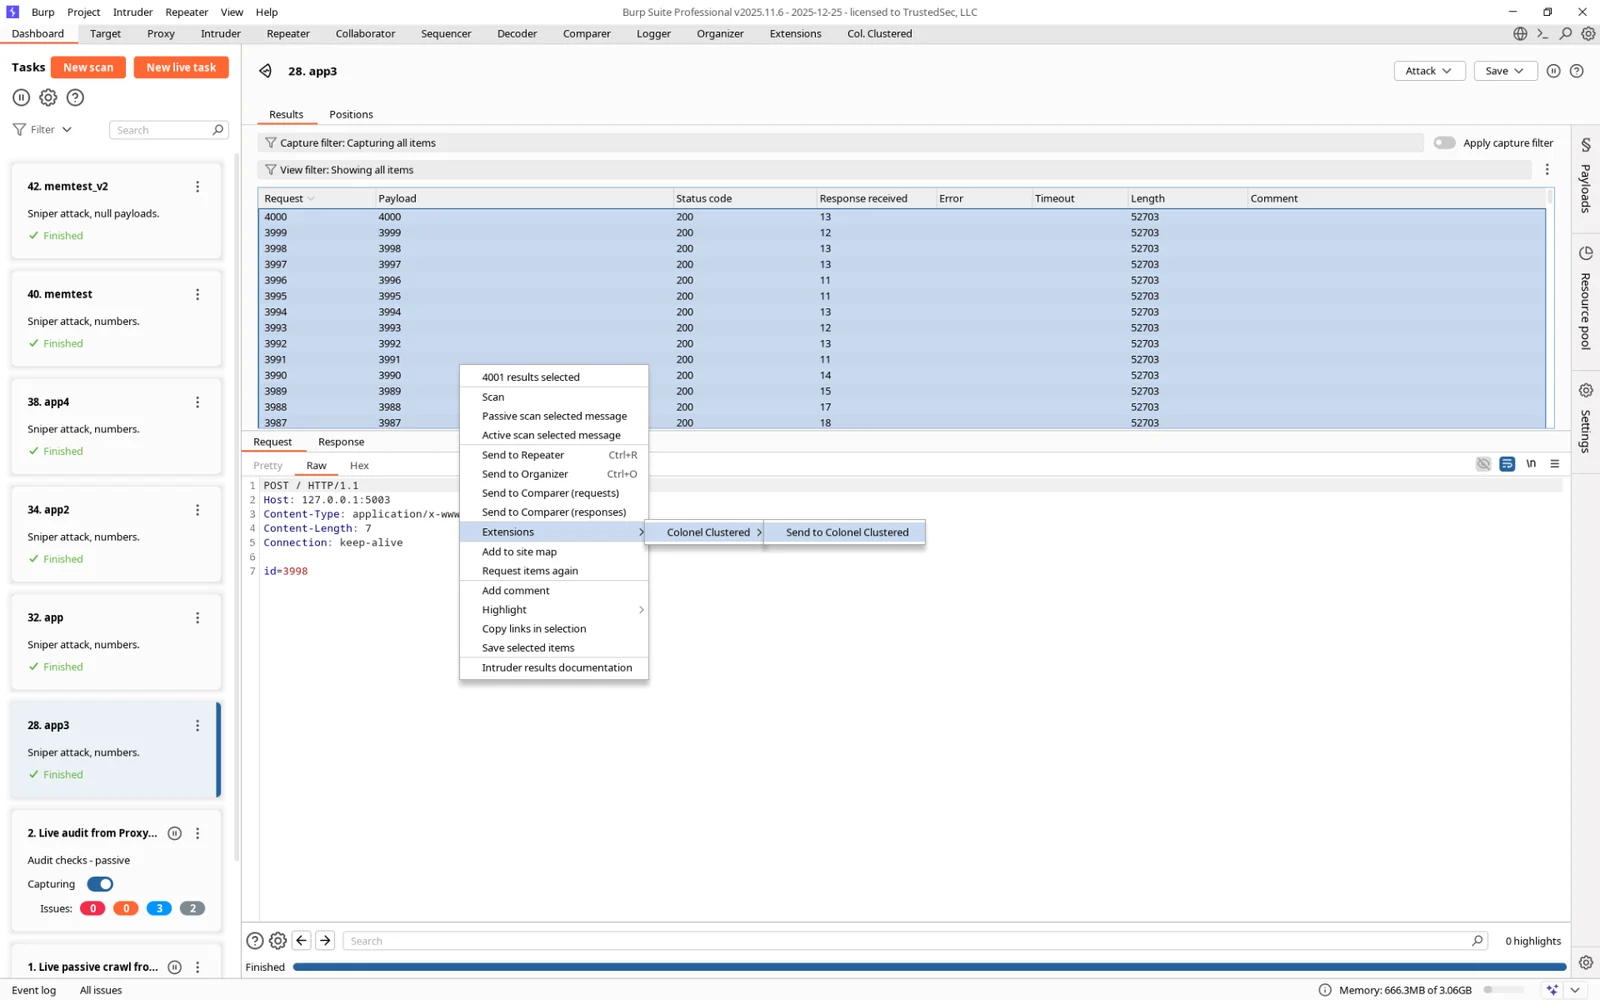
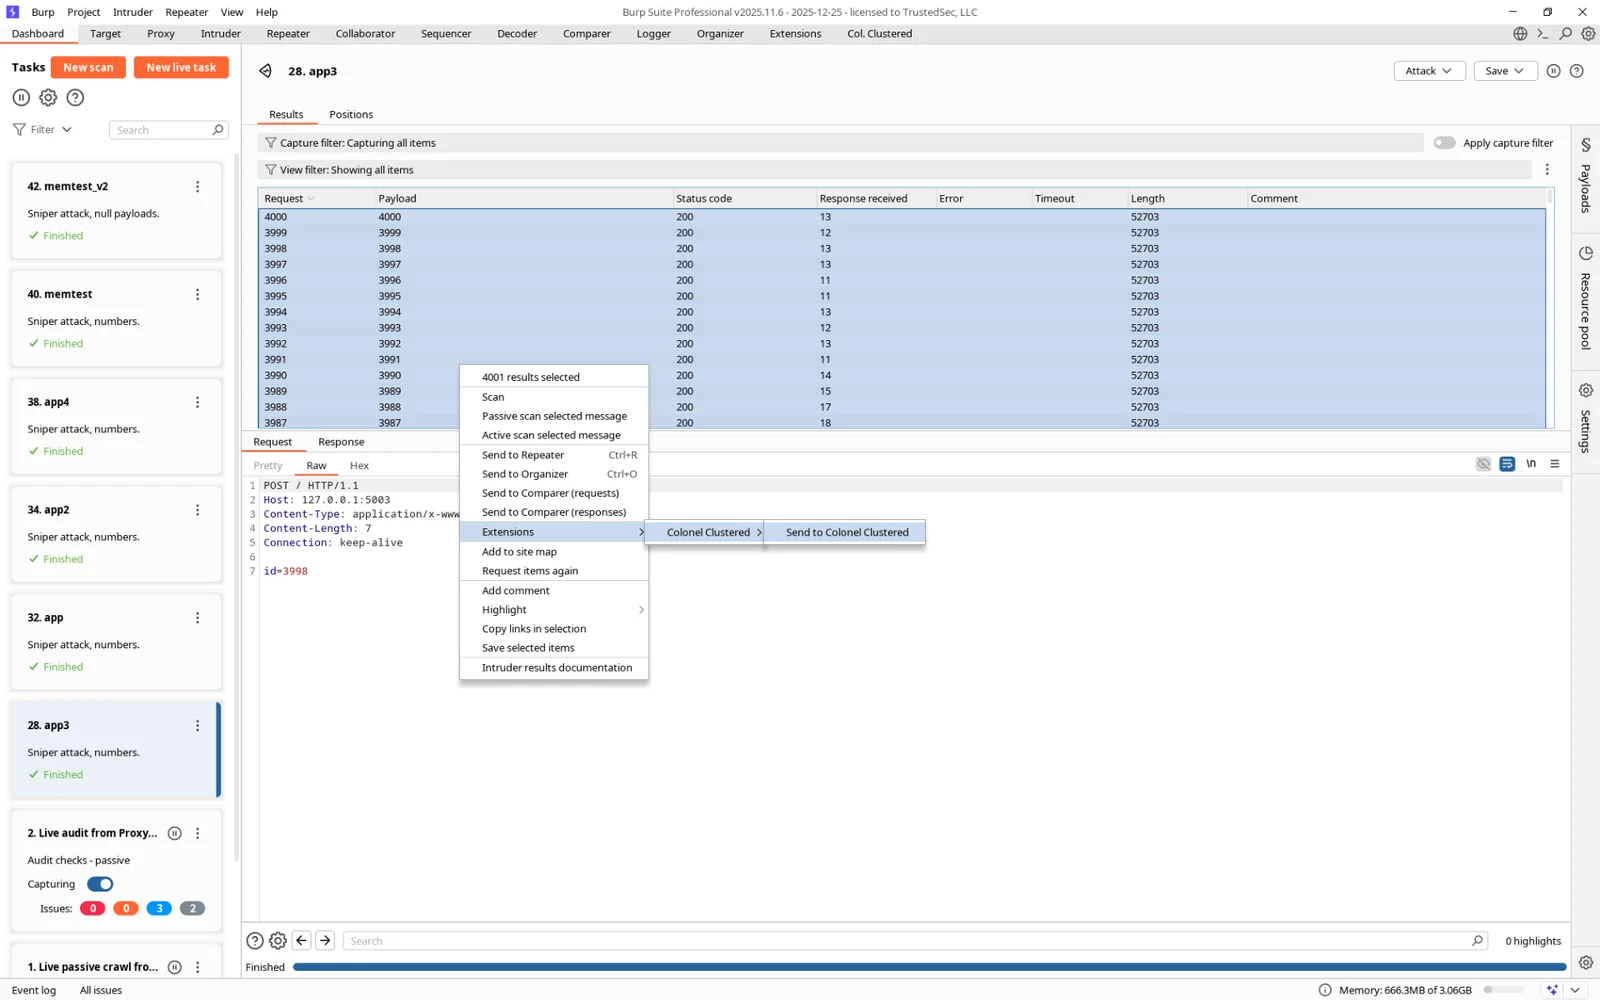
    • Klicken Sie mit der rechten Maustaste und wählen Sie "Send to Colonel Clustered".
    • Ein standardmäßiger Fast Scan beginnt automatisch, und ein Fortschrittsbalken erscheint, um die Analyse zu überwachen.
  3. Durchführen einer Deep Analysis (Optional):

    • Wenn ein detaillierteres, hierarchisches Clustering gewünscht wird, klicken Sie auf die Schaltfläche "Deep Analysis".
    • Hinweis: Wenn Sie eine große Anzahl von Elementen analysieren, erscheint eine Warnung über mögliche Leistungsprobleme, bevor der Scan beginnt.
    • Ein Fortschrittsbalken erscheint, mit dem Sie die Analyse überwachen können.
  4. Analysieren der Ergebnisse in der Quad-Pane-UI:

    • Der Tab "Colonel Clustered" verwendet ein Vier-Bereiche-Layout, um Ihnen die schnelle Navigation durch die Ergebnisse zu erleichtern.
    • Oben links (Cluster): Dieser Bereich zeigt die gefundenen Cluster an, einschließlich einer speziellen "Outliers"-Gruppe. Jeder Eintrag zeigt die Anzahl der Elemente in diesem Cluster.
    • Unten links (Cluster-Mitglieder): Wählen Sie einen Cluster im Bereich darüber aus, um alle seine Mitglieder in dieser Tabelle angezeigt zu bekommen. Die Tabelle enthält mehrere Spalten:
      • Request/Response Pair: Der ursprüngliche Index des Elements.
      • Status Code: Der HTTP-Antwortstatuscode.
      • Length: Die Länge des Antwortkörpers in Bytes.
      • Content-Type: Der Content-Type-Header der Antwort.
    • Sortierung: Klicken Sie auf einen beliebigen Spaltenkopf in der Tabelle, um die Elemente innerhalb dieses Clusters zu sortieren, sodass Sie leicht die größten/kleinsten Antworten finden oder nach Statuscode gruppieren können.
    • Oben rechts & unten rechts (Viewer): Wählen Sie eine beliebige Zeile in der Tabelle aus, um deren vollständige Anfrage und Antwort in den Viewern auf der rechten Seite anzuzeigen.

Screenshots

image
Tool herunterladen