 foxirain/linux-kernel-codex-harness
Evidenzbasierte Forschungsumgebung für Schwachstellen im Linux-Kernel, die bei der Untersuchung von CVE-2026-31720 eingesetzt wird.


Forschungswerkzeug · Ursprünglicher Import: 3. April 2026 · Dokumentationsrevision: 11. Juli 2026
Kernphilosophie — Externes Signal
Reproduzierbare Beobachtungen außerhalb der Modellinferenz sollen die Aufmerksamkeit lenken; Priorität niemals mit Beweis verwechseln.
Projektstatus. Dieses Repository ist eine frühe Version eines LLM-gestützten Research-Harness, der für die Untersuchung realer Linux-Kernel-Schwachstellen entwickelt und verwendet wurde. Diese Version wurde verwendet, um die als CVE-2026-31720 veröffentlichte Schwachstelle zu finden. Der Harness priorisiert Untersuchungsziele, beweist jedoch keine Schwachstellen automatisch und garantiert keine Kernel-Sicherheit; die endgültige Validierung und Berichterstattung erfolgt durch Menschen.
Abstract— Wenn man LLMs eine Codebasis von der Größe des Linux-Kernels direkt durchsuchen lässt, zerstreut sich der Kontext schnell, und die Existenz riskanter APIs wird leicht mit tatsächlicher Ausnutzbarkeit verwechselt. Kernel Codex Harness definiert dieses Problem nicht als automatische Schwachstellenerkennung, sondern als Untersuchungspriorisierung und zustandsbasierte Orchestrierung. Dieses Projekt nennt das Prinzip, die Aufmerksamkeit des Modells durch reproduzierbare Beobachtungen zu steuern, die außerhalb der LLM-Inferenz berechnet werden, External Signal. Kernel-Pfade, Userspace-Grenzen, statische Signale für Lifetime, Usercopy, Refcount und Größe sowie optionale syzbot-Crash-Intelligence werden kombiniert, um Kandidatendateien zu ranken, und jeder Kandidat wird in ein schmales Prompt-Bündel umgewandelt. Manuelle Überprüfung und zeitbudgetierter Autopilot verwenden denselben Antwortvertrag und denselben Sitzungszustand. Dieser Harness wurde in einer realen Linux-Kernel-Untersuchung verwendet, um einen Stack-Out-of-Bounds-Write im USB-Gadget-Audio-Pfad zu finden; dieser Fehler wurde als CVE-2026-31720 veröffentlicht. Diese Implementierung ist kein präziser statischer Analysator, sondern ein Research-Workflow, der den LLM-Untersuchungsbereich durch erklärbare Heuristiken eingrenzt; alle Findings erfordern eine menschliche Revalidierung von Erreichbarkeit, Invariantenbruch und konkreter Auswirkung.
Index Terms— Linux-Kernel, Schwachstellenforschung, externes Signal, LLM-Orchestrierung, heuristische Priorisierung, syzbot, Programmanalyse, Codex.
Die Sicherheitsprüfung des Linux-Kernels hat zwei Arten von Skalierungsproblemen. Erstens ist der gesamte Quellbaum zu groß für einen einzigen LLM-Kontext. Zweitens sind Signale wie copy_from_user, Allokatoren, Refcounts und Locks häufig, bedeuten aber für sich genommen keine Schwachstelle. Der Analyst muss zuerst entscheiden, „wo gesucht werden soll“, und dann Userspace-Erreichbarkeit und konkrete Zustandsübergänge separat beweisen.
Die Kernphilosophie dieses Projekts ist External Signal.
Das LLM entscheidet nicht selbst, wo es hinsieht. Reproduzierbare Signale außerhalb der Modellinferenz verteilen die Aufmerksamkeit, aber Schwachstellenschlussfolgerungen werden nur durch Erreichbarkeits- und Invariantenevidenz bestimmt.
Daher lässt der Harness das Modell nicht vage den gesamten Kernel durchsuchen. Er priorisiert Dateien, bietet jeweils nur einen Untersuchungszweig an und verlangt zuerst Beweisstrukturen statt Schlussfolgerungen.
External Signal ist kein vom LLM generiertes Urteil, sondern eine Beobachtung, die vor der Modellausführung bestimmt und aus demselben Quellbaum, Profil und gespeicherten syzbot-JSON neu berechnet werden kann. Pfadgewichte, Regex-Treffer und gecachte syzbot-Überlappungen fallen darunter. Diese Signale werden nur für Kandidatenranking und Prompt-Kontext verwendet und nicht zu Urteilen oder Beweisen erhoben.
External Signal in diesem Dokument bezieht sich auf die gesamte Projektphilosophie. Das ExternalSignal-Datenmodell im Code repräsentiert derzeit nur die daraus abgeleiteten syzbot-Signale, daher unterscheidet sich der Umfang der beiden Begriffe.
Regex-Treffer, Hochrisikopfade und syzbot-Überlappungen sind allesamt Signale für die Untersuchungsreihenfolge. Eine hohe Punktzahl ist kein Sicherheitsfinding, wenn der tatsächliche Aufrufpfad, Berechtigungen, Kernel-Konfiguration, Namespace oder die Geräteverfügbarkeit dem Angreifer keinen Zugriff ermöglichen.
Die Prüfung identifiziert zuerst Grenzen, die vom Userspace ausgehen, wie syscall, ioctl, netlink, procfs, Dateisysteme, BPF und Driver-Hooks. Erst danach werden Bug-Klassen wie UAF, OOB, Refcount, Race, Info-Leak und Capability-Checks bewertet.
Eine Untersuchungseinheit ist standardmäßig auf eine Datei und nahe Caller-, Teardown- und Free-Pfade beschränkt. Vom Modell empfohlene manuelle Folgeuntersuchungen sind auf maximal zwei beschränkt. Diese Einschränkung soll nicht die Explorationsfähigkeit verringern, sondern Schlussfolgerungen innerhalb eines verifizierbaren Rahmens halten.
Die Prompts verlangen, dass ein starkes Finding mindestens die folgenden Punkte erklärt:
Fehlt die Begründung, gibt das Modell statt einer starken Schwachstellenbehauptung ein einzelnes nächstes Ziel zur Überprüfung zurück. Dies ist ein Prompt-Level-Evidenzvertrag; der aktuelle Parser validiert die Vollständigkeit jeder Evidenz nicht automatisch. Da die Ingestion Urteile und nächste Ziele normalisiert, liegt die endgültige Evidenzvalidierung in der Verantwortung des Menschen.
Der anfängliche Untersuchungsfluss geht auf die dateibasierte Analyse, die begrenzte Kontexterweiterung und die strukturierten Ergebnisse von Protect AIs vulnhuntr zurück [1]. Dieses Projekt überträgt diese Ideen nicht direkt auf die Analyse von Python-Anwendungen, sondern gestaltet sie neu rund um die userspace-erreichbare Kernel-Oberfläche, Kernel-Objekt-Lifetimes, Teardown-Pfade und syzbot-Überlappungen. Insbesondere die Trennung von Prioritätssignalen und Schwachstellenbeweis sowie die Prüfung der Erreichbarkeit vor der Bug-Klasse sind zentrale Designentscheidungen des Kernel-Harness.
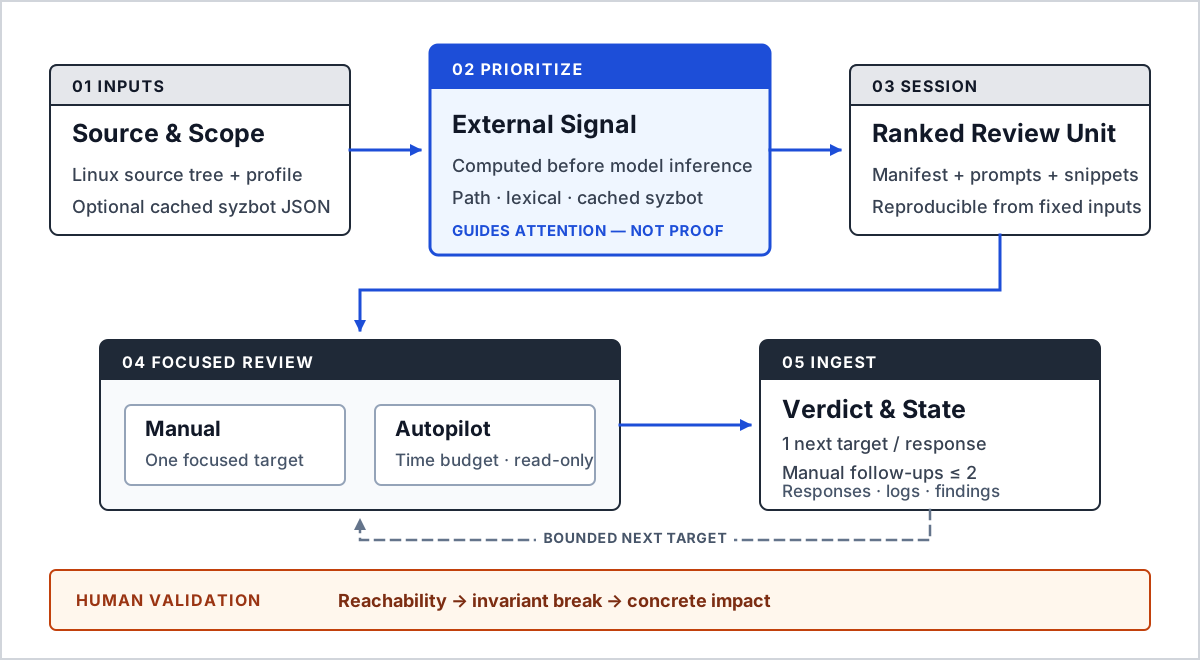
Abb. 1. Die External-Signal-Schicht wandelt vor der Modellinferenz berechnete Beobachtungen in gerankte Überprüfungseinheiten um. Sie verteilt Aufmerksamkeit, begründet aber keinen Schwachstellenbeweis.
TABELLE I — VERANTWORTLICHKEITEN DER HAUPTMODULE
