 comerc/cve-2025-68664
Detaillierte Offenlegung von CVE-2025-68664, einer kritischen Deserialisierungsschwachstelle im LangChain-Kern, die das Exfiltrieren von Geheimnissen und potenzielle RCE durch präparierte Prompts und Serialisierungsabläufe ermöglicht.

Autor: Yarden Porat
Cyata-Forschung: LangGrinch-Schwachstelle in LangChain
Veröffentlicht: https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
Gestern hat LangChain eine kritische Warnung zu einer Schwachstelle veröffentlicht, die ich in langchain-core entdeckt habe: CVE-2025-68664 / GHSA-c67j-w6g6-q2cm.
Anfang dieses Jahres konzentrierte sich meine Forschung auf das Knacken von Secret-Managern in unserer Arbeit „Vault Fault“ – Systeme, die speziell als Sicherheitsgrenze um Ihre sensibelsten Anmeldedaten konzipiert sind. Eine Erkenntnis wiederholte sich immer wieder: Wenn eine Plattform von einem Angreifer kontrollierte Daten als vertrauenswürdige Struktur behandelt, bricht diese Grenze schnell zusammen. Dieses Mal ist das System, das „bricht“, nicht Ihr Secret-Manager. Es ist das Agenten-Framework, das sie nutzen kann.
Warum diese Schwachstelle besondere Aufmerksamkeit verdient:
Sie liegt im Kern. Das ist kein Fehler eines bestimmten Tools, kein Randfall einer Integration und kein „irgendein Community-Paket hat etwas Seltsames gemacht.“ Die anfälligen APIs (dumps() / dumpd()) befinden sich im langchain-core selbst.
Der Radius ist enorm. Gemessen an den Downloads ist LangChain eine der am weitesten verbreiteten KI-Framework-Komponenten weltweit. Stand Ende Dezember 2025 zeigen öffentliche Pakettelemetrien Hunderte Millionen Installationen, wobei pepy.tech ~847 Mio. Gesamtdownloads und pypistats ~98 Mio. Downloads im letzten Monat meldet.
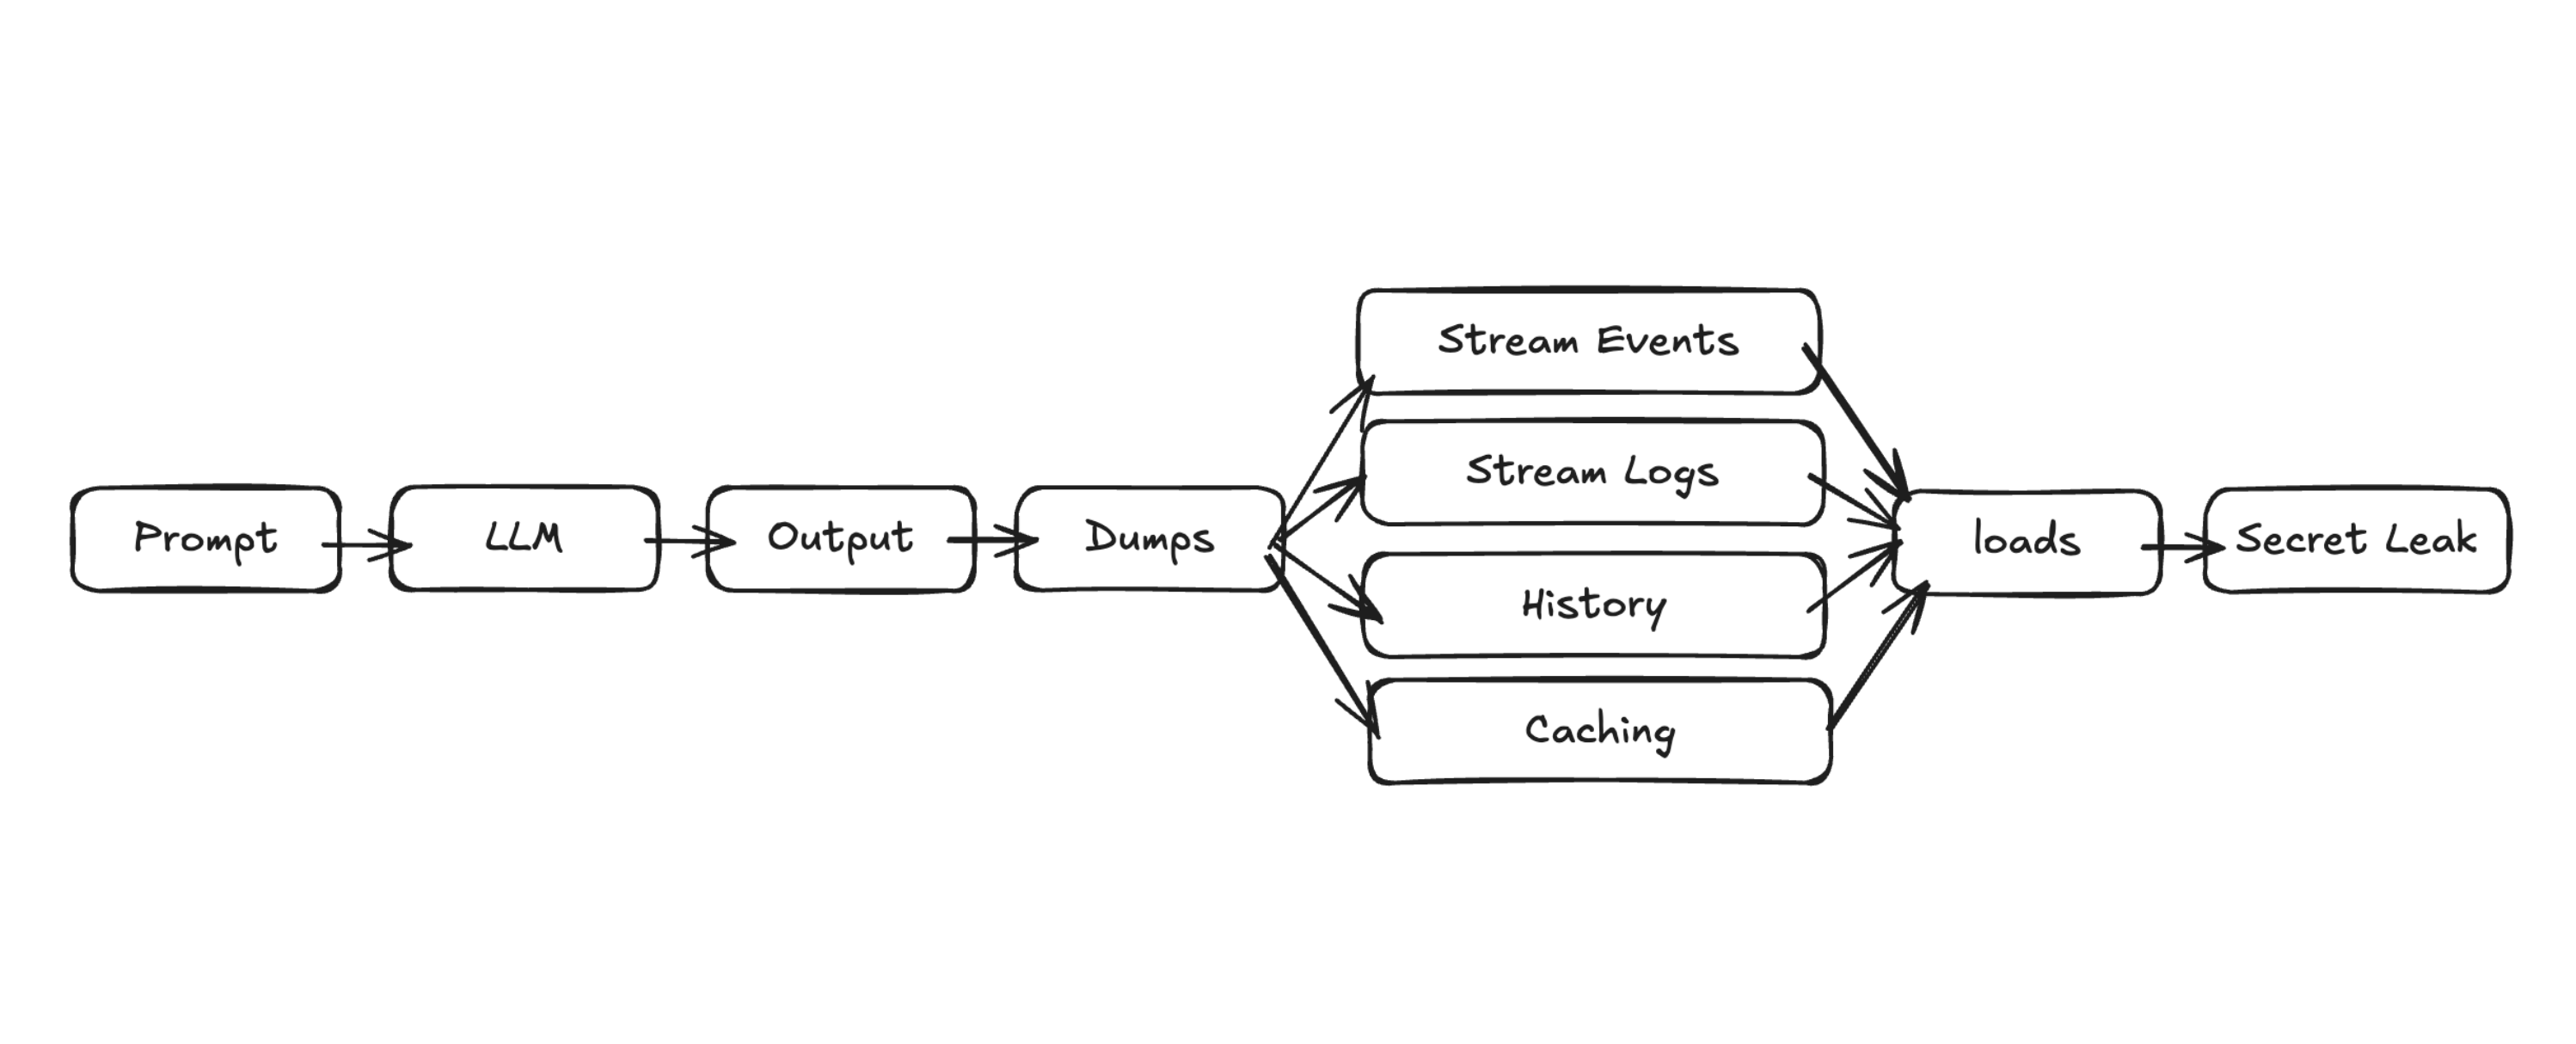
Ein Prompt kann viele Mechanismen auslösen. Der häufigste reale Pfad ist hier nicht „der Angreifer schickt einen serialisierten Blob und Sie rufen load() auf.“ Es ist subtiler: LLM-Ausgaben können Felder wie additional_kwargs oder response_metadata beeinflussen, und diese Felder können serialisiert und später über normale Framework-Funktionen wie Streaming-Logs/Ereignisse deserialisiert werden. Einfach ausgedrückt bedeutet das, dass ein Exploit durch einen einzigen Text-Prompt ausgelöst werden kann, der zu einem unerwartet komplexen internen Pipeline wird.
Bevor Sie weiterlesen: Patches wurden bereits in den Versionen 1.2.5 und 0.3.81 veröffentlicht. Wenn Sie LangChain in der Produktion einsetzen, ist dies komplizierter als es scheint; bitte aktualisieren Sie so schnell wie möglich.
LangChain verwendet ein spezielles internes Serialisierungsformat, bei dem Wörterbücher, die den Marker 'lc' enthalten, LangChain-Objekte darstellen. Die Schwachstelle bestand darin, dass dumps() und dumpd() benutzerkontrollierte Wörterbücher, die versehentlich den reservierten Schlüssel 'lc' enthielten, nicht korrekt maskierten.
Sobald ein Angreifer also den Orchestrierungszyklus von LangChain dazu bringen kann, Inhalte einschließlich des Schlüssels 'lc' zu serialisieren und später zu deserialisieren, kann er ein unsicheres beliebiges Objekt instanziieren und möglicherweise viele angreiferfreundliche Pfade auslösen.
Die Warnung listet 12 verschiedene anfällige Abläufe auf, die in realen Anwendungsfällen wie Standard-Streaming-Ereignissen, Logging, Nachrichtenverlauf/Speicher oder Caching extrem häufig sind:
Die verheerendsten Auswirkungen umfassen:
Extraktion von Geheimnissen aus Umgebungsvariablen. Die Warnung stellt fest, dass dies bei der Deserialisierung mit secrets_from_env=True geschieht. Bemerkenswert ist, dass dies bis gestern standardmäßig aktiviert war. 🙂
Instanziierung von Objekten in vorab genehmigten Namensräumen (einschließlich langchain_core, _langchain_openai, langchain_aws, langchain_anthropic…), was möglicherweise Nebenwirkungen in Konstruktoren auslöst (Netzwerkaufrufe, Dateioperationen usw.).
Unter bestimmten Bedingungen kann die Instanziierung von LangChain-Objekten zu beliebiger Codeausführung führen.
Dies ist klassifiziert unter CWE-502: Deserialisierung nicht vertrauenswürdiger Daten, mit einem CVSS CNA-Score von 9.3 (Kritisch).
Am Heiligabend hatte ich die am wenigsten weihnachtliche Arbeit: Ich sah mir den Serialisierungscode an und fragte „Moment… warum wird das als vertrauenswürdig betrachtet?“
Sicherheitsforschung sieht von außen oft dramatisch aus. In Wirklichkeit ist es meist sorgfältiges Lesen, kleine Hypothesen und das langsame Ansammeln von „das ist seltsam“-Momenten.
Es begann, wie so vieles bei Cyata: mit einer einfachen Frage, die wir uns bei der Bewertung von KI-Stacks auf echtes Risiko immer stellen:
Wo liegen die Vertrauensgrenzen in KI-Anwendungen, und wissen die Entwickler wirklich, wo diese Grenzen liegen?
LangChain ist ein leistungsstarkes Framework, und wie die meisten modernen Frameworks muss es komplexe strukturierte Daten bewegen: Nachrichten, Tool-Aufrufe, Streaming-Ereignisse, Traces, Caches und „Runnables“.
Beim Durchsehen früherer Forschung gab es bereits umfangreiche Untersuchungen zu LangChain-Tools und Integrationen, aber sehr wenige Funde in der Kernbibliothek.
Ich begann die Forschung mit umgekehrter Vorgehensweise. Finde interessante Stellen (Senken), dann finde heraus, wie ein Angreifer sie erreichen kann. Deserialisierung war ein offensichtliches Ziel.
Ich brauchte ziemlich lange, um etwas Bedeutendes zu finden. Aber nach einiger Zeit fand ich, dass ich unter der Annahme einer angreiferkontrollierten Deserialisierungsprimitive einen blinden SSRF auslösen konnte, der zur Exfiltration von Umgebungsvariablen genutzt werden könnte (bald ausführlich beschrieben). Da das Ergebnis auf die Exfiltration von Geheimnissen beschränkt war und nicht mein Hauptziel RCE war, prüfte ich die Deserialisierung weiter und nahm mir Zeit.
Der Fehler war kein Stück schlechten Codes, es war fehlender Code. dumps() maskierte einfach keine benutzerkontrollierten Wörterbücher, die 'lc'-Schlüssel enthielten. Fehlende Maskierung im Serialisierungspfad, nicht in der Deserialisierung.
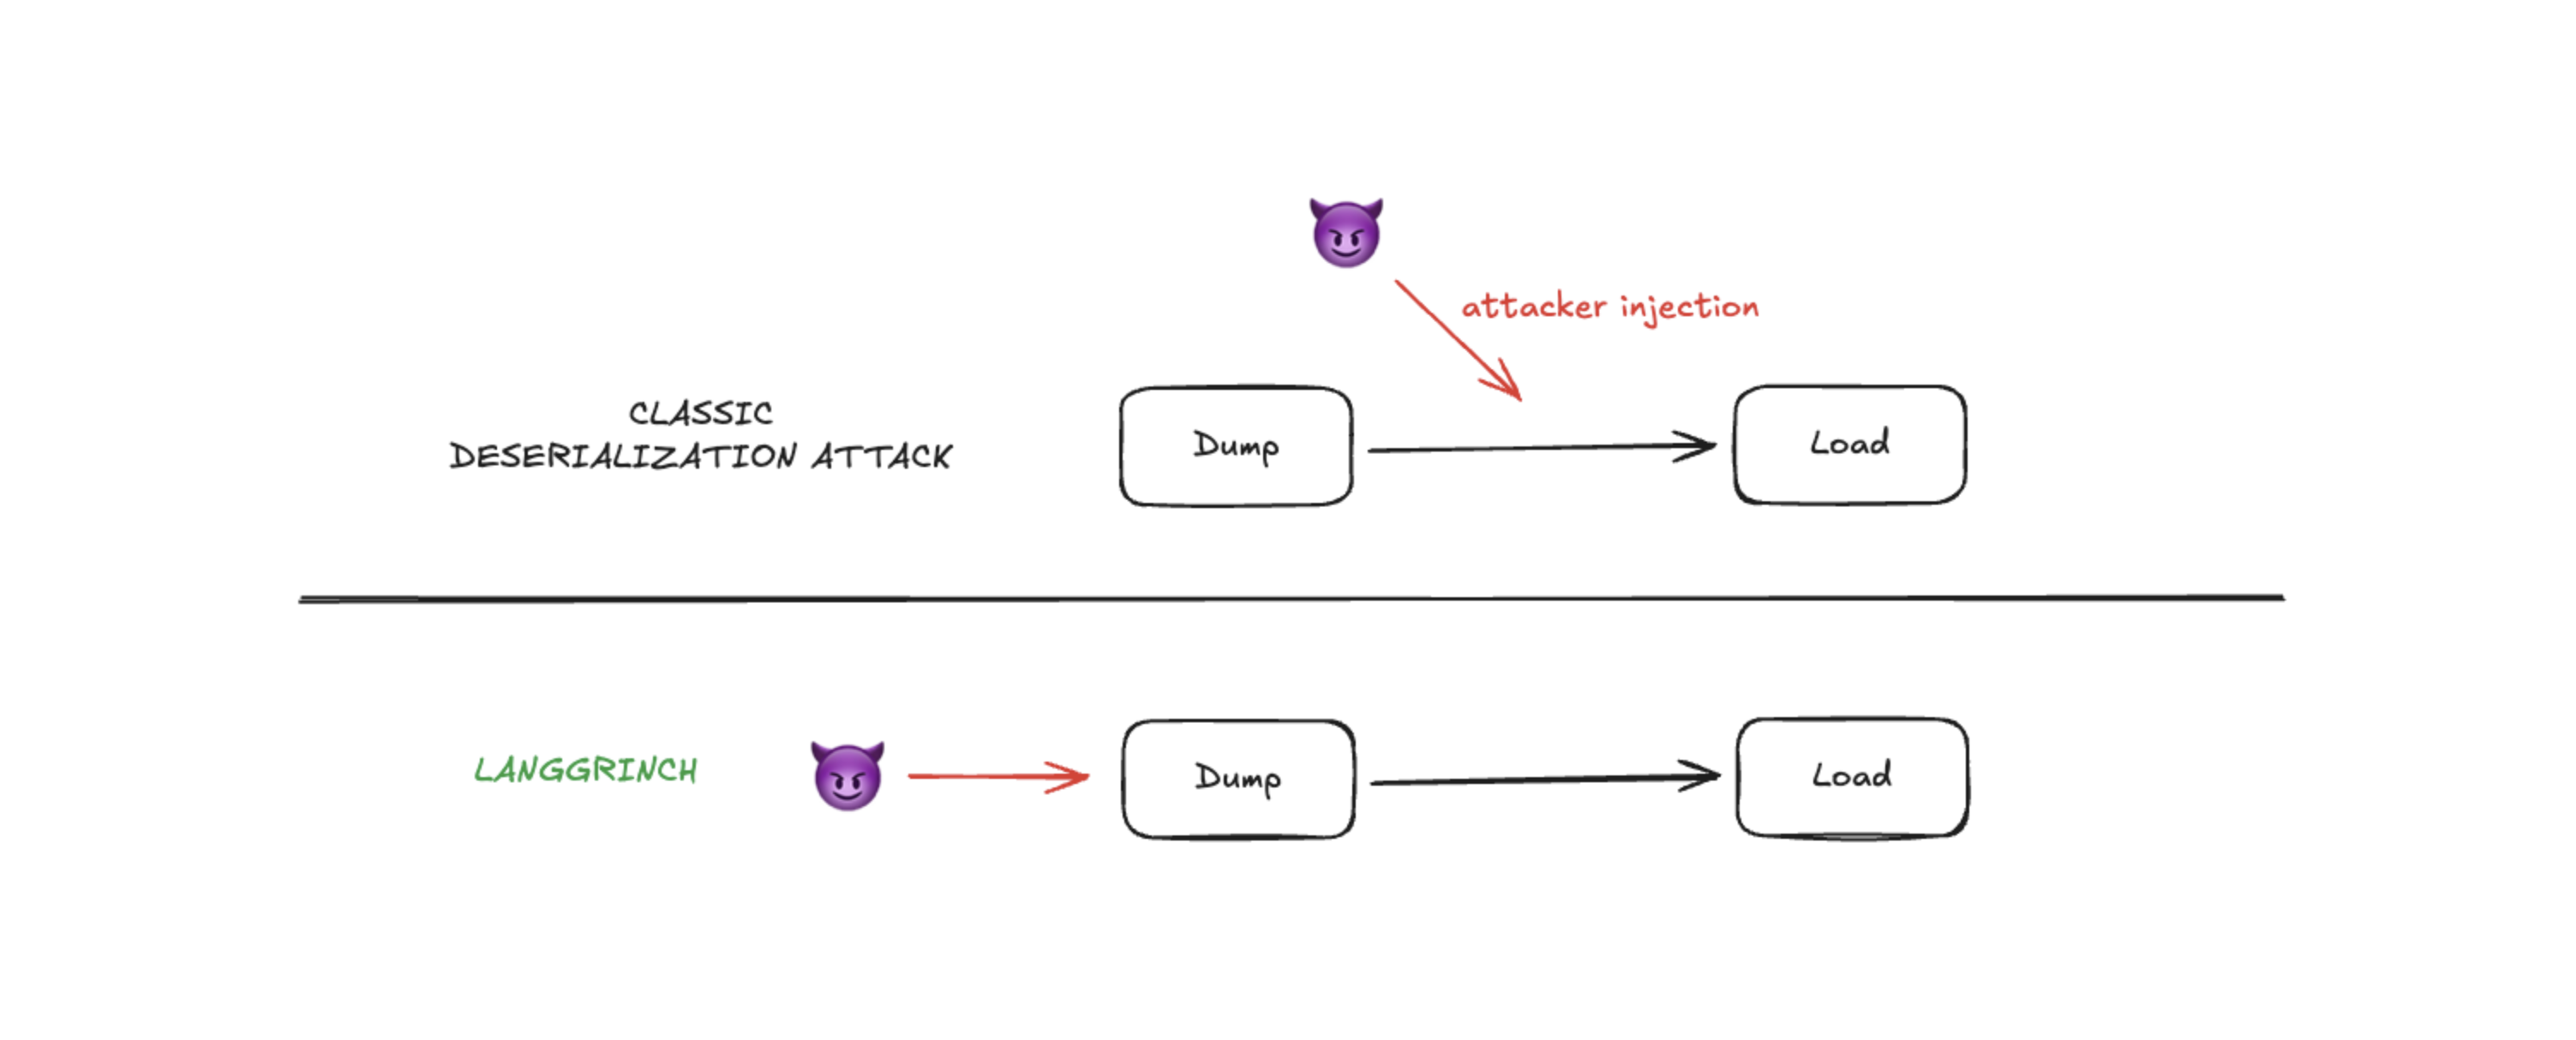
Es ist viel leichter, etwas Falsches zu bemerken, als das Fehlen von etwas zu bemerken, besonders wenn man load() prüft und nicht dumps(). In einem der am gründlichsten geprüften KI-Frameworks. Zweieinhalb Jahre.
Von dort aus wurde die Forschung zu einer strukturierten Übung:
Identifizieren, wo nicht vertrauenswürdiger Inhalt (hauptsächlich beliebige Wörterbücher) in die Serialisierung gelangt (LLM-Ausgaben, Prompt-Injection, Benutzereingabe, externe Tools, extrahierte Dokumente).
Identifizieren, wann diese serialisierten Daten deserialisiert werden.
Identifizieren, was ein Angreifer durch beliebige Objektinstanziierung erreichen kann.
Zu diesem Zeitpunkt war der Hauptfund klar und für einen verantwortungsvollen Bericht umsetzbar: Es gab eine Maskierungslücke in dumps() / dumpd() bei Wörterbüchern mit dem Schlüssel 'lc'.
Die Warnung erfasste später, was wir in der Praxis oft sehen: Felder wie additional_kwargs und response_metadata können durch LLM-Ausgabe und Prompt-Injection beeinflusst werden, und diese Felder können in vielen Abläufen serialisiert-deserialisiert werden.
Zur Ehre des LangChain-Teams: Die Reaktion und die Folgemaßnahmen waren entschlossen, nicht nur der Bug wurde gepatched, sondern auch die Standardeinstellungen wurden verschärft, die für die Welt, in der wir jetzt leben, zu permissiv waren.
