
Skip to content
KitploitKITPLOIT
ToolsExploitsBlog
Log in
Einreichen
ToolsExploitsBlog
Einreichen

Hacking-, PenTest- und Cybersicherheits-Tools für Ihr Sicherheitsarsenal!

Kitploit ist ein Verzeichnis von Hacking-, Cybersicherheits- und Pentesting-Tools. Entdecken Sie die neuesten Projekt-Updates, um Schwachstellen zu finden, Systeme zu analysieren, Tests zu automatisieren und Ihre Sicherheit zu stärken.

··Feeds·Kontakt·Datenschutz·© 2026 Kitploit

Tool-Verzeichnis

Kategorien

Alle Kategorien anzeigen
Loading categories
kong — Der weltweit erste agentische Reverse Engineer. | Kitploit
Tools/GitHubGitHub/amruth-sn/kong
Statische AnalyseDynamische Analyse (Sandboxing)SchwachstellenanalyseExploitationReverse EngineeringDebuggerMalware-AnalyseBinäranalyseLernen & BildungKI-gestütztes Reverse EngineeringFirmware-Analyse
1.1k12518vor 6 MonatenVon Kitploit geprüft
GitHub
amruth-sn/kong

kong

Der weltweit erste agentische Reverse Engineer.

Repository anzeigenWebseite

Beliebteste

Alle anzeigen →

Entdecken Sie die meistgenutzten Tools unserer Community.

Alle Tools erkunden

Durchsuchen Sie unsere Tool-Sammlung

Alle Tools anzeigen →
Teilen

Kong: Der agentische Reverse Engineer

PyPI - Version X (formerly Twitter) URL

Kong: Der weltweit erste KI-Reverse Engineer

LLM-Orchestrierung zum Reverse Engineering von Binärdateien

Was ist Kong?

Die meisten Aufgaben folgen einer linearen Beziehung: Je schwieriger eine Aufgabe, desto länger dauert sie normalerweise. Reverse Engineering (und Binäranalyse) ist eine Aufgabe, bei der die tatsächliche Schwierigkeit eher trivial ist, aber die Ausführungszeit in der Größenordnung von Stunden (und Tagen!) liegen kann, selbst für eine Binärdatei mit ein paar hundert Funktionen.

Kong automatisiert die mechanische Schicht unter Verwendung eines Reverse-Engineering-Frameworks auf NSA-Niveau. Kong kann eine vollständig obfuskatierte, gestrippte Binärdatei nehmen und eine vollständige Analyse-Pipeline durchführen: Funktionen triagieren, Call-Graph-Kontext aufbauen, Typen und Symbole durch LLM-gestützte Dekompilation wiederherstellen und die Ergebnisse zurück in Ghidras Programmdatenbank schreiben. Die Ausgabe ist eine Binärdatei, in der aus FUN_00401a30 nun parse_http_header wird, mit wiederhergestellten Strukturen, Parameternamen und Aufrufkonventionen.

Warum es das gibt

Gestrippte Binärdateien verlieren den gesamten Kontext, der Code lesbar macht: Funktionsnamen, Typinformationen, Variablennamen, Strukturlayouts. Die Wiederherstellung dieses Kontexts ist der Großteil der Arbeit bei den meisten RE-Aufgaben, und es ist größtenteils Mustererkennung: Erkennen von Standardbibliotheksfunktionen, Ableiten von Typen aus der Nutzung, Propagieren von Namen durch Call-Graphen.

LLMs sind genau für diese Art der Mustererkennung gut geeignet. Aber einen LLM auf rohe Dekompiler-Ausgabe zu richten und zu fragen "was macht das?" liefert mittelmäßige Ergebnisse. Dem Modell fehlt der Aufrufkontext, Kreuzreferenzinformationen und das größere Bild der Binärstruktur. Darüber hinaus führen die meisten obfuskierten Binärdateien extreme Techniken ein, um Reverse Engineering zu verhindern.

Kong löst dies, indem es reichhaltige Kontextfenster aus Ghidras Programm-Analyse (Call-Graphen, Kreuzreferenzen, String-Referenzen, Datenfluss) aufbaut, bevor der LLM überhaupt berührt wird, und dann die Analyse in Abhängigkeitsreihenfolge orchestriert, sodass jede Funktion davon profitiert, dass ihre Callees bereits benannt sind. Zusätzlich führt Kong seine eigene, erstmalige, agentische Deobfuskations-Pipeline ein.
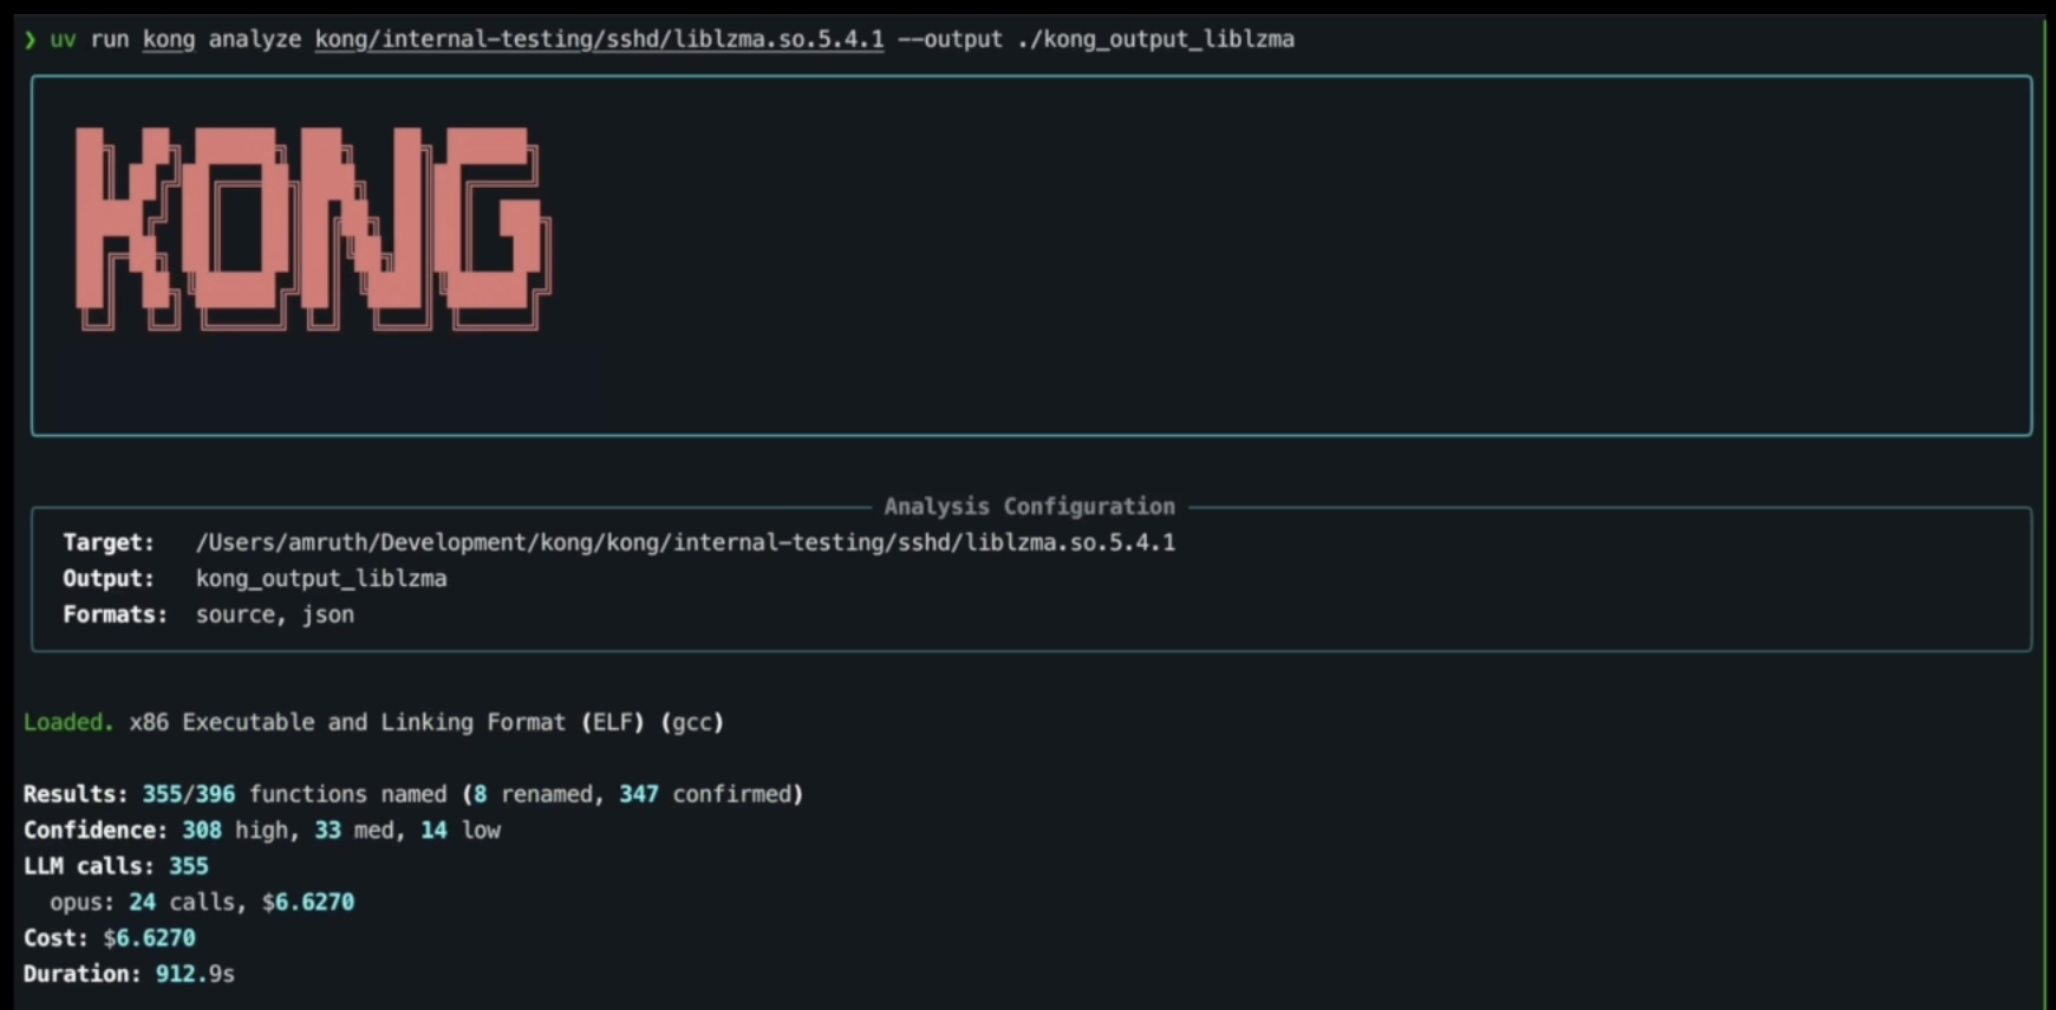
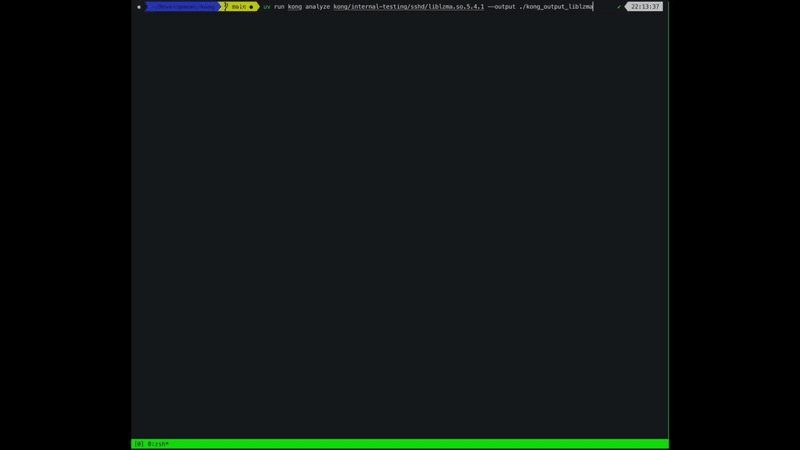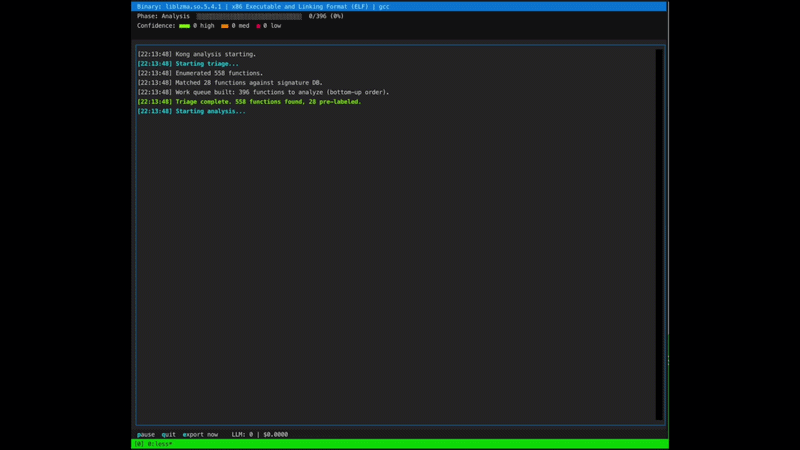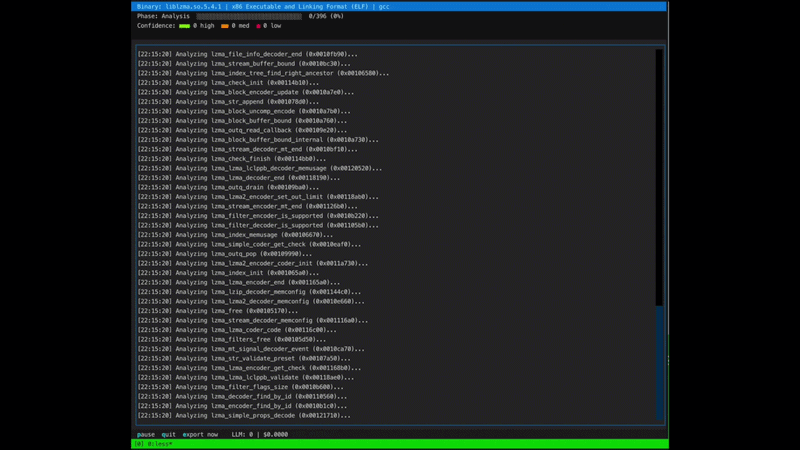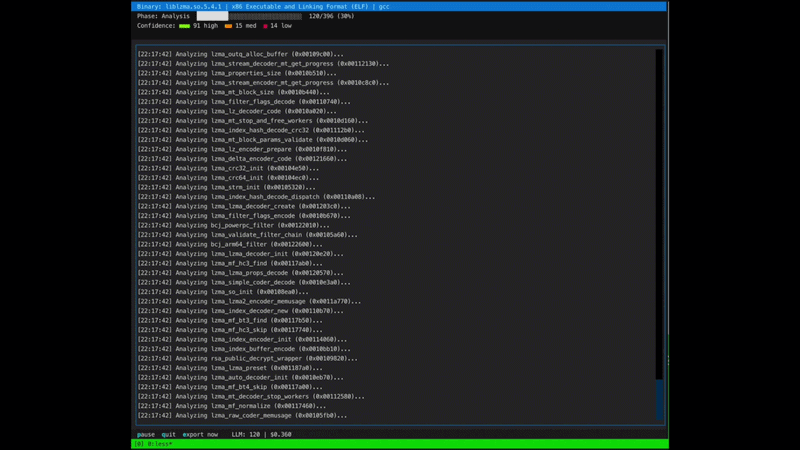
In Aktion

Kong: Der weltweit erste KI-Reverse Engineer Kong: Der weltweit erste KI-Reverse Engineer

Features

  • Vollautomatische Pipeline: Ein einziger Befehl führt die vollständige Analyse durch. Triage, Funktionsanalyse, Bereinigung, semantische Synthese und Export. Kein manueller Eingriff erforderlich.
  • In-Prozess-Ghidra-Integration: Führt Ghidras Analyse-Engine in-Prozess über PyGhidra und JPype aus. Kein Server, kein RPC, kein Subprozess-Overhead. Direkter Zugriff auf die Programmdatenbank.
  • Nach Call-Graph geordnete Analyse: Funktionen werden vom Call-Graph aus bottom-up analysiert. Blattfunktionen werden zuerst benannt, sodass Aufrufer vom bereits aufgelösten Kontext in ihrer Dekompilation profitieren.
  • Reichhaltige Kontextfenster: Jeder LLM-Prompt enthält die Dekompilation der Zielfunktion sowie Kreuzreferenzen, String-Referenzen, Aufrufer/Callee-Signaturen und benachbarte Daten; nicht nur rohe Dekompiler-Ausgabe in Isolation.
  • Semantische Synthese: Ein Post-Analyse-Durchlauf, der Namenskonventionen über die Binärdatei vereinheitlicht, Strukturdefinitionen aus Feldzugriffsmustern synthetisiert und Inkonsistenzen zwischen unabhängig analysierten Funktionen auflöst.
  • Signatur-Abgleich: Bekannte Standardbibliotheks- und Kryptographiefunktionen werden vor der LLM-Analyse per Muster identifiziert, wodurch teure Inferenz für Funktionen mit bekannter Identität übersprungen wird.
  • Syntaktische Normalisierung: Die Dekompiler-Ausgabe wird bereinigt (Modulo-Wiederherstellung, Rekonstruktion negativer Literale, Entfernung toter Zuweisungen), bevor sie den LLM erreicht, wodurch Rauschen und Token-Verschwendung reduziert werden.
  • Agentische Deobfuskation: Kong verwendet eine agentische Deobfuskations-Pipeline, die Obfuskationstechniken (Kontrollflussglättung, unechter Kontrollfluss, Befehlsersetzung, String-Verschlüsselung, VM-Schutz usw.) in der Dekompiler-Ausgabe identifizieren und entfernen kann.
  • Eval-Framework: Eingebautes Evaluierungs-Framework, das Analyseergebnisse mit Ground-Truth-Quellcode vergleicht und die Symbolgenauigkeit (wortbasierter Jaccard) und Typgenauigkeit (Signaturkomponenten-Bewertung) misst.
  • Multi-Provider-LLM-Unterstützung: Funktioniert sofort mit Anthropic (Claude) und OpenAI (GPT-4o). Ein interaktiver Setup-Assistent konfiguriert Provider und intelligentes Routing wählt automatisch den mit gültigem Schlüssel aus.
  • Kostenverfolgung: Verfolgt Token-Nutzung und Kosten pro Modell über Provider hinweg, mit providerbewusster Preisgestaltung.

Unterstützte Architekturen

Kong arbeitet mit den meisten Ghidra-dekompilierbaren Binärdateien (vorerst, mehr folgen).

Confidence

CC++GoRust
x86HochHochMittelMittel
x86-64HochHochMittelMittel
ARM (32-bit)HochHochMittelNiedrig
AArch64HochHochMittelNiedrig
MIPSMittelMittelNiedrigNiedrig
PowerPCMittelMittelNiedrigNiedrig

Hoch: Kong dekompiliert, deobfuskiert und stellt Namen, Typen und Struktur zuverlässig wieder her.

Mittel: Die Dekompilation ist brauchbar, aber verrauschter. Erwarten Sie teilweise Wiederherstellung und niedrigere Konfidenzwerte.

Niedrig: Die Dekompilation hat erhebliche Lücken und die Ergebnisse bleiben unvollständig, verrauscht oder unlesbar.

Hinweis: Die Binärdateigröße skaliert positiv mit der Funktionsanzahl, den LLM-Kosten und der Fertigstellungszeit. Allerdings skaliert die Binärdateigröße auch negativ mit der Konfidenz, denken Sie daran bei der Analyse größerer Binärdateien.

Architektur

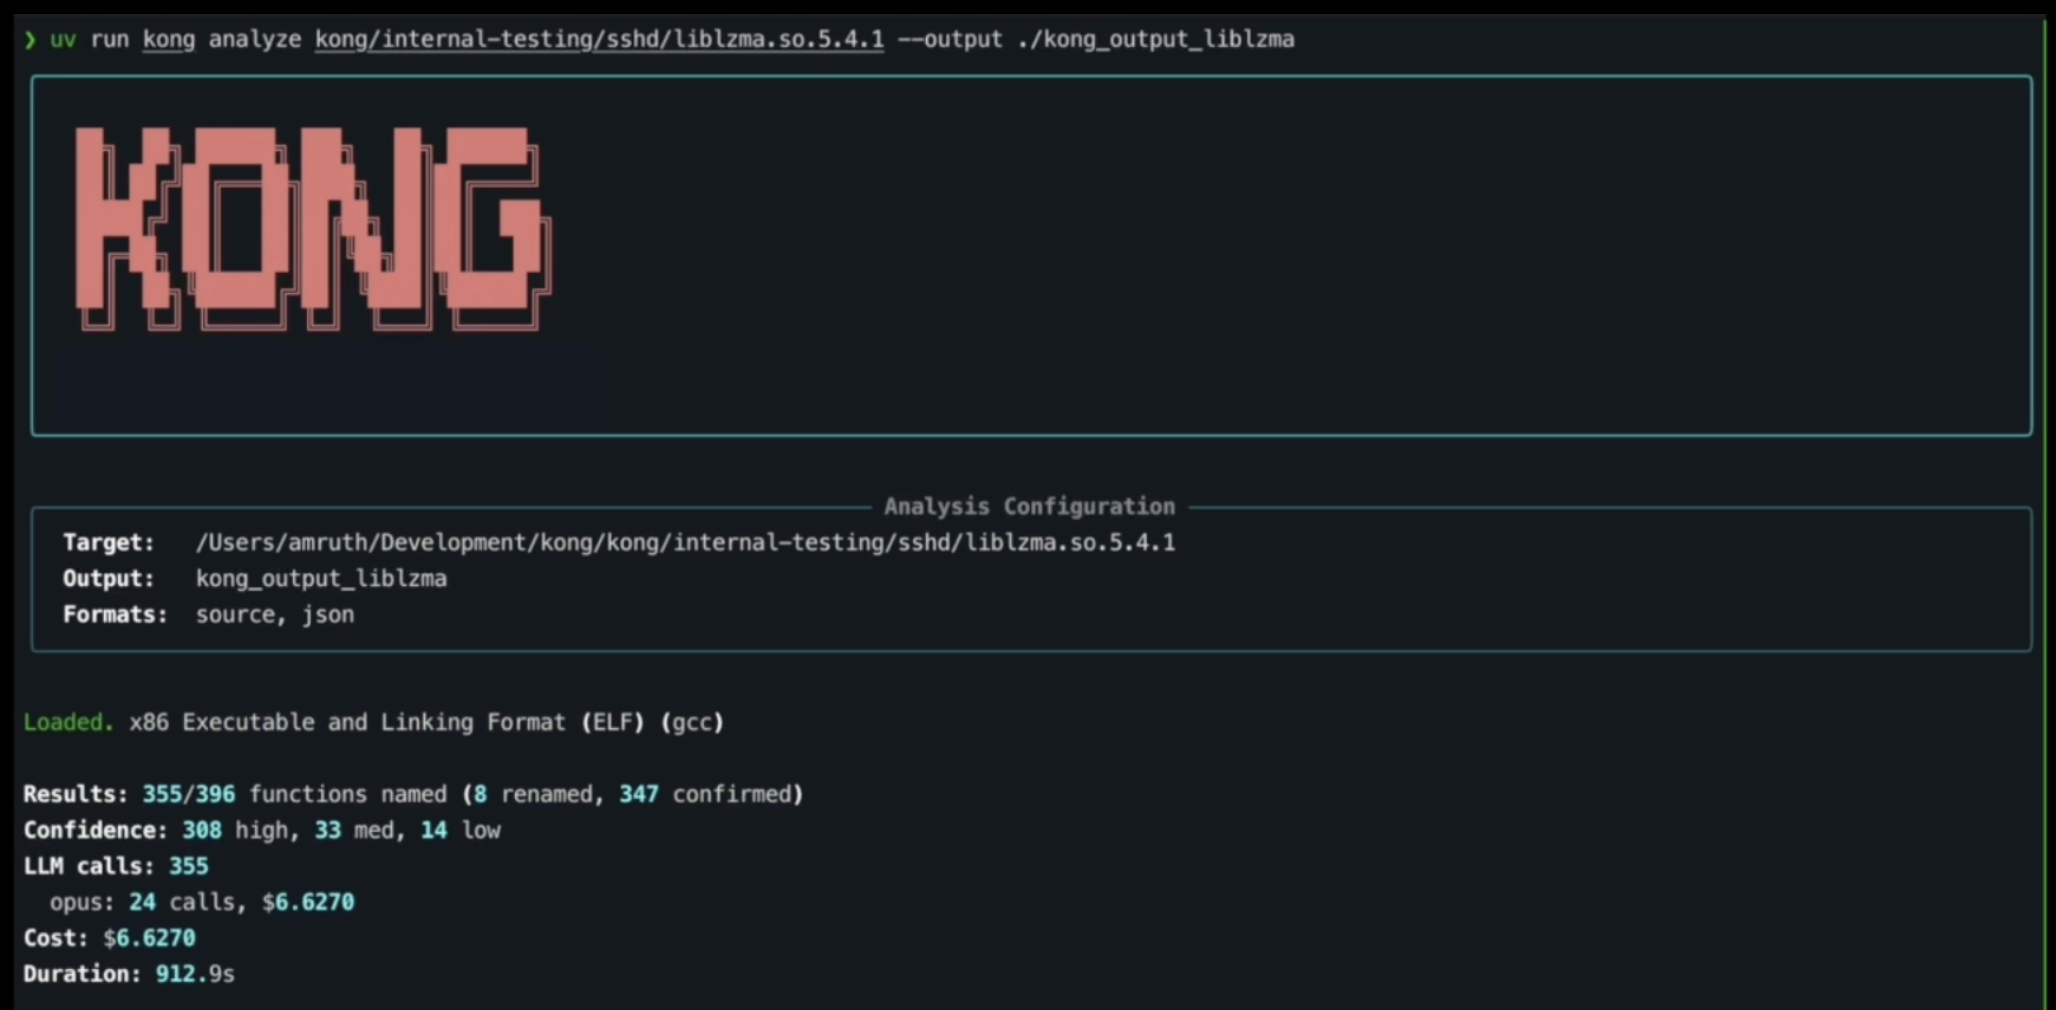
Kong verwendet eine fünfphasige Pipeline, die von einem Supervisor orchestriert wird, der Triage, parallele Analyse und Nachbearbeitung koordiniert:

Tool herunterladen