amd2g2zz/kunglao-agent
Der Reverse-Engineering-Expertenagent: plant seinen eigenen Analysepfad, leitet jeden Fakt aus Rohdaten ab und konvergiert unter mechanischen Verifikationsgates — Firmware, Protokolle, Web/JS, Risikokontrolle, Binärdateien.
Ein autonomer Reverse-Engineering-Agent, der stundenlang unbeaufsichtigt läuft, jede Schlussfolgerung unabhängig verifiziert und sich erst dann einpendelt, wenn jede Antwort ein mechanisches Orakel-Urteil übersteht.


🧠 plant seine eigene Route · 🔬 jede Behauptung maschinell geprüft · ⚖️ Blindverifikation bei allem · 📈 die Schleife misst sich selbst
🚀 Schnellstart · ✨ Kerntechnologie · 🧠 kunglao × Claude Code · 🎛️ Wie RL funktioniert · 🖥️ Showcase · 📖 Fallstudien · 🧪 Evaluierung · 🏗️ Architektur · 🗓️ Roadmap
English · 简体中文
[!WARNING] v0.1.6 ist die letzte Claude Code-native Release-Linie. Der nächste Meilenstein (v0.2) migriert die Laufzeit vollständig auf die PI Agent-Basis — gleiche Schleife, gleiche Ledger, neues Engine-Substrat. Siehe Roadmap.
Sie richten kunglao-agent auf ein Ziel und stellen die Fragen; es plant die Route, entsendet spezialisierte Worker, verifiziert jede Schlussfolgerung unabhängig und stoppt erst, wenn jede Antwort durch eine mechanische Prüfung geklärt ist statt durch die Behauptung eines Modells.
Das Zielspektrum ist das volle — Windows/Linux-native Binärdateien, Android
APKs (einschließlich nativer .so-Schichten), Web/JS, Protokollwiederherstellung, Firmware —
Static-first by design, wobei der Ausführungskanal genutzt wird, den Ihre Umgebung
bereits hat (VMware, ssh, docker, adb oder gar keiner für reine Static-Arbeit).
Es läuft innerhalb von Claude Code als Plugin: Claude Code ist die Konversationsoberfläche; das Produkt ist die Schleife und die Faktenbasis, die sie erzeugt.
[!NOTE] Jede Zahl, die die Schleife meldet — Gewinnraten, Posterior-Verteilungen, Budgets — lässt sich auf eine Zeile in einem Append-only-Ledger zurückverfolgen. Nichts ist selbst erklärt.
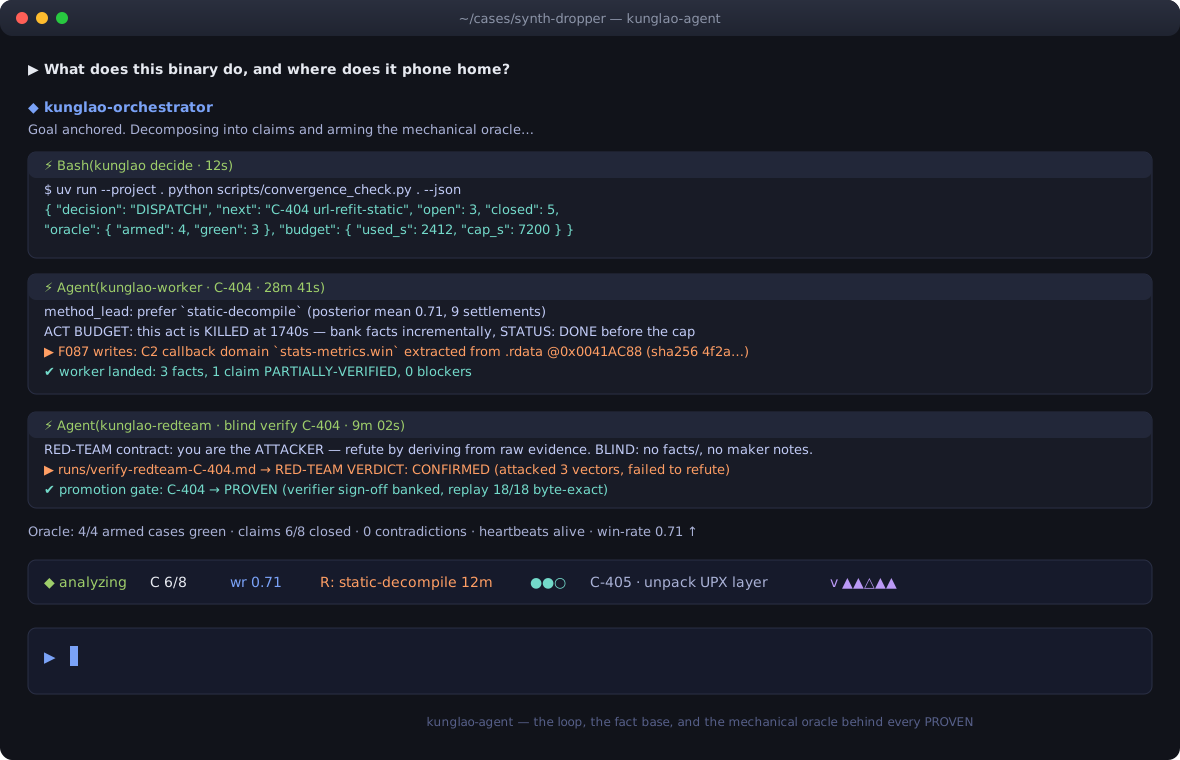
Der Orchestrator bei der Arbeit — eine Konvergenzentscheidung, ein budgetierter Worker-
Dispatch mit live eintreffenden Fakten und ein blindes Red-Team-Urteil, das eine
Behauptung zu PROVEN befördert; das Statusline-HUD hält das gesamte Engagement auf
einen Blick lesbar:
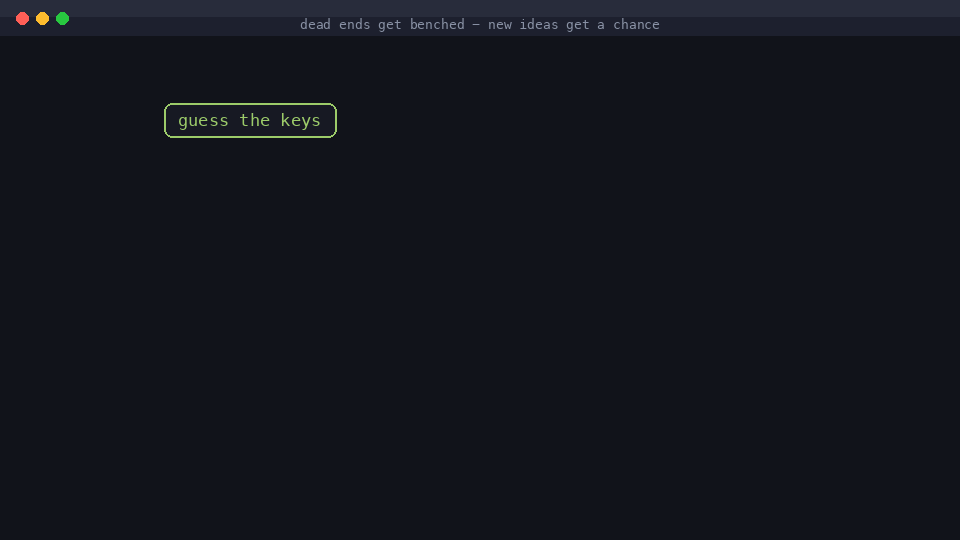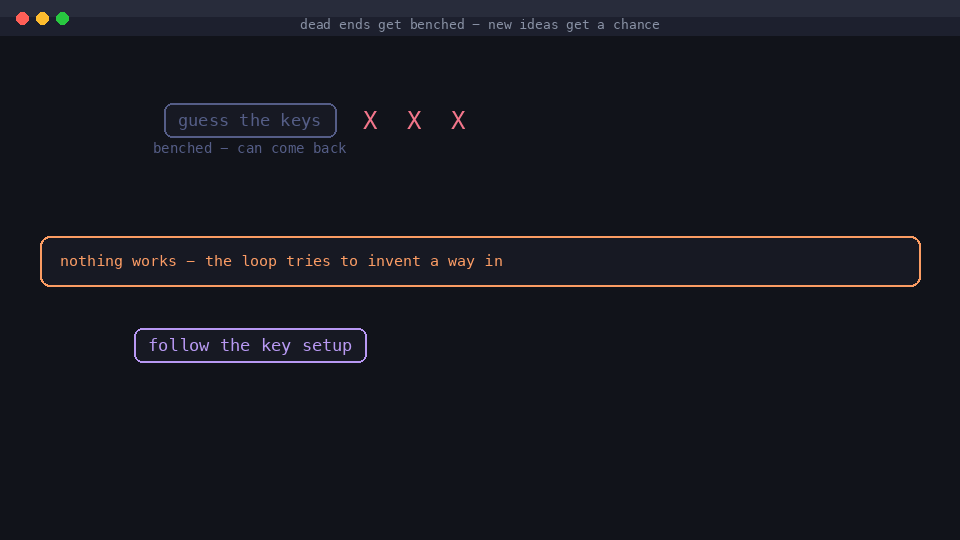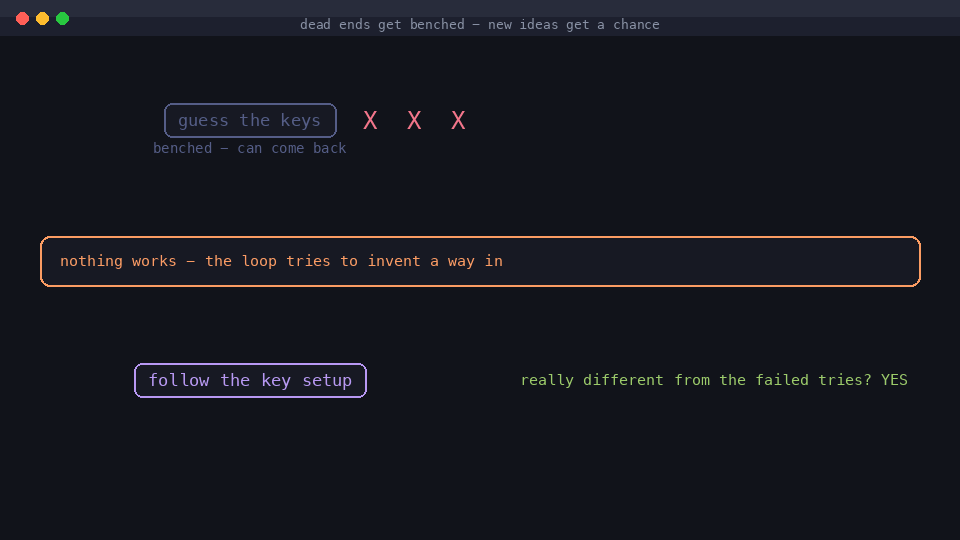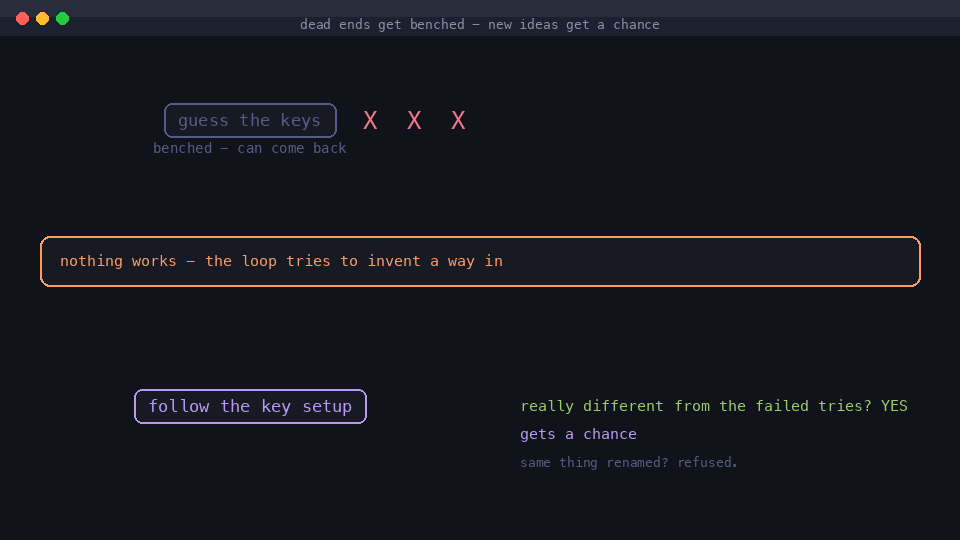
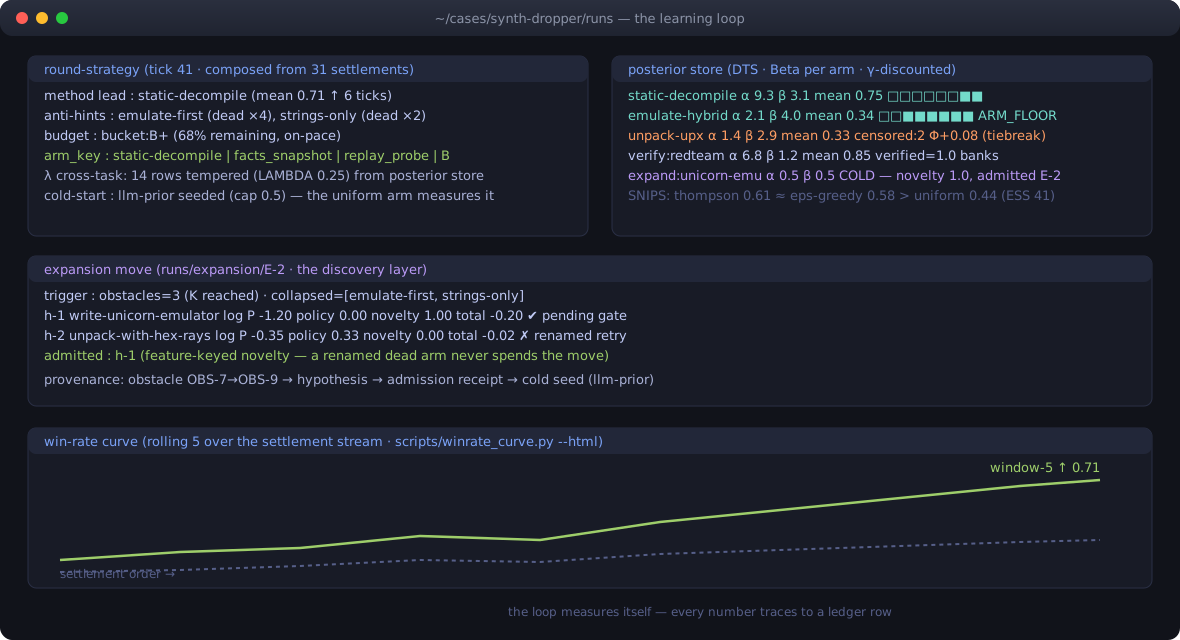
Die Schleife, die sich selbst misst — die Rundstrategie, zusammengesetzt aus Settlements, der diskontierte Thompson-Posterior-Speicher mit zensierten Outcome-Tiebreaking, die Discovery-Schicht, die einen wirklich neuartigen Arm zulässt (und einen umbenannten Wiederholungsversuch ablehnt), und die Gewinnratenkurve:
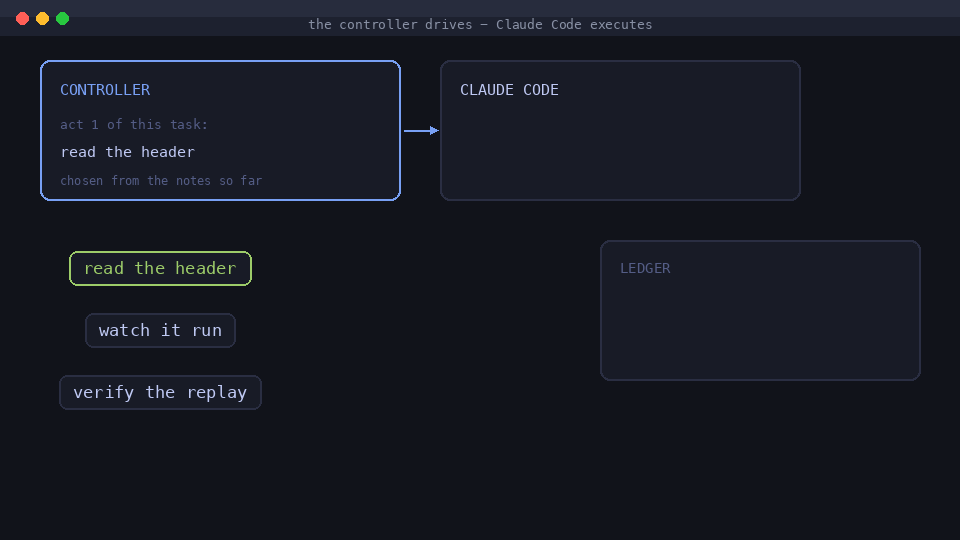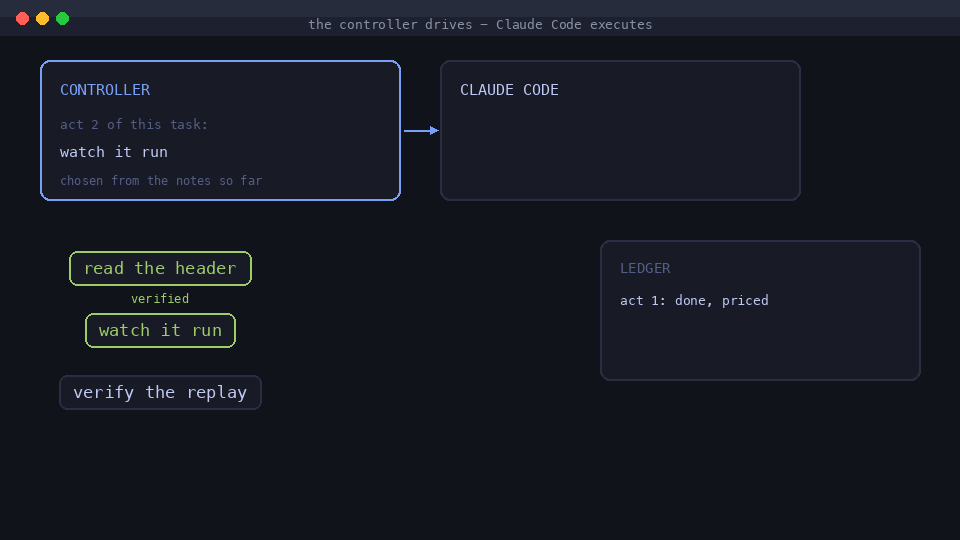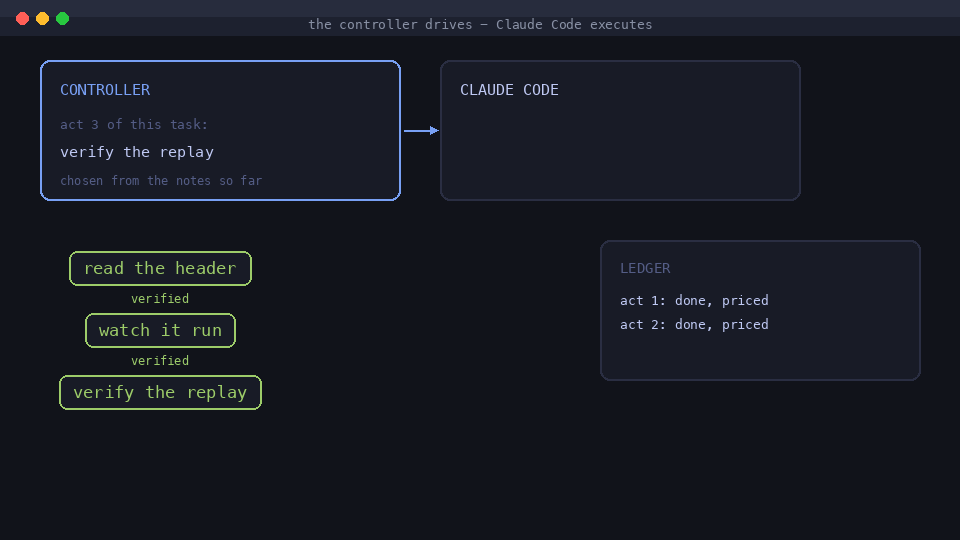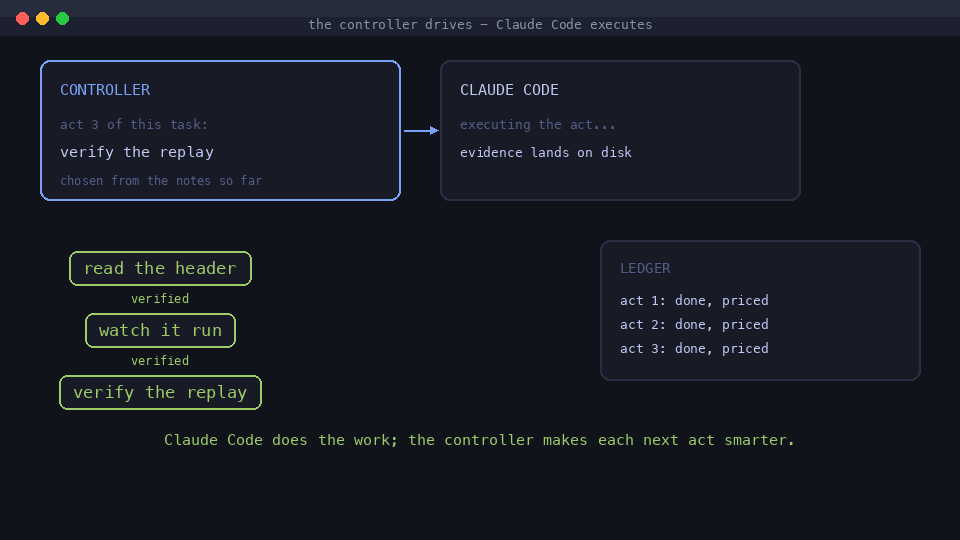
kunglao-agent ist ein Act-Level-RL-Controller um Claude Code: Claude
Code argumentiert innerhalb jedes Acts; kunglao entscheidet den nächsten Act, verifiziert ihn,
bepreist ihn, lernt daraus. Detailliertes Design: docs/design/.
STAMP begrenzt, niemals PROVEN. Fakten zitieren Artefakte (sha256) und tragen
reproduce:-Befehle.Claude Code ist der Motor; kunglao ist das Getriebe, das Dashboard und der Flug- computer — nächster Act, Verifikation, Budget und wohin die Erfahrung geht.
| reines Claude Code | + kunglao | |
|---|---|---|
| Nächster Schritt | in der Sitzung improvisiert | erlernte Act-Level-Policy, Posterior-Verteilungen bleiben über Aufgaben hinweg erhalten |
| Verifikation | Selbstauskunft | mechanisches Orakel + blindes Red-Team |
| Dauer | eine Sitzung, Mensch schaut zu | stundenlang unbeaufsichtigt, Wiederaufnahme von der Festplatte |
| Erfahrung | verdampft am Sitzungsende | Ledger → Posterior-Verteilungen → schärfere Eröffnungswette |
Ehrliche Grenze: Bei einer einfachen Einzelsitzungsaufgabe gewinnt reines Claude Code — die Evaluierungstabelle sagt es. kunglao zahlt sich über lange Horizonte aus, durch Verifikationsdisziplin und aufgabenübergreifende Kumulierung.
Die erste Aufgabe einer neuen Art zahlt den vollen Preis: Die Schleife probiert eine Methode, sieht sie scheitern, probiert eine andere. Aber jeder Versuch wird aufgeschrieben — und die nächste Aufgabe derselben Art beginnt aus diesen Notizen, nicht bei null.
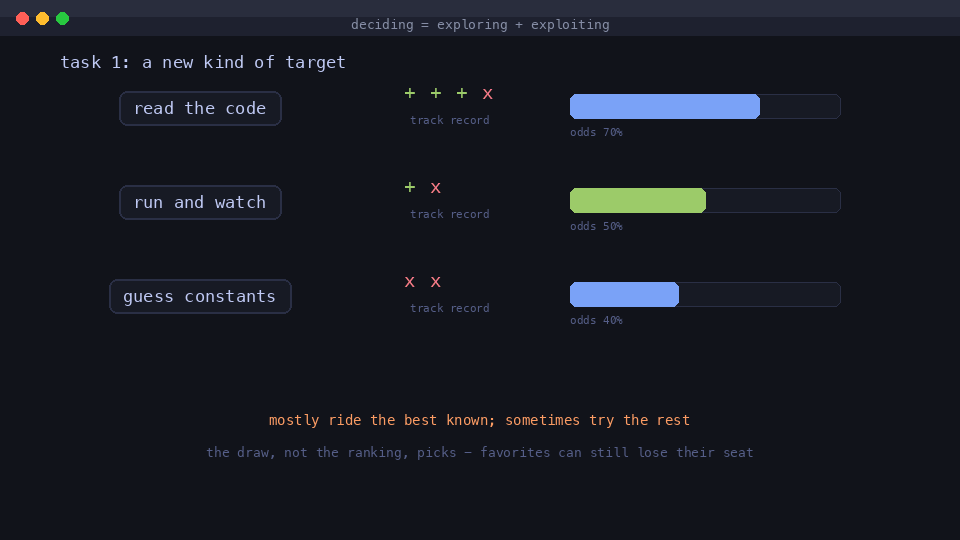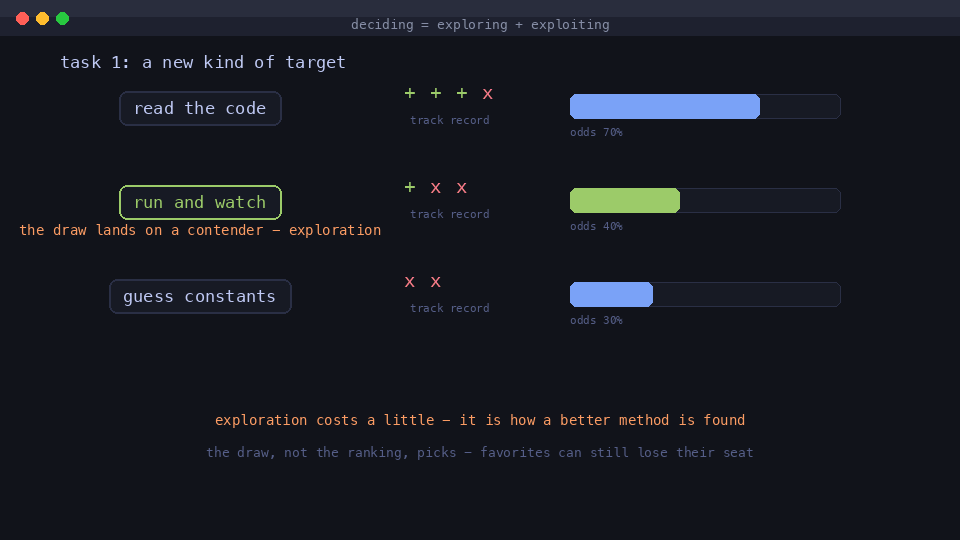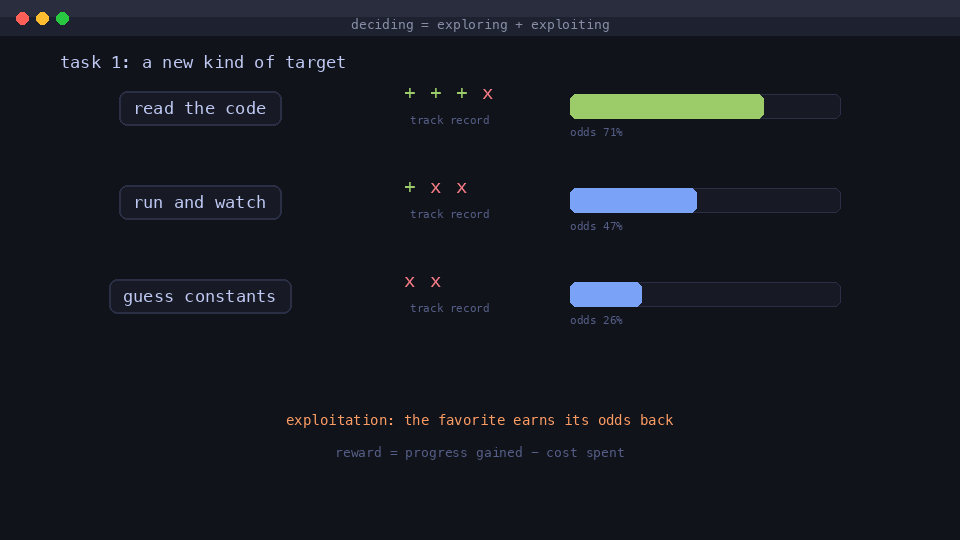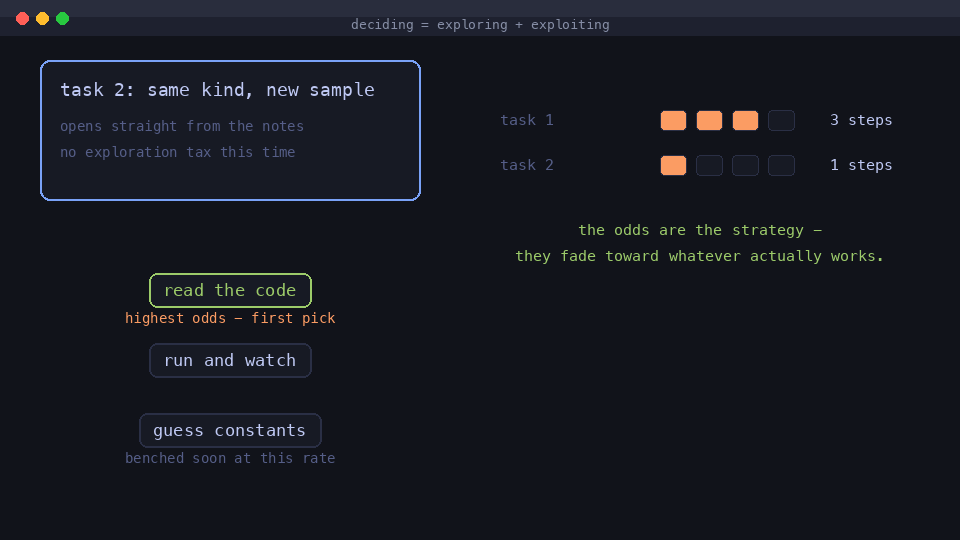
Das ist die ganze Idee des Online-Reinforcement-Learnings hier: Die Schleife aktualisiert sich zwischen den Acts, während der Arbeit — kein Trainingsdatensatz, kein Modell- Retraining, keine Offline-Phase. Die Erfahrung jeder Aufgabe wird gebankt, bevor die nächste Entscheidung getroffen wird.
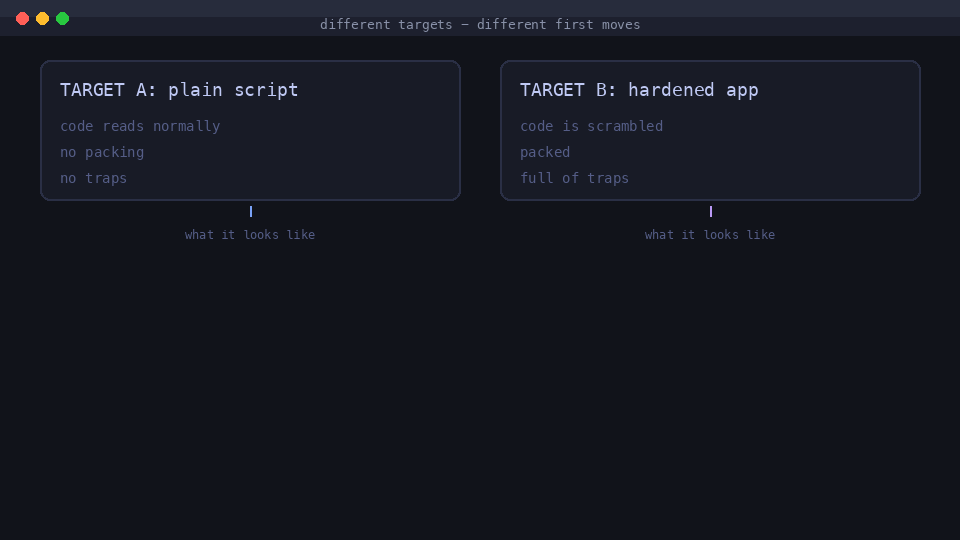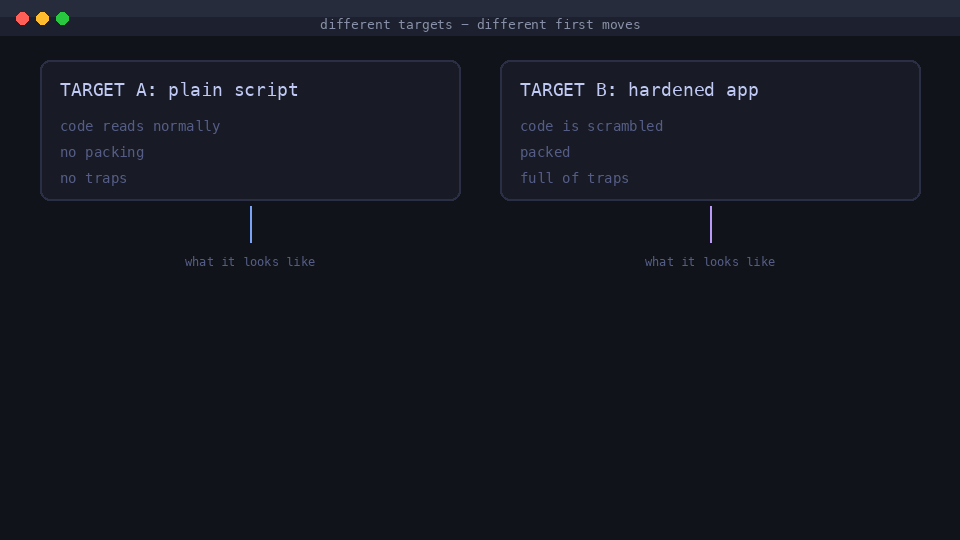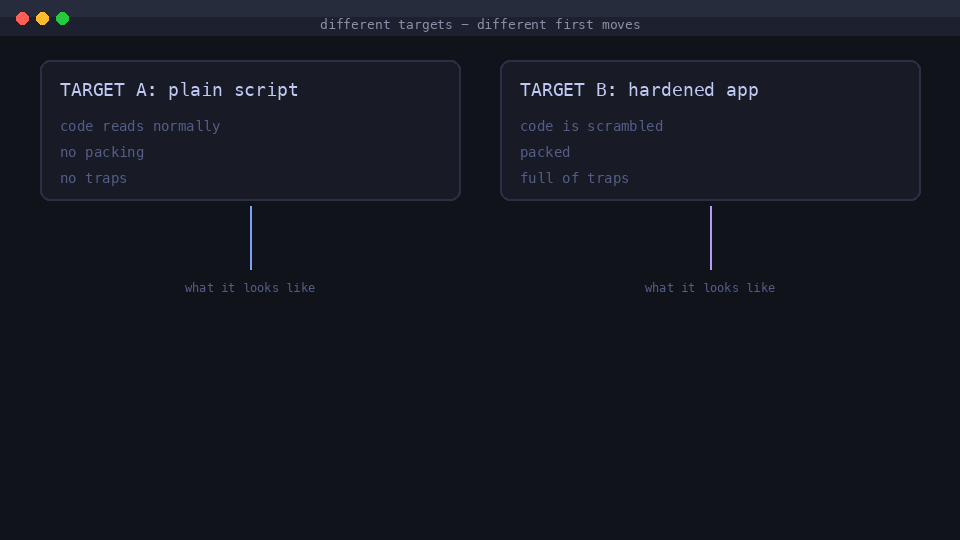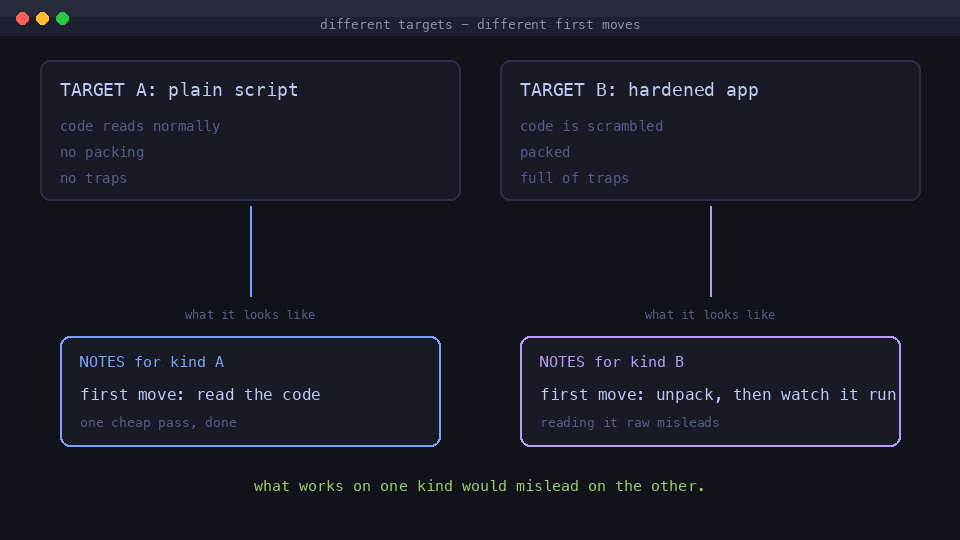
1. Der richtige erste Zug, pro Art von Ziel. Ein einfaches Skript und eine gehärtete App sollten nicht auf dieselbe Weise beginnen. Die Schleife führt separate Notizen pro Art von Ziel — wie das Ziel aussieht, entscheidet, welches Playbook gilt.
2. Welche Methoden tot sind. Eine Methode, die wiederholt scheitert, wird auf die Bank gesetzt — sie verbraucht kein Budget mehr (aber wird nie gelöscht; wenn sich das Ziel ändert, kann sie zurückkommen). Und wenn nichts funktioniert, versucht die Schleife, einen Weg hinein zu erfinden: Ein Discovery-Act schlägt einen wirklich neuen Ansatz vor, geprüft gegen die gescheiterten Versuche — dieselbe Idee umbenannt wird abgelehnt.