
 adam-atlassoftware/kraken
Reverse-Engineering-Workbench auf Basis von Ghidras Decompiler mit einer nativen, Java-freien Engine, KI-gestützter Funktionsanalyse, Byte-Patching, sandboxed Emulation und CLI/MCP-Automatisierung.

Zerlege ein Programm und verstehe es – mit einer helfenden Hand. KRAKEN ist eine Open-Source-Workbench für Reverse Engineering, die auf Ghidras Decompiler aufbaut, mit einer Java-freien nativen Engine und einer optionalen vollständigen Ghidra-Engine. Du, deine Skripte und KI-Agenten arbeiten alle über einen gemeinsamen Satz von Befehlen am selben Projekt, und jede Änderung wird protokolliert, einem Urheber zugeordnet und ist rückgängig zu machen. Du musst kein Reverse Engineering beherrschen, um anzufangen: Die App erklärt Begriffe, während du vorankommst, und das Tutorial führt dich durch eine erste Sitzung. Das langfristige Ziel sind Rust-Neuschreibungen von Binärdateien, Funktion für Funktion, geprüft gegen das Original.
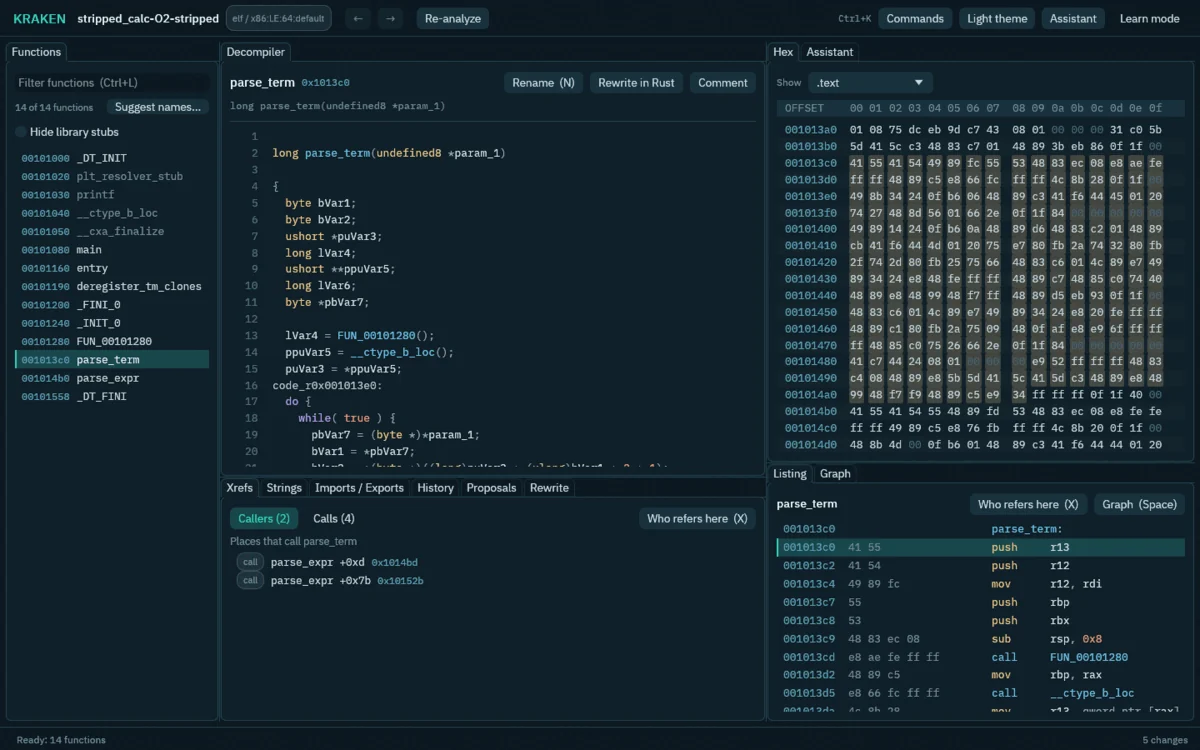
Ein echtes Projekt der nativen Engine: stripped_calc-O2-stripped aus diesem Repository, nachdem einige Funktionen benannt wurden.
Analysieren
Patchen
KI
Automatisieren
--json-Ausgabe für Skripte, ein Python-Modul und ein Hintergrund-Daemon, der Projekte warmhält.Neuschreiben
KRAKEN ist Pre-Alpha (0.1a). Rechne mit Ecken und Kanten und mit brechenden Änderungen.
| Linux x86_64 | macOS (Apple Silicon) | Windows x86_64 | |
|---|---|---|---|
| CLI, MCP-Server, GUI | Funktioniert | Baut, experimentell | Baut, experimentell |
Native Engine, kein Java (kraken setup --native) | Funktioniert (ELF und PE) | Noch nicht | Noch nicht |
Analyse mit Ghidra (kraken setup) | Funktioniert | Noch nicht | Noch nicht |
| Sandbox um Ghidra | Landlock | Noch nicht | Noch nicht |
| Lokale Modelle | Funktioniert | Baut | Baut |
| Rewrite-Pipeline | Funktioniert (benötigt Landlock und ein Modell) | Verweigert den Start | Verweigert den Start |
„Baut" bedeutet, dass der Code kompiliert und in der CI geprüft wird, nicht dass das gesamte Produkt dort erprobt wurde. Linux ist die Plattform, die heute verwendet werden sollte.
Linux x86_64 (kein Java nötig: die native Engine und ihre Prozessor-Dateien sind im Release enthalten):
curl --proto '=https' --tlsv1.2 -fsSL https://raw.githubusercontent.com/Adam-AtlasSoftware/kraken/main/scripts/install.sh | bash
Das Skript prüft den Download gegen die SHA256SUMS des Releases, benötigt kein sudo und installiert nach ~/.local. Oder nimm das AppImage aus dem neuesten Release (chmod +x KRAKEN-*.AppImage, dann ausführen; ./KRAKEN-*.AppImage kraken --help startet die Kommandozeile), oder installiere unter Arch Linux kraken-workbench-bin aus dem AUR. Windows- und macOS-Archive sind ebenfalls auf der Releases-Seite zu finden und sind experimentell (siehe Status). Install enthält die Details und den Build aus dem Quellcode.
kraken project-create --binary /usr/bin/ls --project ~/kraken-projects/ls
kraken analyze --project ~/kraken-projects/ls
kraken list-functions --project ~/kraken-projects/ls --limit 20
kraken-gui                             # or open the app and pick the project
Neue Projekte verwenden die native Engine, wenn sie die Datei öffnen kann, andernfalls die optionale Ghidra-Engine (Mach-O, andere Prozessoren, Windows-Debuginformationen), die kraken setup beim ersten Gebrauch zusammen mit einem JDK herunterlädt. Die Seite zur nativen Engine vergleicht die beiden. Die Übungsprogramme in corpus/bin/ sind ein guter Einstieg, und das Tutorial führt durch eine erste Sitzung.
Einen Agenten verbinden: claude mcp add kraken -- kraken mcp --project ~/kraken-projects/ls.
Sie benötigen Rust und einen C++-Compiler:
git clone https://github.com/Adam-AtlasSoftware/kraken && cd kraken
cargo build --release -p kraken-cli -p krakend -p kraken-gui -p engine-native -p kraken-emu
export PATH="$PWD/target/release:$PATH"
kraken setup --native                  # once: fetches the pinned sources, compiles the Sleigh files (about a minute)
Beginne mit dem Tutorial: Deine erste Reverse-Engineering-Sitzung.
