
darts v0.47.0
Eine Python-Bibliothek für benutzerfreundliche Prognose und Anomalieerkennung auf Zeitreihen.
Zeitreihen leicht gemacht in Python




Darts ist eine Python-Bibliothek für benutzerfreundliche Prognosen und Anomalieerkennung
auf Zeitreihen. Sie enthält eine Vielzahl von Modellen, von Klassikern wie ARIMA bis hin zu
tiefen neuronalen Netzen. Die Prognosemodelle können alle auf die gleiche Weise verwendet werden,
mit fit()- und predict()-Funktionen, ähnlich wie bei scikit-learn.
Die Bibliothek erleichtert auch das Backtesting von Modellen,
das Kombinieren der Vorhersagen mehrerer Modelle und die Berücksichtigung externer Daten.
Darts unterstützt sowohl univariate als auch multivariate Zeitreihen und Modelle.
Die ML-basierten Modelle können auf potenziell großen Datensätzen mit mehreren Zeitreihen
trainiert werden, und einige der Modelle bieten umfangreiche Unterstützung für probabilistische Prognosen.
Darts bietet auch umfangreiche Anomalieerkennungsfunktionen. Beispielsweise ist es trivial, PyOD-Modelle auf Zeitreihen anzuwenden, um Anomalie-Scores zu erhalten, oder eines der Darts-Prognose- oder Filtermodelle zu umhüllen, um vollwertige Anomalieerkennungsmodelle zu erhalten.
Dokumentation
Einführungen auf hoher Ebene
Artikel zu ausgewählten Themen
- Modelle auf mehreren Zeitreihen trainieren
- Verwendung vergangener und zukünftiger Kovariaten
- Temporale Convolutional Networks und Prognosen
- Probabilistische Prognosen
- Transfer Learning für Zeitreihenprognosen
- Hierarchische Prognoseabstimmung
Schnellinstallation
Wir empfehlen, zunächst eine saubere Python-Umgebung für Ihr Projekt mit Python 3.11+ und Ihrem bevorzugten Tool einzurichten (conda, venv, virtualenv mit oder ohne virtualenvwrapper).
Sobald Ihre Umgebung eingerichtet ist, können Sie darts mit pip installieren:
pip install darts
Weitere Details finden Sie in unseren Installationsanweisungen.
Beispielverwendung
Prognose
Erstellen Sie ein TimeSeries-Objekt aus einem Pandas DataFrame und teilen Sie es in Trainings-/Validierungsreihen auf:
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
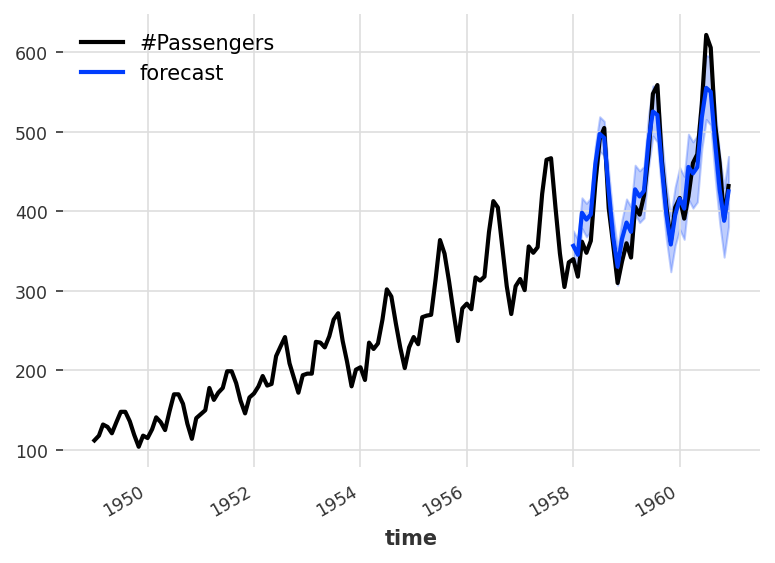
Fit ein exponentielles Glättungsmodell an und erstelle eine (probabilistische) Vorhersage über die Dauer der Validierungsreihe:
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
Stellen Sie den Median sowie das 5. und 95. Perzentil dar:
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
Anomalieerkennung
Laden Sie eine multivariate Reihe, kürzen Sie sie, behalten Sie 2 Komponenten, teilen Sie Trainings- und Validierungsdatensätze auf:
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
Erstelle einen k-means-Anomalie-Scorer, trainiere ihn auf dem Trainingsset und verwende ihn auf dem Validierungsset, um Anomalie-Scores zu erhalten:
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
Erstelle einen binären Anomalie-Detektor und trainiere ihn mit Trainings-Scores, verwende ihn dann mit Validierungs-Scores, um eine binäre Anomalieklassifikation zu erhalten:
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
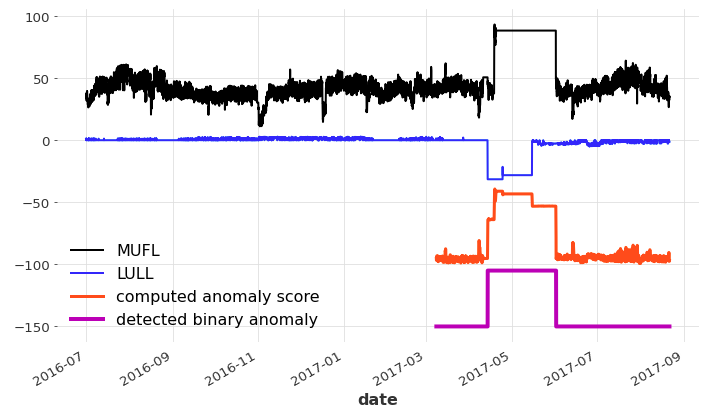
Plot (Verschieben und Skalieren einiger der Reihen, damit alles in derselben Abbildung erscheint):
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)
Funktionen
- Prognosemodelle: Eine große Sammlung von Prognosemodellen für Regressions- sowie Klassifikationsaufgaben; von statistischen Modellen (wie ARIMA) bis hin zu Deep-Learning-Modellen (wie N-BEATS). Siehe die Prognosemodelle unten.