
 #1
Frameworks für adversariales ML-Angriffe, Umgehungstechniken und Tools zur Bewertung der Modellrobustheit.
Kitploit empfohlen
 phil-fan/fs-attack
Implementierung des Papers „Rethinking Latency Denial-of-Service: Attack the LLM Serving Framework, Not the Model“
 stardust457/sldr
Verteidigungsframework, das bösartiges Fine-Tuning von LLMs durch selektive Schichtwiederherstellung und dynamisches Routing abschwächt, mit…
 cybershujin/prompt-injection-in-the-wild
Tracker öffentlich gemeldeter Prompt-Injection-Techniken, aufgeschlüsselt nach Übermittlungsmethode, Kodierung und Ausbreitungsverhalten, mit…
 zju-llm-safety/trace
Agentic jailbreak framework for LLM-based agents using scheme-based task decomposition, multi-turn disguising strategies, and adaptive self-evolution…
 sliu11-byte/mea-bench
Ein Lifecycle-Benchmark für Black-Box-LLM-Extraktionsangriffe, Verteidigungen und adaptive Angriffe.
 multimodal-ai-lab/tobac
Token für Token kompromittiert: Backdoor-Schwachstellen in Unified Autoregressive Models (NeurIPS'26)
 facebookincubator/ttpforge
Das TTPForge ist ein Cybersicherheits-Framework zur Entwicklung, Automatisierung und Ausführung von Angreifer-Taktiken, -Techniken und -Verfahren…
 kaill-jlq/mmskillrisk
Benchmark- und Evaluierungs-Harness, der testet, ob LLM-Agenten bösartigen Anweisungen widerstehen, die in multimodalen Skill-Bildern verborgen sind,…
 albert-y1n/piforge
Offenes Framework für RL-basiertes Red Teaming bei Prompt-Injection, mit einem gemeinsamen Trainer, Curriculum Learning und Benchmarks wie AgentDojo,…
 albert-y1n/pismith
PISmith: Reinforcement-Learning-basiertes Red Teaming für Prompt-Injection-Abwehrmaßnahmen
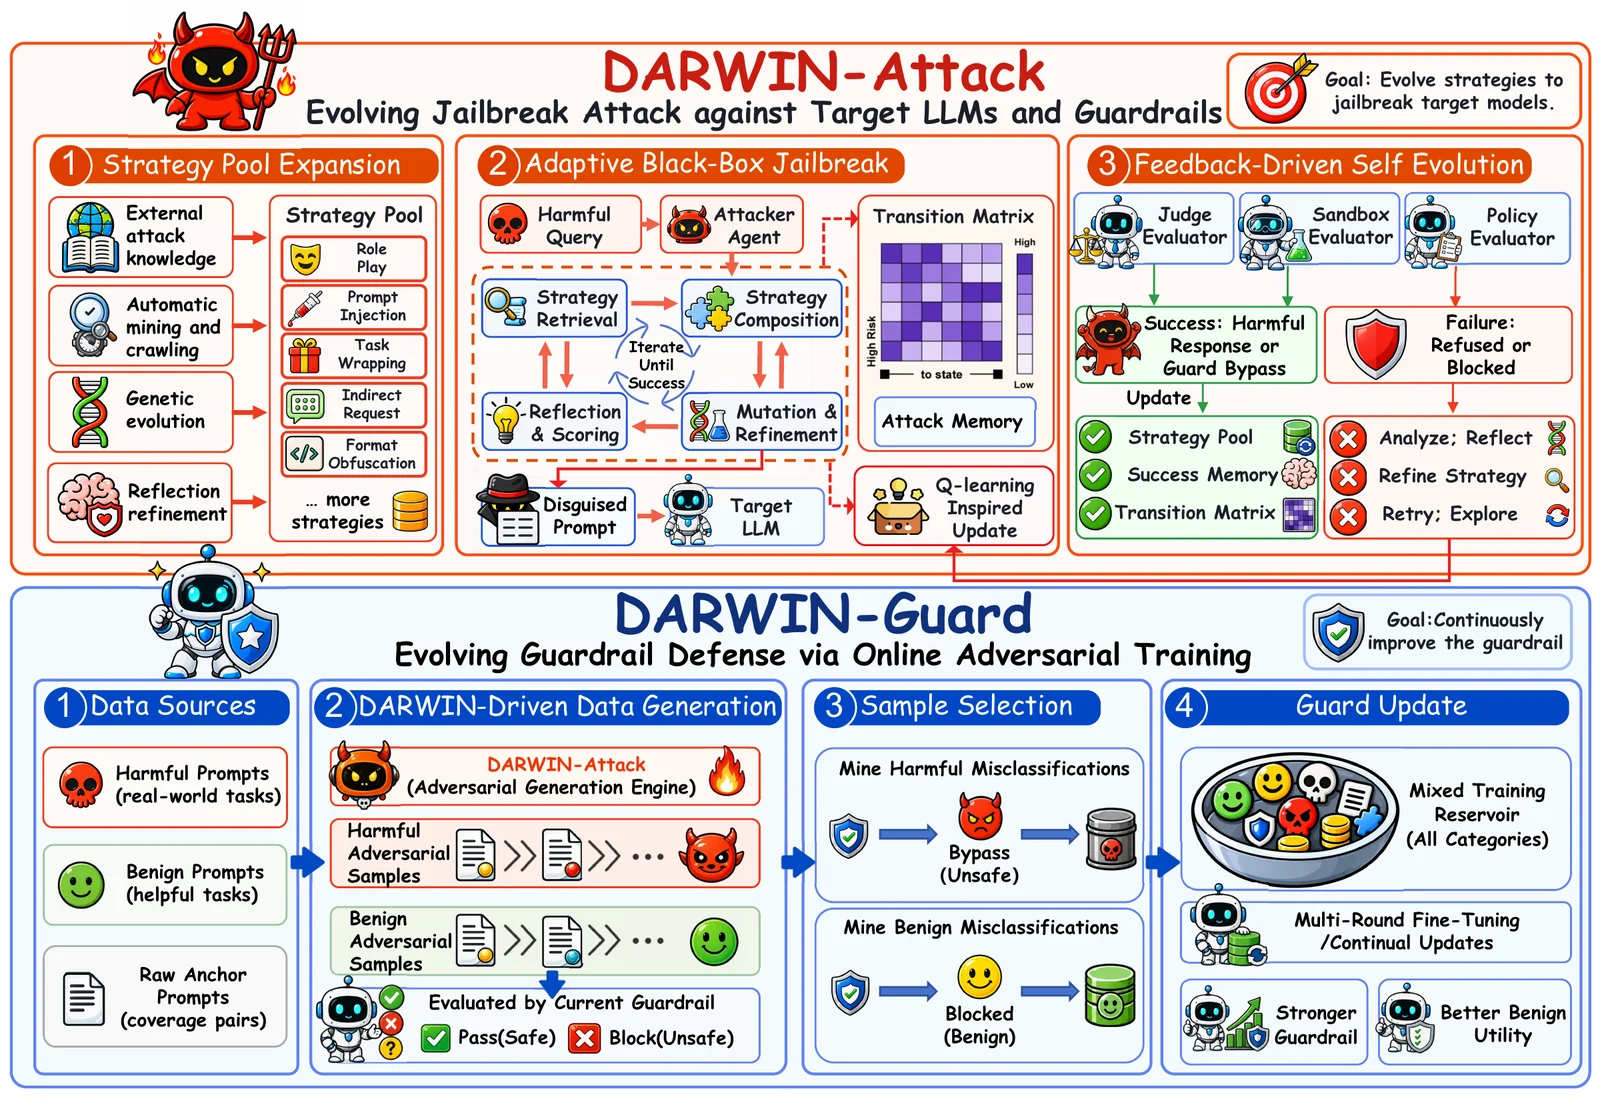 zju-llm-safety/darwin
Evolutionäres LLM-Jailbreak- und Guardrail-Framework, das einen wiederverwendbaren Strategiepool durch genetische Mutation, Markov-Auswahl und…
 pho5nix/red-team-goad-lab-proxmox
Build-Anleitung für ein Red-Teaming-Homelab. GOAD-Lab-Setup in Proxmox und pfSense, Operator/C2 und Redirectors.
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…
 ml-security-research-lab/cachetrap
Research code for a gray-box trojan attack that flips a single KV-cache bit in fine-tuned LLM classifiers and measures per-class attack success rate.
 joshuagodwin7929/purple-team-automation
Automatisierte Gegneremulation (Caldera) gegen ein AD-Lab, um die Sigma-Erkennungsabdeckung zu validieren und Ergebnisse MITRE ATT&CK zuzuordnen.
 sisl-uri/t-backdoor
Forschungscode zur Implementierung von T-Backdoor, zeitlich ausgelösten Backdoor-Angriffen auf spiking neuronale Netze unter Verwendung von Rate-,…
 euph00/zoneclaw-code
Benchmark- und Verteidigungscode für persistente Speicherangriffe auf Computer-Use-Agenten im OpenClaw-Stil, mit Memory-Zoning-Mitigation,…
 usama1002/deleting-the-trace
Experimente zur Unterdrückung von Gedankenketten mittels Steuer-Token und zu Parser-Nachsichtigkeitsangriffen auf werkzeugnutzende LLM-Agenten








