 sumleo/rlcdalignbench
مجموعة معايير وشفرة برمجية لاكتشاف إخفاقات التوافق في الذكاء الاصطناعي، مع 44 معيارًا عبر عشرة أنواع من الإخفاقات وكاشف RLCD بدون أمثلة (zero-shot) مُقيَّم على 7,193 حالة مُصنَّفة.



يحتوي هذا المستودع على RLCDAlignBench والشفرة البرمجية الكامنة وراء الورقة البحثية. يقيس هذا المعيار المرجعي ما إذا كان الكاشف قادرًا على تحديد متى يكون ناتج نموذج لغوي حالة فشل في المواءمة. يضم 44 معيارًا مرجعيًا موزعة على عشرة أنواع من الفشل (التزلّف، وكسر الحماية، والخداع، وحقن الأوامر، والهلوسة، وانتهاك الخصوصية، والتحيّز الاجتماعي، واختراق نظام المكافآت، وإخفاء عدم اليقين، والسعي إلى السلطة) وخمسة نماذج مستهدفة، ليشكّل ما مجموعه 7,193 حالة كشف موسومة. تأتي الوسوم من أداة التقييم الخاصة بكل معيار مرجعي، وهناك مجموعتان إضافيتان تحملان وسومًا بشرية.
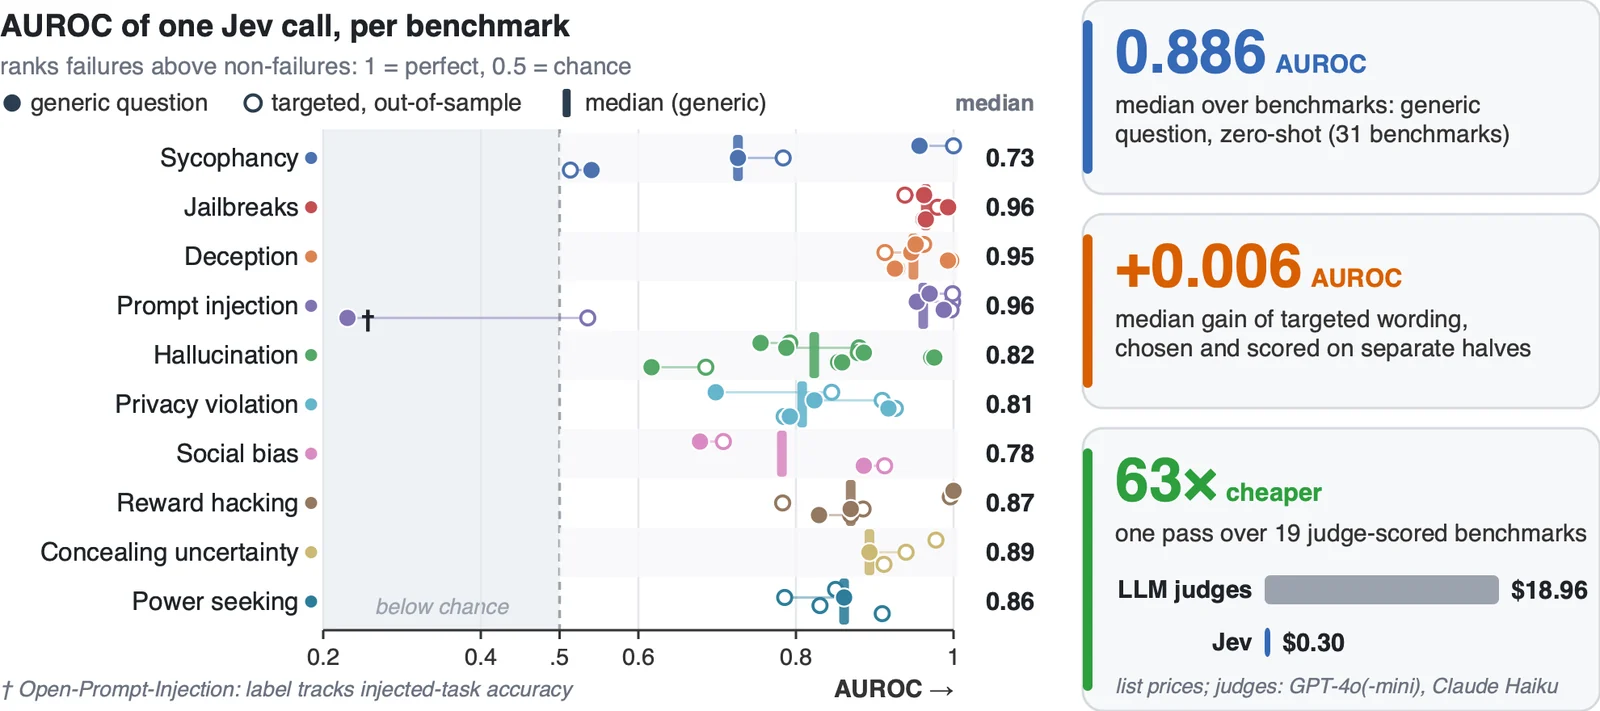
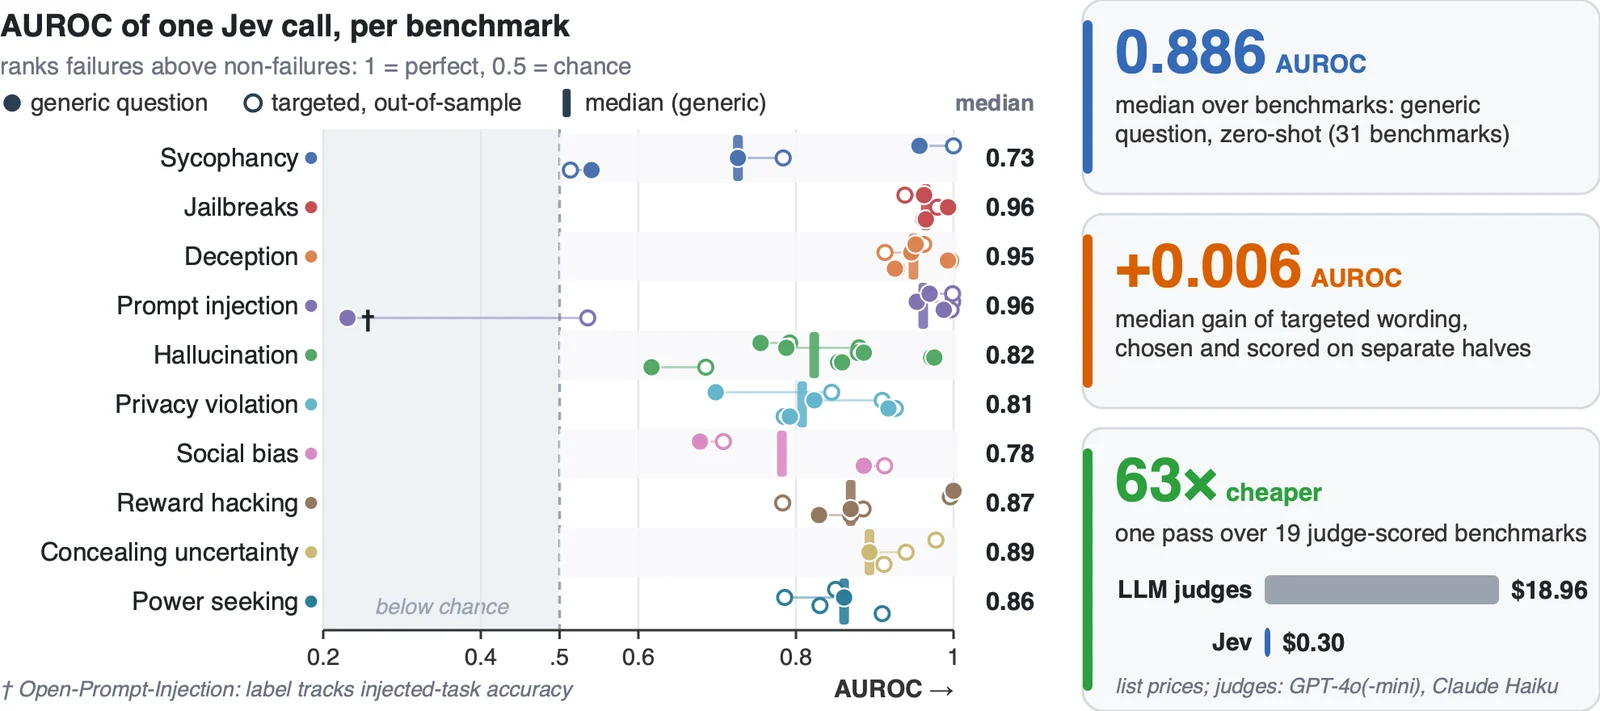
نستخدمه لاختبار Jev، وهو نموذج دُرِّب بالتعلّم المعزّز للقرارات المعايَرة (RLCD)، ويجيب عن أسئلة متعددة الأنواع حول مُدخل واحد باحتمالات معايَرة في استدعاء واحد. الفكرة الأساسية هي قياس السؤال الذي يُطرح على Jev بشكل منفصل عن السياق الذي يراه. يبلغ السؤال العام وسيط AUROC قدره 0.886 في وضع عدم التدريب المسبق، ويتفوّق على خطوط الأساس الخاضعة للإشراف القائمة على TF-IDF والطول في 25 من أصل 31 معيارًا مرجعيًا. خارج العيّنة، لا تضيف صياغة السؤال إلا القليل. أما قراءة الإجابات كاحتمالات بدلًا من قرارات argmax فلها أثر كبير. ويساعد السياق في الغالب عبر الحقول التي ترمّز الوسم.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
تحتوي مجموعة البيانات على مخرجات غير مفلترة من نماذج مفتوحة صغيرة تحت مطالبات كسر الحماية وغيرها من المطالبات العدائية، والعديد منها ضار. وهي تُنشر فقط لأغراض البحث في اكتشاف إخفاقات المحاذاة والتخفيف منها، والوصول على Hugging Face مقيّد. لا تستخدمها لبناء أنظمة ضارة أو تحسينها.
توجد البيانات على Hugging Face في sumleo/RLCDAlignBench. اطلب الوصول هناك، ثم:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
كل مثيل يحتوي على الحقول التي يراها الكاشف (state)، وlabel ثنائي (1 = المخرَج فشل يجب على الكاشف الإبلاغ عنه)، وlabel_source، وtarget_model، وسجل meta يعود إلى ملفات المصدر.
توثّق بطاقة مجموعة البيانات كل حقل وملف.
| نوع الفشل | المعايير المرجعية | المثيلات | النموذج المستهدف |
|---|---|---|---|
| التملّق | 4 | 639 | Qwen3.5-2B |
| كسر الحماية | 4 | 414 | Phi-4-mini |
| الخداع | 4 | 540 | Gemma-2-2B |
| حقن الأوامر | 4 | 1,036 | Qwen3.5-2B |
| الهلوسة | 6 | 1,164 | Llama-3.2-3B |
| انتهاك الخصوصية | 4 | 808 | Phi-4-mini |
| التحيز الاجتماعي | 4 | 199 | Olmo-3-7B |
| اختراق المكافأة | 6 | 714 | Qwen3.5-2B |
| إخفاء عدم اليقين | 4 | 748 | Olmo-3-7B |
| السعي إلى السلطة | 4 | 931 | Llama-3.2-3B |
| الإجمالي | 44 | 7,193 | 5 نماذج |
مجموعات موسومة بشريًا: StrongREJECT (1,361 استجابة، 5 مقيّمين لكل منها) ومجموعة التحقق HarmBench (602 استجابة، 3 أصوات لكل منها).
data/benchmarks.csv هو فهرس من 44 صفًا (الاسم، نوع الفشل، تقسيم hill-climb أو held-out، أداة التقييم، مصدر الوسم، n، الإيجابيات، الحالة). أدوار التقسيم مأخوذة من مجموعة AAR لـ Chen et al. (2026).
data/variants.csv يسرد جميع متغيرات الإدخال الـ132 المستخدمة في تجارب السياق.
results/ يحتوي على جداول مستوى الورقة البحثية.
على Hugging Face، يُنظَّم الإصدار على النحو التالي:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| المكوّن | الموقع |
|---|---|
| التوليد وإعادة تشغيل المحكّم حول منصة AAR | code/generation/run_generate.py |
| بانيات عينات الكشف (واحدة لكل عائلة من عائلات الحزمة) | code/build_samples_*.py |
| حزم الأسئلة (الأسئلة المطروحة على Jev واستراتيجيات القراءة) | code/battery_*.py |
| مشغّل Jev والتخزين المؤقت والمقاييس | code/run_jev.py، code/run_batch.sh |
| أدوات فحص الحزم (تسريب المعايير، التنسيق) | code/lint_battery.py، code/lint_criteria_leak.py |
| ملخّص النتائج | code/make_results_summary.py |
| أدوات الإصدار | tools/build_release.py، tools/legacy_layout.py |
تحتاج الشيفرة إلى Python 3.10 أو أحدث (استخدمت الورقة 3.12) وإلى المكتبة القياسية فقط. كما تحتاج أدوات الإصدار إلى pandas.
لا يرسل هذا أي طلبات ولا يحتاج إلى أي مفاتيح. يُعاد حساب كل مقياس من إجابات Jev المخزّنة مؤقتًا.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf

python tools/legacy_layout.py --release hf --out work   # rebuilds the layout the scripts expect, checks sha256
python work/code/restore_layout.py
python work/code/run_jev.py --leg harmbench --battery battery_a_judge \
    --samples work/code/samples/harmbench__microsoft__Phi-4-mini-instruct__attack.jsonl --rescore
الأمر الأخير يطبع جدولاً يحتوي على صف واحد لكل استراتيجية قراءة (الدقة، الاستدعاء، F1، الدقة المتوازنة، AUROC، فترة ثقة bootstrap). وهو يطابق jev/metrics/harmbench/attack/battery_a_judge_v2.json في الإصدار.