
 seclog-open/seclog
يجمع سجلات أمنية متعددة المصادر من سيناريوهات هجوم Docker قابلة لإعادة الإنتاج، ويبني سلاسل الهجوم، ويوفر معيار SecLog-Bench-216 لتقييم استدلال نماذج اللغة الكبيرة في مراحل الهجوم.

يدعم SecLog البحث في استدلال مراحل الهجوم انطلاقًا من سجلات أمنية متعددة المصادر. ويوفّر أدوات لجمع السجلات من سيناريوهات هجوم ونشاط طبيعي قابلة لإعادة الإنتاج عبر Docker، وتنظيم الأدلة في سلاسل هجوم، وبناء مجموعات بيانات موسومة، وتقييم تنبؤات النماذج.
تتضمّن الإصدار SecLog-Bench-216، وهو معيار جاهز للاستخدام يتكوّن من 216 نافذة أدلة ذات تسميات مراحل مُراجَعة وسلاسل استدلال مرجعية. ويمكن للباحثين استخدام المعيار المرفق مباشرةً أو تشغيل خط أنابيب البناء لإنتاج بيانات جديدة.
الورقة البحثية: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
موارد البناء على Zenodo: صور Docker، والسجلات الخام ومؤشرات المحاذاة، وسلاسل الهجوم المبنية.
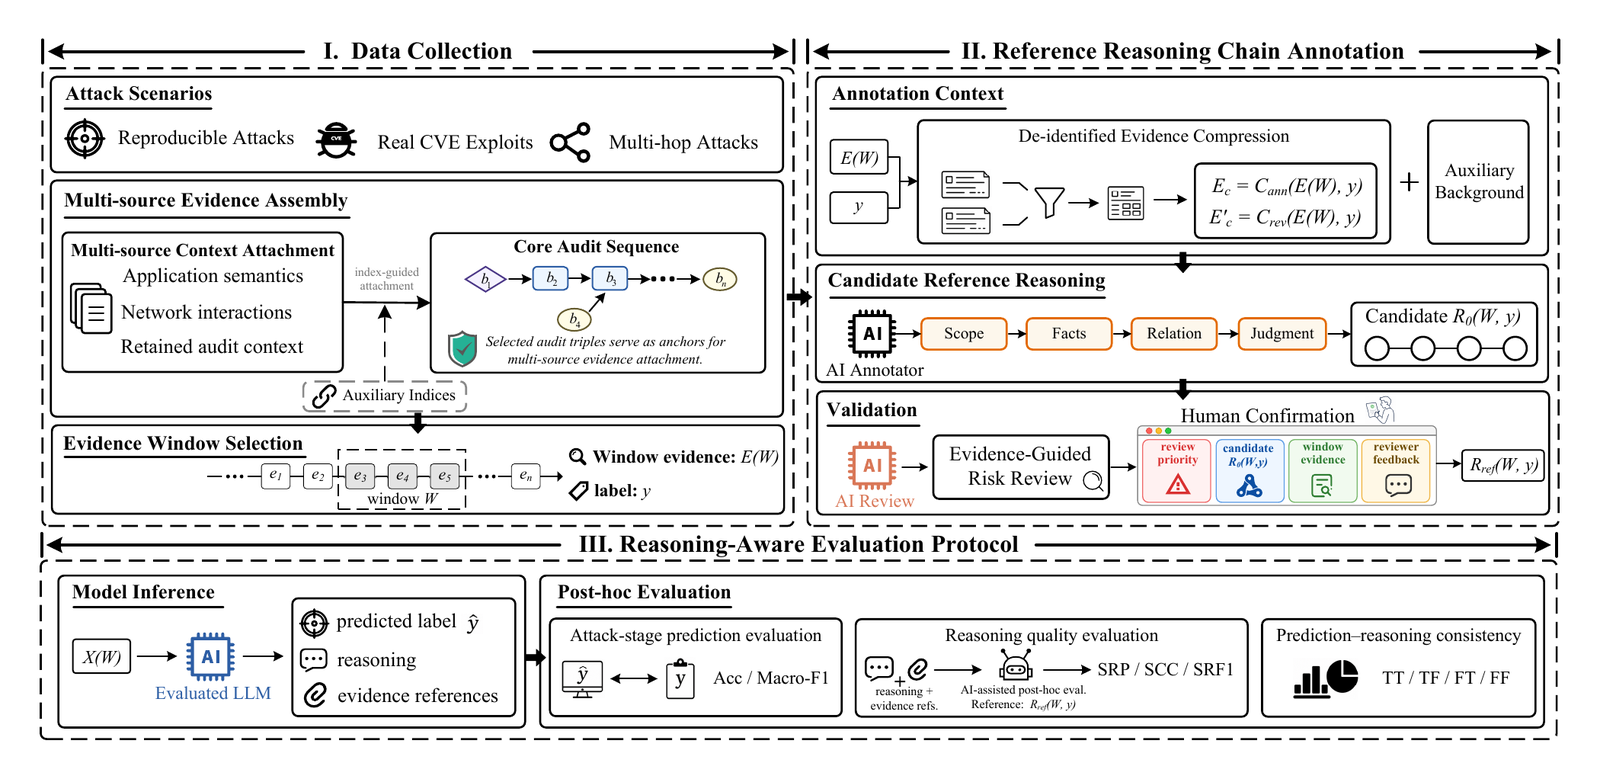
الشكل 1. نظرة عامة على SecLog. يتوافق الجزء I مع المراحل 01–04، والجزء II مع سير عمل الوسم والمراجعة في 05، والجزء III مع سير عمل التقييم في 05 باستخدام SecLog-Bench-216.
| هدفك | ابدأ من هنا | البيئة |
|---|---|---|
| قراءة مجموعة البيانات المرفقة أو إعادة استخدامها | SecLog-Bench-216 وأمثلة البيانات | أي قارئ JSONL؛ Python 3.11 للمدقّق |
| تقييم نموذج على المعيار المرفق | البدء السريع | Python 3.11؛ نقطة نهاية API ومفتاح لمشغّل الاستدلال المرفق |
| جمع سجلات جديدة وبناء مجموعة بيانات أو معيار | بناء البيانات | Ubuntu Linux، وPython 3.11، وPoetry، وDocker، وأدوات الالتقاط |
حزم النظام التفصيلية، والمكوّنات الاختيارية، وإصدارات التبعيات مدرجة في ENVIRONMENT_DEPENDENCIES.md.
تستخدم هذه الأوامر Bash وتُشغَّل من جذر المشروع. ابدأ ببيئة Python 3.11 معزولة:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
تستخدم الأوامر أدناه مكتبة Python القياسية. لجمع السجلات، والتعليقات التوضيحية، وواجهة المراجعة، والتحليل الإضافي، راجع دليل البيئة.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
يتحقق المدقق من أعداد العينات، والمعرّفات، وتوزيع التسميات، ومراجع الأدلة، وتجزئات البيان. تُبلغ عملية التحقق الناجحة عن validation_passed: true وsample_count: 216 في مخرجات JSON الخاصة بها.
استبدل your-model-name بمعرّف النموذج المدعوم من مزوّدك:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
هذا الأمر يُبلّغ عن mode: preflight_no_api وعدد المطالبات. وهو
لا يتصل بالمزوّد ولا يُنشئ ملف استجابة، ولا يتحقق
من أن المزوّد يدعم النموذج المحدد.
عيّن OPENAI_API_KEY في بيئة shell الخاصة بك، مع استبدال العنصر النائب
أدناه بمفتاح المزوّد الخاص بك، ثم فعّل استدعاءات API صراحةً:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
يستخدم المشغّل نقطة نهاية محادثة متوافقة مع OpenAI. عنوان URL الأساسي الافتراضي هو
https://api.openai.com/v1؛ مرّر --base-url لنقطة نهاية أخرى و
--api-key-env لاسم متغير مفتاح آخر. أبقِ دليل الإخراج
خارج شجرة الإصدار، كما في هذا المثال. استخدم مسار إخراج جديد لكل
تشغيل، أو أضف --resume لمتابعة ملف استجابات موجود.
لاستخدام نظام الاستدلال الخاص بك، بما في ذلك النماذج التي ترفض temperature
أو max_tokens أو وضع JSON، استخدم SecLog-Bench-216/data/prompt_pack.jsonl و
تنسيق التنبؤ، ثم مرّر
المخرجات الخام إلى المُطبِّع أدناه.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
تتضمن النتائج:
| المخرجات | المحتويات |
|---|---|
predictions.jsonl | تنبؤات النموذج المُطبَّعة |
invalid_outputs.jsonl | الاستجابات التي تعذّر تطبيعها بنجاح |
evaluation/metrics_summary.json | مقاييس التقييم المُجمَّعة |
evaluation/per_sample_results.jsonl | النتائج لكل عيّنة |
evaluation/confusion_matrix.csv | مصفوفة الالتباس لتنبؤ المرحلة |
evaluation/per_stage_metrics.csv | المقاييس حسب المرحلة |
evaluation/error_cases.jsonl | الحالات المحفوظة لتحليل الأخطاء |
يُعدّ التداخل بين المرجع والأدلة في هذا المُقيِّم تشخيصيًا. يتطلب التقييم الرسمي لجودة الاستدلال سير عمل قائمة التحقق والمراجعة المساعدة الإضافي في جودة الاستدلال اللاحق.
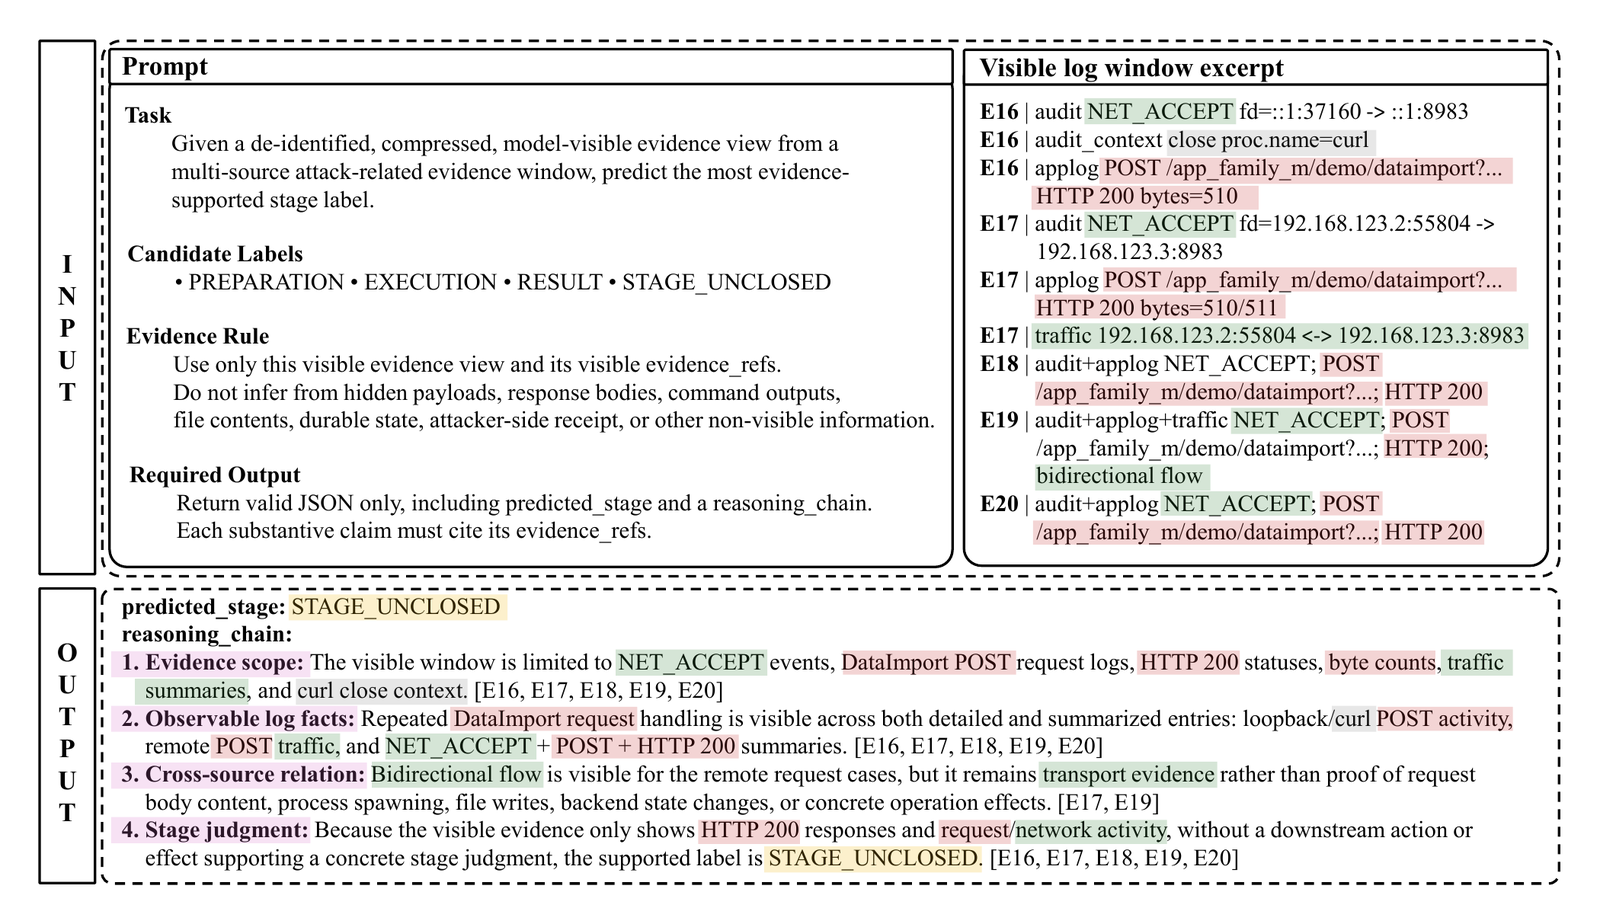
الشكل 2. مثال توضيحي. في الملفات الصادرة، تكون تسميات المراحل بأحرف صغيرة (على سبيل المثال، stage_unclosed)، وتستخدم مراجع الأدلة قيم edge_id المحلية بالعيّنة.
يستخدم المعيار صيغة JSONL: كل سطر هو كائن JSON واحد، تُجمَع عبر الملفات
بواسطة sample_id.
الملف ضمن SecLog-Bench-216/data/ | الدور |
|---|---|
evidence_windows.jsonl | الأدلة المرئية للنموذج، بما في ذلك السلسلة المختارة والسياق المرفق |
prompt_pack.jsonl | الرسائل المُعدّة لاستدلال النموذج |
gold_labels.jsonl | التسميات المُ راجَعة المستخدمة للتقييم |
reference_reasoning_chains.jsonl | الادعاءات المرجعية المُ راجَعة ومراجع الأدلة |
sample_index.jsonl | ترتيب العيّنات وبيانات النوافذ الوصفية |
dataset_manifest.json | البيانات الوصفية لمجموعة البيانات |
