 pvharmo2/gha-lab-e8902eccd3
مختبر أبحاث أمني: إعادة إنتاج CVE-2025-52467 (تنفيذ كود في سير عمل pull_request_target في pgai / استخراج GITHUB_TOKEN) — لقطة من timescale/pgai

أداة بحث آلية — ليست المشروع الأصلي.
هذا المستودع عبارة عن بيئة مختبرية مؤقتة أُنشئت بواسطة نظام آلي لأطروحة ماجستير في جامعة لافال حول إعادة إنتاج ثغرات أمنية موثقة في سير عمل GitHub Actions. وهو لقطة حرفية من
timescale/pgaiعند الالتزام2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14)، مُعاد توزيعه بموجب ترخيص المشروع نفسه، الذي يُدرج ملفه دون تغيير في هذه اللقطة.المشروع الأصلي ليس طرفًا فيه، ولا يُستهدف أبدًا، والثغرة المدروسة هنا معلنة بالفعل. كل سر ومتغير في هذا المستودع هو قيمة وهمية مولّدة عشوائيًا — لا توجد أي بيانات اعتماد حقيقية. مراجع الإجراءات وصور المشغّل مثبتة على ما حُلّت إليه في 2025-05-14؛ راجع
pinning.mdفي مخرجات النظام الآلي لكل تغيير أُجري على اللقطة.الأسئلة أو الاعتراضات: [email protected]
مكتبة Python تحوّل PostgreSQL إلى محرك استرجاع قوي وجاهز للإنتاج لتطبيقات RAG والتطبيقات الوكيلة.
🔄 إنشاء ومزامنة تلقائية للتضمينات المتجهة (vector embeddings) من بيانات PostgreSQL ومستندات S3. تتحدّث التضمينات تلقائيًا مع تغيّر البيانات.
🔍 بحث متجه ودلالي قوي باستخدام pgvector وpgvectorscale.
🛡️ جاهز للإنتاج فورًا: يدعم المعالجة المجمّعة لتوليد تضمينات فعّالة، مع معالجة مدمجة لأعطال النماذج، وحدود المعدل، وارتفاعات زمن الاستجابة.
🐘 يعمل مع أي قاعدة بيانات PostgreSQL، بما في ذلك Timescale Cloud وAmazon RDS وSupabase والمزيد.
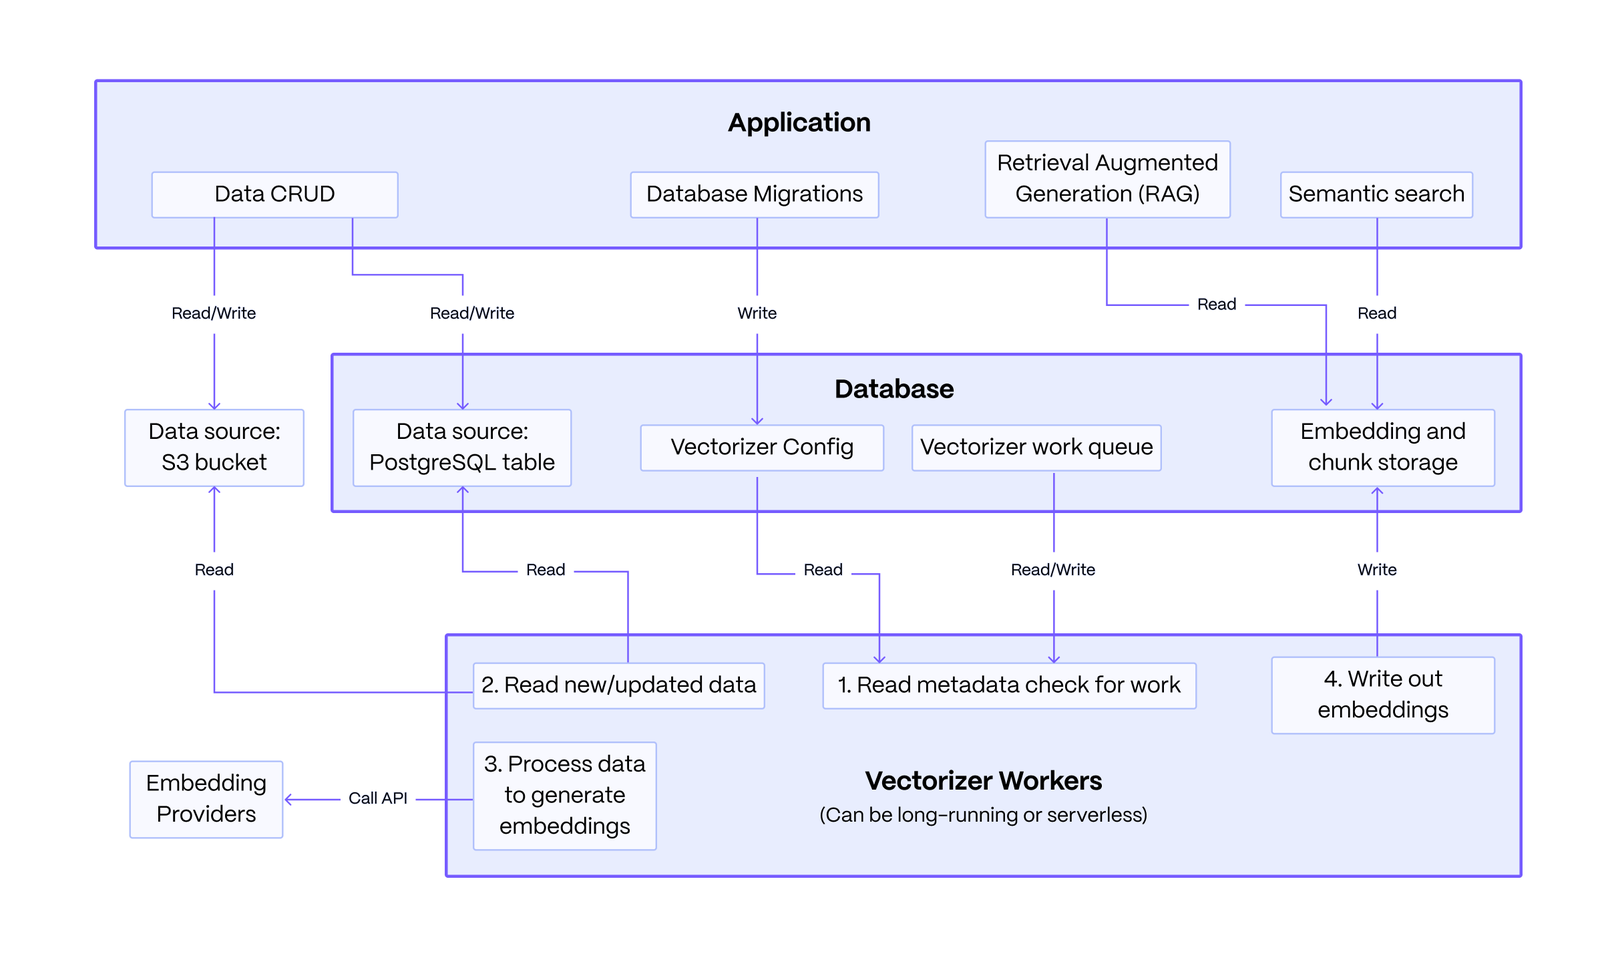
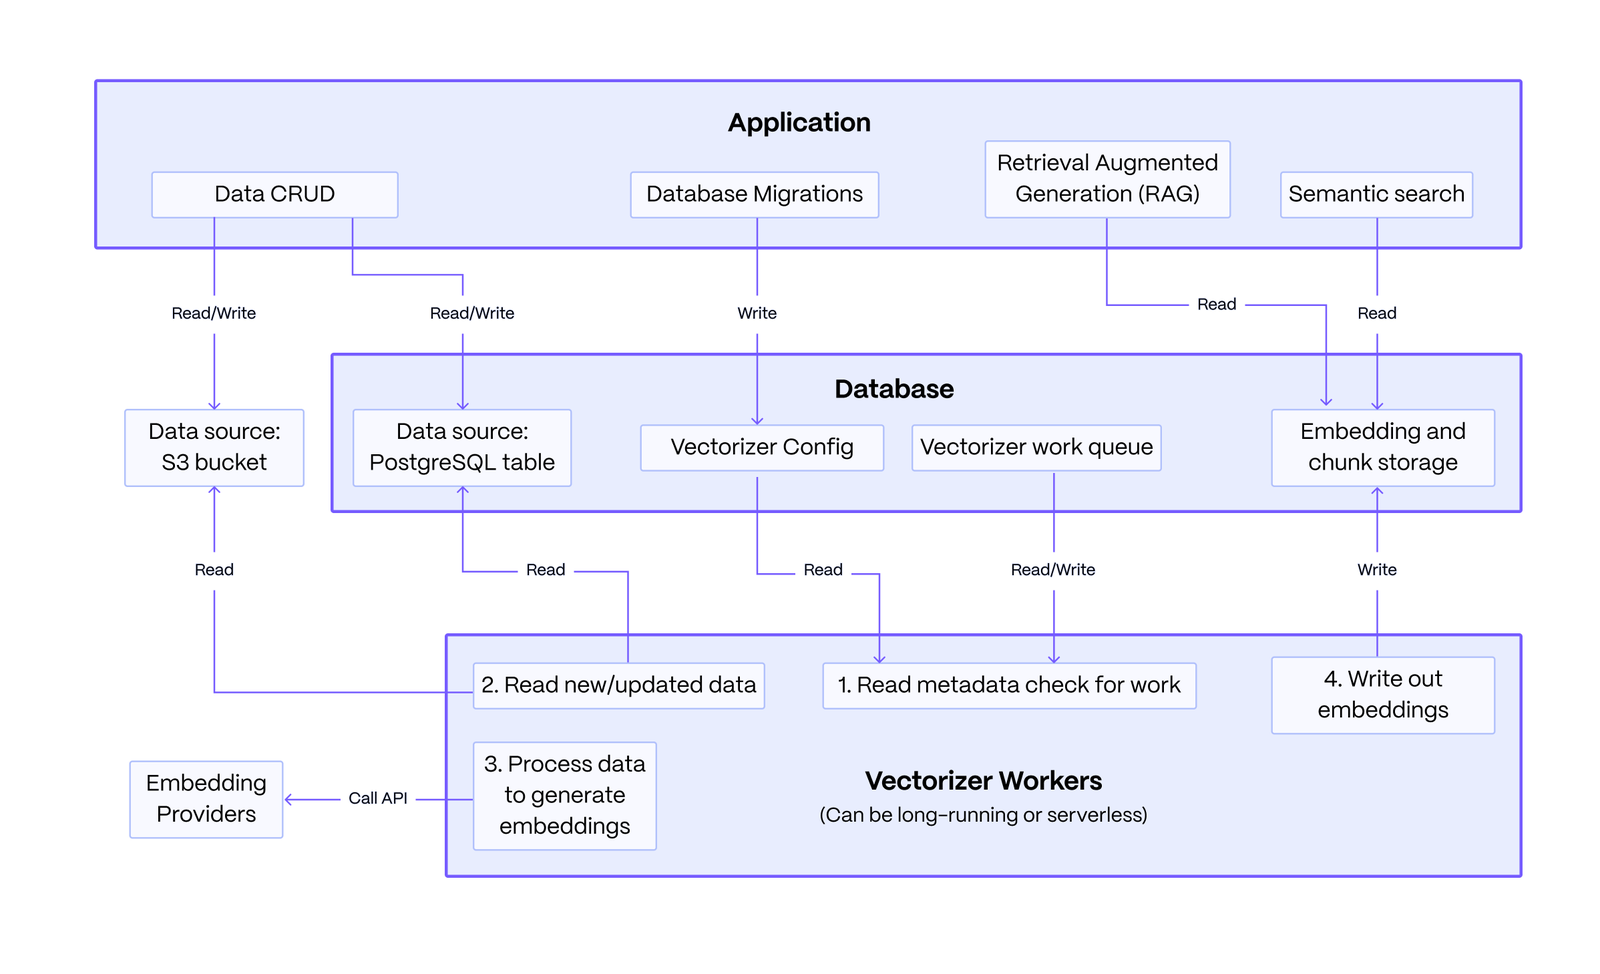
البنية الأساسية: يتكوّن النظام من تطبيق تكتبه أنت، وقاعدة بيانات PostgreSQL، وعمال توجيه متجهات (vectorizer workers) عديمي الحالة. يحدّد التطبيق إعداد توجيه المتجهات لتضمين البيانات من مصادر مثل PostgreSQL أو S3. يقرأ العمال هذا الإعداد، ويعالجون قائمة البيانات إلى تضمينات ونصوص مجزأة، ثم يكتبون النتائج مرة أخرى. يستعلم التطبيق بعد ذلك عن هذه البيانات لتشغيل RAG والبحث الدلالي.
تكمن القوة الرئيسية لهذه البنية في مرونتها: تعديلات البيانات التي يجريها التطبيق منفصلة عن عملية التضمين، ما يضمن ألا تؤثر الأعطال في خدمة التضمين على عمليات البيانات الأساسية.
أولًا، ثبّت حزمة pgai.``` pip install pgai
ثم، قم بتثبيت مكونات قاعدة بيانات pgai. يمكنك القيام بذلك من الطرفية باستخدام CLI أو في كود تطبيق Python الخاص بك باستخدام حزمة pgai الخاصة بـ Python.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
يوضح هذا الدليل السريع كيف يتيح pgai Vectorizer البحث الدلالي وRAG عبر بيانات PostgreSQL من خلال إنشاء ومزامنة التضمينات تلقائيًا مع تغيّر البيانات.
يكمن "العامل السري" الرئيسي لـ pgai Vectorizer في نهجه التصريحي لتوليد التضمينات. ببساطة، قم بتعريف خط الأنابيب الخاص بك ودع Vectorizer يتولى التعقيد التشغيلي للحفاظ على مزامنة التضمينات، حتى عندما تكون نقاط نهاية التضمين غير موثوقة. يمكنك تعريف نسخة بسيطة من خط الأنابيب كما يلي:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
سوف يقوم المُوجّه المتجهي (Vectorizer) تلقائيًا بإنشاء التضمينات (embeddings) لجميع الصفوف في
جدول `wiki`، والأهم من ذلك، سيبقي التضمينات متزامنة مع
البيانات الأساسية أثناء تغيّرها. **فكّر في الأمر تقريبًا كأنك تُعلن عن فهرس (index)** على
جدول `wiki`، ولكن بدلاً من أن تدير قاعدة البيانات بنية الفهرس
بالنيابة عنك، فإن المُوجّه المتجهي هو من يدير التضمينات.

## تشغيل البدء السريع

**المتطلبات الأساسية:**
- قاعدة بيانات PostgreSQL ([تعليمات docker](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- مفتاح API من OpenAI (نستخدم openai للتضمين في البدء السريع، ولكن يمكنك استخدام [موفّرين متعددين](#supported-embedding-models)).

أنشئ ملف `.env` يحتوي على ما يلي:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
يمكنك تنزيل كود بايثون الكامل وrequirements.txt من مثال البدء السريع وتشغيله في نفس الدليل الذي يحتوي على ملف .env.
