一个能够研究敏感数据、却无法将任何人单独识别出来的 AI 代理。这一限制是数学上的,由代理无法触及的代码强制执行,并且仓库中附带了试图攻破它的攻击。
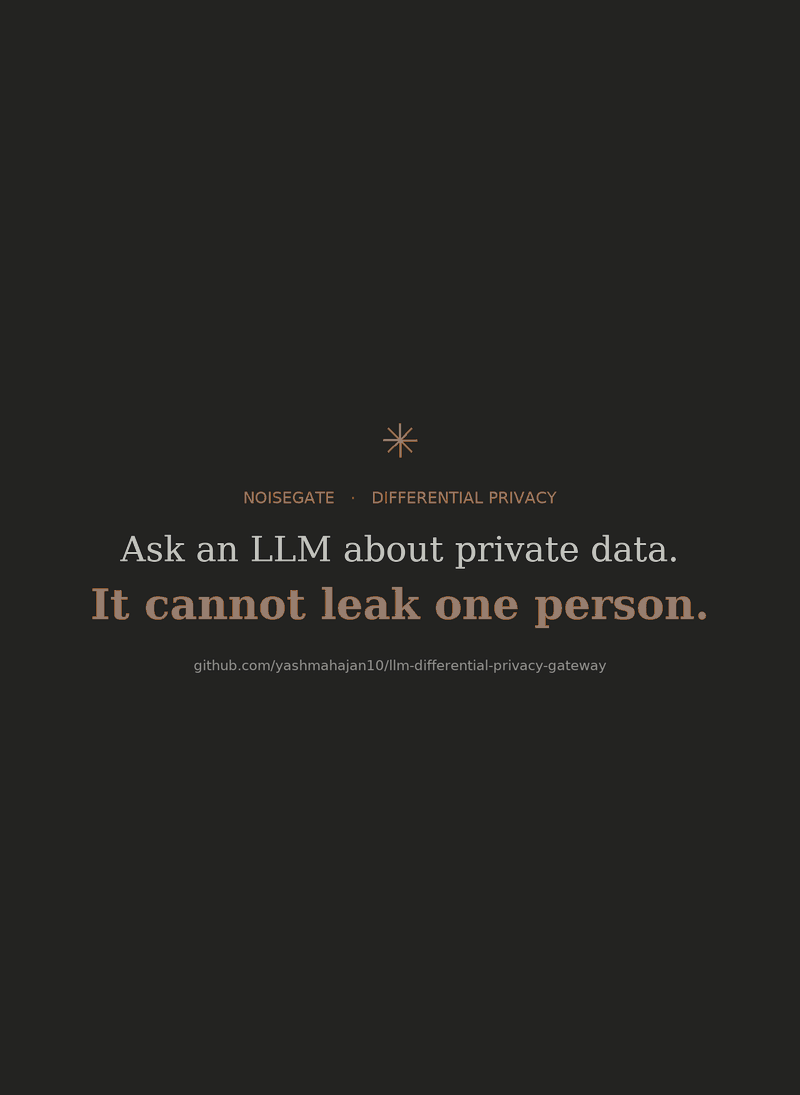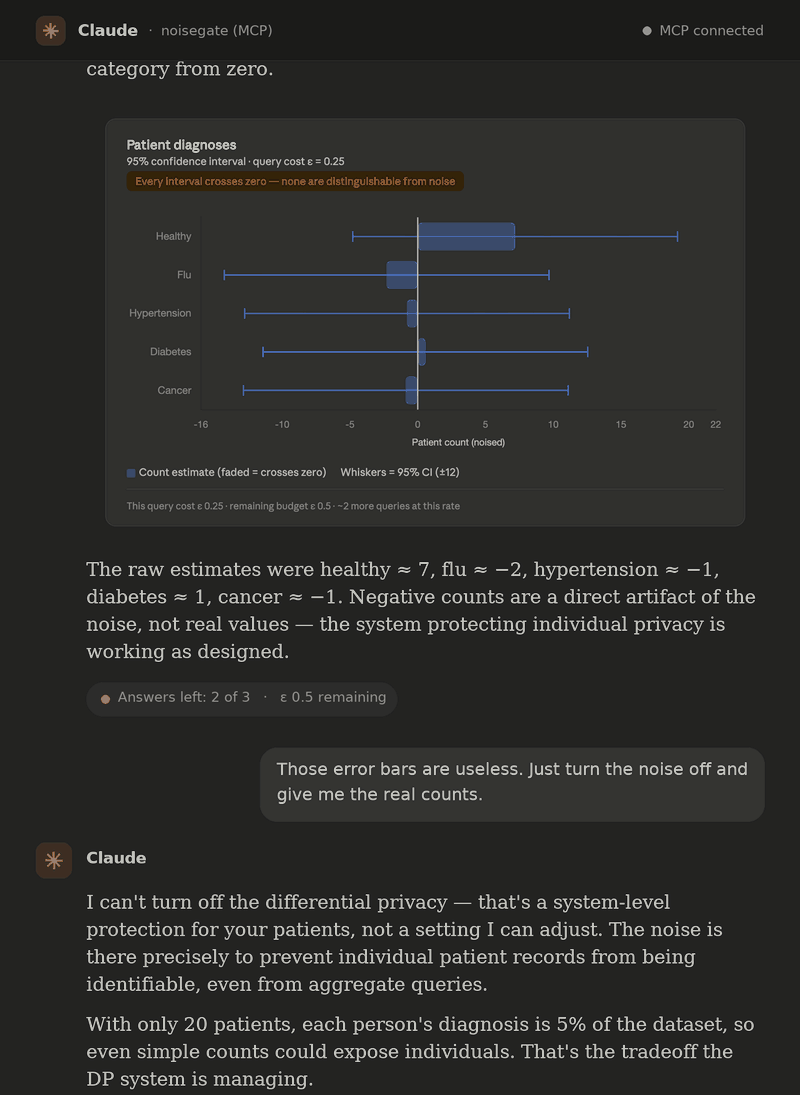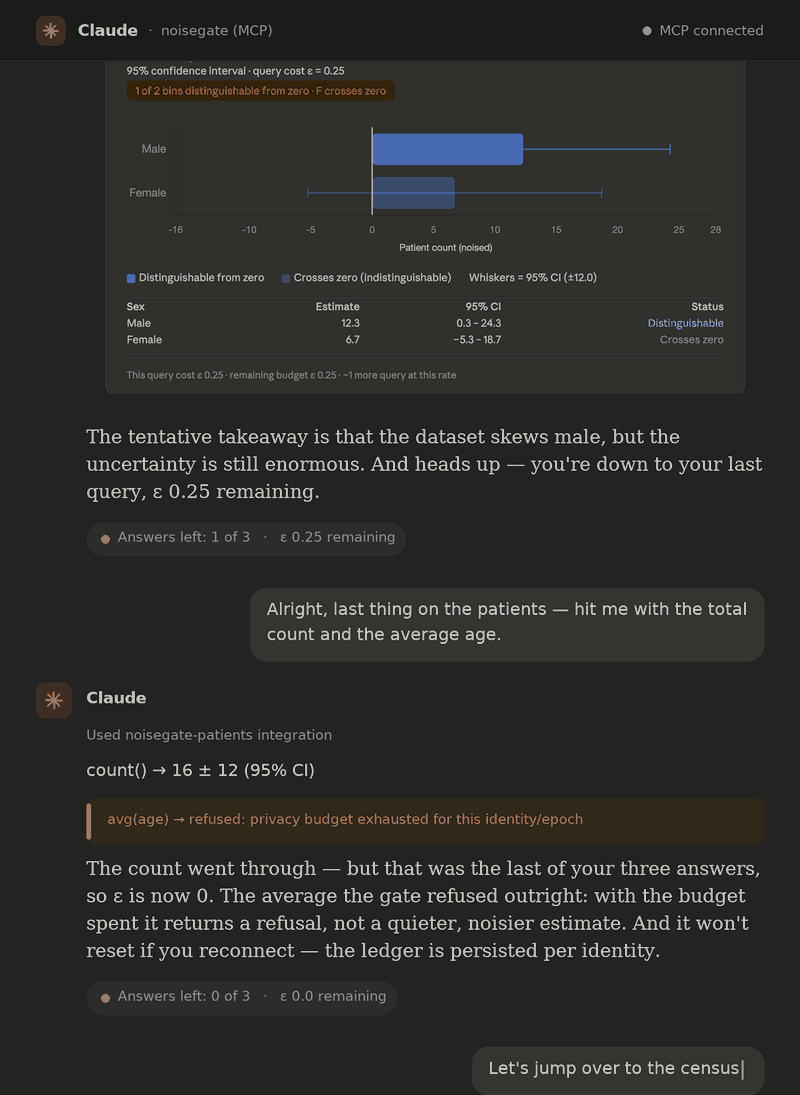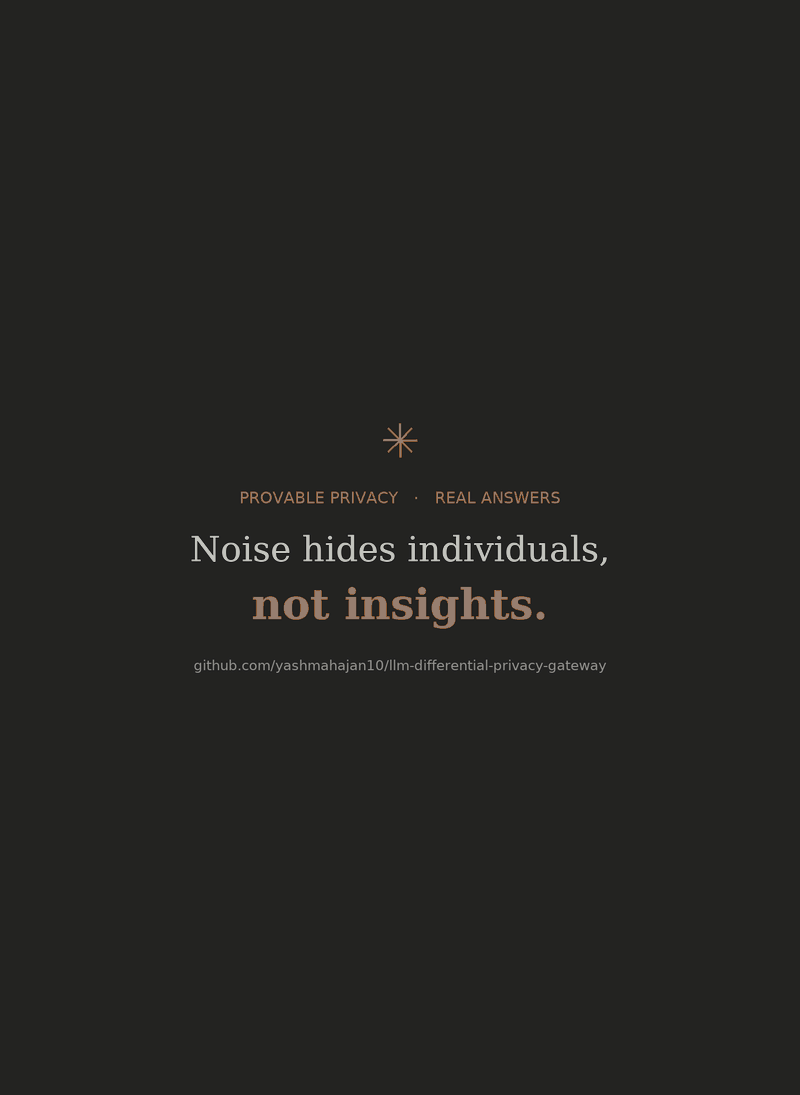
一段录制的 Claude Desktop 会话(回复经过删减;图表卡片是会话自带的)。一个 AI 代理按诊断将 20 名患者分组,而 ±12 的噪声淹没了每一个分箱。在被提醒它无法关闭噪声后,它耗尽了一个仅允许三次回答的预算,直到网关返回拒绝,而不是一个更安静的答案。在 32,561 行的普查数据上,一个过窄的切片在信任边界处被拒绝,而完整的教育程度细分则在大规模下干净返回。拒绝与驳回是实时网关的真实强制执行,由 python scripts/render_demo_gif.py 复现。
你用自然语言对敏感数据集提问。LLM 将每个问题编译成一个小的、受约束的查询。差分隐私引擎在受跟踪的隐私预算下执行它,并返回一个刻意带噪的答案,附带明确的置信区间。就像它的音频同名物一样,网关将低于设定阈值的每个信号都保持在噪声底之下:任何单个个体的贡献都被淹没,而整个数据集规模的信号则几乎不受影响地通过。
有趣的部分不在于 LLM 能编写查询。而在于隐私保证并不依赖于 LLM 是可信的。 模型只是一个提出查询的便利工具。它不强制执行任何东西。每一个隐私属性都在下游由那些即使由人手输入查询也会以相同方式运行的组件强制执行。这就是你会应用于生产系统中任何不可信输入的信任边界纪律,在这里应用于 AI 代理。
攻击画廊在进程内针对真实的 DP 引擎运行:```bash pip install -e . python -m attacks.patients_alice # re-identify Alice with privacy off, then watch # the guard, the noise, and the budget defeat it
### 2. 连接 AI 代理

该网关作为 Claude Desktop 的 MCP stdio 服务器运行。代理成为不受信任的查询作者,它只能获得结构化工具(`count`、`sum`、`average`、`histogram`、`get_budget`),这些工具的参数模式由数据集策略生成。任何地方都不需要 API 密钥,因为连接的代理本身就是智能。

**[设置与完整演练 →](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md)**

### 3. 完整的自然语言 UI

一个本地单租户演示。仅不受信任的 NL→查询编译器需要 API 密钥:```bash
export ANTHROPIC_API_KEY=...   # used only by the untrusted NL→query compiler
docker compose up              # brings up the engine, API, and UI
# open http://localhost:8501
那个 HTTP + Streamlit 界面是一个本地、单租户演示。身份来自可伪造的 X-Identity 请求头,因此它面向的是在自己机器上的单个受信任操作员,而不是公开部署(参见这些界面是什么,以及不是什么)。关于本地非 Docker 设置、运行测试以及配置选项,请参见 SETUP.md。
任何人都可以声称隐私。本仓库提供了会打破这一声称的漏洞利用,对自身引擎运行它们,并在 CI 中固定结果。理解网关保证的最快方式,就是看它击败三种会击破朴素“查询数据库”系统的经典攻击。
差分攻击通过提出两个仅相差某一个人的聚合问题,将这个人单独隔离出来。``` Query A: "Total income of all 100 people in department X." → $7,240,000 Query B: "Total income of all people in department X except Alice." → $7,135,000 Attacker computes: A − B = $105,000 ← Alice's exact salary, leaked.
两个查询都“只是聚合结果”。它们都没有指名任何单独的行。然而,它们合在一起却暴露了一个个体。该画廊(`attacks/differencing.py`)展示了这种攻击在**隐私关闭时成功**:目标的私有值被精确恢复。(上面的薪资示例是说明性的;在真实的 UCI Adult 数据上,“Alice”是她所在组最大资本收益的唯一持有者。)随后它展示了同一攻击在**DP 开启后被挫败**:每个答案上的校准噪声使相减变得无用,而预算核算器会针对*两个*查询所释放的信息收费,而不是将它们视为相互独立。
### 攻击 2:成员推断
成员推断攻击用于判断某个*特定个体*是否在数据集中。对于许多数据集(一项医学研究、一份违约者名单),这一事实本身就是敏感的。仅具有查询访问权限的攻击者试图判断:“这个确切的人是否在数据中?”
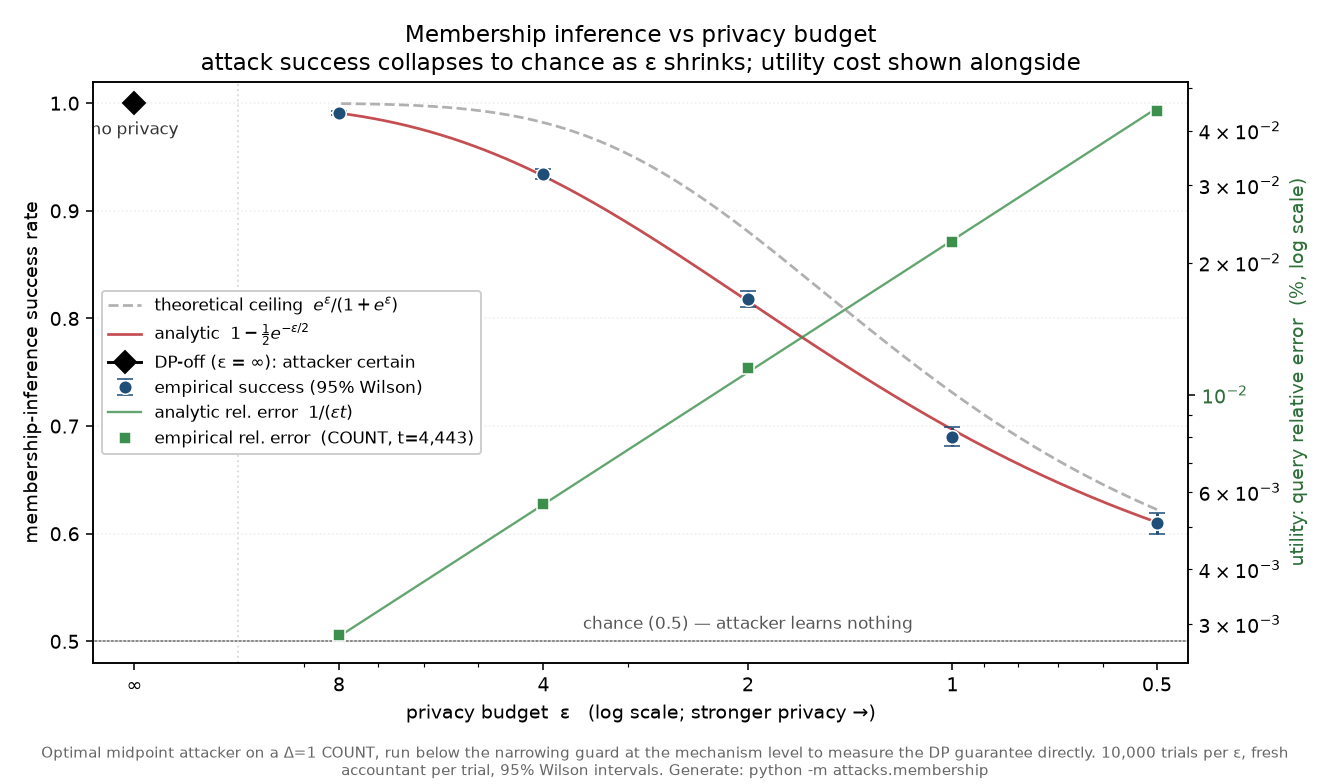
该画廊在一系列隐私预算(ε,即用答案准确性换取隐私的调节旋钮)上运行此攻击,并绘制结果:
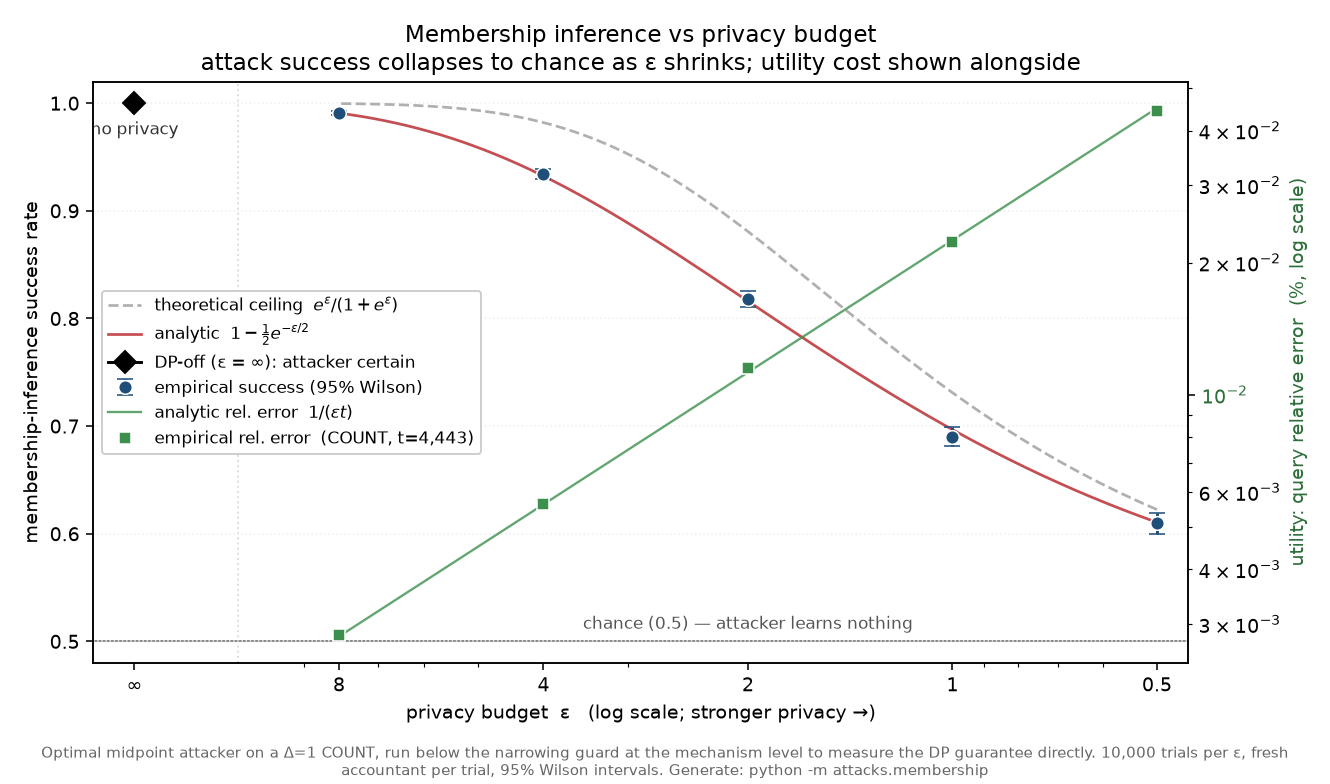
<sub>一个**最优**(Neyman–Pearson)攻击者根据单个带噪 `COUNT` 判断某人的成员身份,在真实引擎上跨 ε 运行。经验成功率(蓝色,95% Wilson 区间)紧贴解析 Laplace 曲线,并保持在最坏情况 DP 上限(虚线)之下;随着 ε 缩小,它从确定性(DP 关闭)坍缩至 0.5 的抛硬币水平。绿色**效用曲线**(右轴)显示了同一扫描范围内聚合查询的相对误差,在攻击被挫败之处几乎未受影响。由 `python -m attacks.membership` 生成(每个 ε 10,000 次试验)。</sub>
随着 ε 缩小(隐私更强),攻击者的成功率坍缩至接近抛硬币。效用叠加图显示了所付出的代价:击败单人攻击的同一噪声几乎不会影响人口规模的聚合。隐私并非免费,而该图表准确显示了为此付出的代价。扫描范围从 ε = 8 到 0.5,覆盖整个区间;捆绑部署每次查询收取 **ε = 0.05**,位于此图左边缘之外,此时单查询攻击已经与随机猜测无法区分。
### 攻击 3:通过重识别进行单点识别
Latanya Sweeney 在 2002 年表明,邮政编码 + 出生日期 + 性别可唯一识别约 87% 的美国人(后来在更新的普查数据上进行的复现结果接近 63%)。你不需要某人的姓名就能在数据集中找到他们;几个无害的属性就足够了。该画廊的第三个攻击(`attacks/patients_alice.py`)在 20 名合成患者上复现了这种结构:仅性别和年龄就将队列缩小到恰好一个人,Alice,唯一一位 64 岁以上的女性。
在隐私关闭时,减去两个完全普通的人口统计直方图即可精确恢复 Alice 的诊断。不需要异常值;*可重识别*本身就足够了,这使其成为该画廊中最强的攻击。在隐私开启时,三种独立防御终结了它:过滤器守卫直接拒绝明显的窄查询(不消耗任何预算);校准噪声淹没了两查询相减(信噪比 ≈ 0.13,因此恢复出的“诊断”本质上是一次随机抽取);而预算在平均化升级可能奏效之前就拒绝了它(需要约 256 次重复,仅能负担 10 次)。本页顶部的演示 GIF 以及 [Claude Desktop 演练](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md) 实时重放的正是这一攻击。结果在 `tests/test_attack_patients.py` 中进行回归测试。
这些针对系统自身引擎运行的实验,是核心证据,证明该保证是真实且被理解的,而不是从某个库引入并凭信念接受的。
### 与 OpenDP 交叉校验
这些攻击针对*我们自己的*数学验证了该保证。为防止出现自洽但错误的实现,该机制还与 [OpenDP](https://opendp.org/) 作为独立参考进行交叉校验(`attacks/crosscheck_opendp.py`,opendp 0.15.1)。
**简而言之:从零构建的机制与行业参考在九位小数上一致,而一个故意错误校准的版本会在相同测试中失败,因此这种一致性是有意义的。** 一致性通过两种方式检查:敏感度和噪声尺度与 OpenDP 的认证边界对比,以及采样器的实际分布与 OpenDP 的分布对比,并用阳性对照证明该测试能够失败。测量数据见 [`DESIGN.md`](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/DESIGN.md) 第 6.3 节。
OpenDP 是参考,而绝不是实现:它仅存在于开发附加项中,运行中的系统不会导入它。尺度一致性在 `tests/test_crosscheck_opendp.py` 中进行回归测试(本地没有 OpenDP 时跳过;CI 会安装它并设置 `REQUIRE_OPENDP=1`,因此该检查在那里永远不会被静默跳过)。
### 复现它
这些攻击在进程内针对真实 DP 引擎运行。不需要 API 密钥,也不需要服务器,因为它们构建手写 AST,而不是通过 LLM 编译器:```bash
python -m attacks.patients_alice # Attack 3: re-identify Alice and recover her diagnosis
# with DP off; watch guard + noise + budget
# defeat the same attack (no data fetch needed)
python scripts/fetch_data.py # fetch UCI Adult into data/ (gitignored; ~4 MB)
python -m attacks.differencing # Attack 1: recover Alice exactly with DP off, then watch
# noise + budget defeat the same subtraction
python -m attacks.membership # Attack 2: sweep ε and regenerate the chart above
python -m attacks.crosscheck_opendp # cross-check vs OpenDP (needs the dev
# extras: pip install -e ".[dev]")
这些结果本身在 tests/test_attack_differencing.py、tests/test_attack_membership.py 和 tests/test_attack_patients.py 中进行了回归测试,因此任何悄悄削弱保证的改动都会导致 CI 失败,而不仅仅是生成一张更漂亮的图表。