vincentkaufmann/noapi-google-search-mcp
用于Google搜索和页面抓取的MCP服务器,使用headless Chromium

如果您想支持 noapi-google-mcp 或 gpt-oss-20B/120B-Vision 及其他即将推出的开源模型,请为我的 GPU 计算基金捐款:大约需要 3000 美元。
如果您觉得这个工具有用,请考虑支持持续开发和新增功能。
BTC:16DT4AHemLyn7C6P116YepjY518gu9wUUH
ETH:
0x7287D1F9c77832cFF246937af0443622bFdACD04
38 个工具。零 API 密钥。为任何本地 LLM 提供真正的 Google 搜索、实时信息流、视觉、OCR 和完整视频理解。
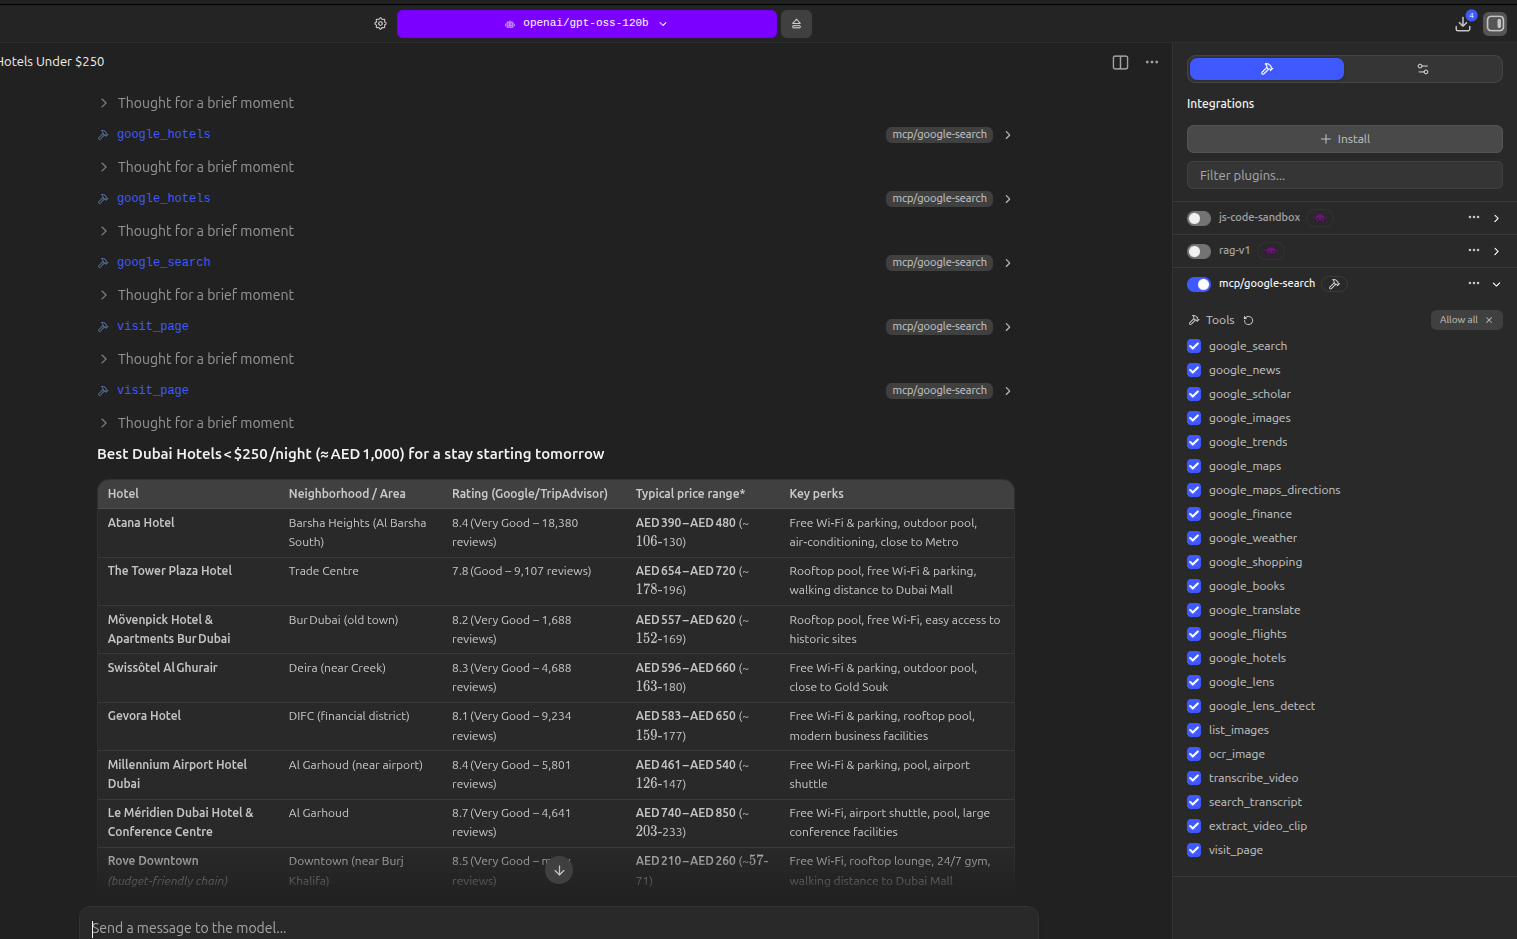
一个将您的本地 LLM 变为全功能助手的 MCP 服务器。真正的 Google 搜索结果、实时新闻和社交信息流、反向图像搜索、离线 OCR、YouTube 转录和片段提取——全部通过无头 Chromium 和开源机器学习模型在本地运行。无需 API 密钥、无使用限制、无云端依赖。
可与 LM Studio、Claude Desktop、OpenClaw、Ollama 以及任何兼容 MCP 的客户端配合使用。
Google 开始检测无头 Chromium 浏览器并显示 CAPTCHA 替代搜索结果(#2)。已正确修复此问题,随后又添加了一个神经网络 CAPTCHA 求解器,纯粹出于好玩。
隐形补丁:
navigator.webdriver、伪造浏览器插件、chrome.runtime,并移除 Playwright 指纹aarch64,现在匹配实际 Chromium 二进制文件)神经网络 CAPTCHA 求解器(MobileNetV2 + OpenCV):
它能解决所有 CAPTCHA 吗?不能。但它能通过其中一些,说实话我们构建它主要是因为我们可以。
一个完整的本地检索增强生成流水线,适用于 YouTube。订阅任意频道,当您检查信息流时,服务器会自动下载音频,使用 Whisper 进行转录,并将完整转录文本存储到支持 FTS5 全文搜索的 SQLite 中。每个视频中的每一个词都可被搜索——让您的 LLM 提出一个问题,它就能从相关视频中提取答案。
发现了感兴趣的内容?让 LLM 将该片段提取为剪辑。它会读取转录文本,找到精确的时间戳,然后为您裁剪视频。这是 AI/LLM 驱动的视频编辑的开端——您的 LLM 理解内容,并根据所说的话(而不仅仅是时间戳)来裁剪剪辑。
工作原理:
subscribe 订阅一个 YouTube 频道——通过句柄(@3Blue1Brown)、URL 或频道 IDcheck_feeds——新视频会被获取并在本地使用 faster-whisper 自动转录。转录文本被写入数据库以实现即时搜索。每次检查最多处理 5 个视频,并带有缓存以避免重复下载。search_feeds——跨所有转录文本进行全文搜索。支持 AND、OR、NOT 以及带引号的短语。您的 LLM 能找出回答您问题的确切视频和段落。extract_video_clip——告诉 LLM 您对什么感兴趣,它将从视频中裁剪出该片段。LLM 使用转录文本定位正确片段并自动提取。```
"Subscribe to @AndrejKarpathy on YouTube"
"Check my feeds"
"Search my feeds for backpropagation explained"
"What did Karpathy say about tokenization?"
"Extract the part where he explains gradient descent"
"Cut a clip of the hardware comparison section"无需嵌入、无需向量数据库、无需API——只需在你机器上运行的Whisper + SQLite FTS5。
> **路线图:** 片段提取是迈向完全AI驱动视频编辑的第一步。未来版本将添加音乐/音频叠加、视频混剪、多片段合成、为TikTok/Reels/Shorts的竖屏格式转换,以及自动精彩集锦——所有这些都由你的LLM理解内容来驱动。
---
### 实时订阅源
订阅新闻、Reddit、Hacker News、YouTube频道、Twitter/X账号、GitHub仓库、arXiv论文和播客。内容会被抓取并本地存储在SQLite中,支持全文搜索,LLM可即时访问。
| 新工具 | 功能说明 |
|----------|-------------|
| `subscribe` | 添加任何来源——新闻RSS、Reddit、HN、GitHub、arXiv、YouTube、播客、Twitter/X |
| `unsubscribe` | 移除一个订阅及其存储的内容 |
| `list_subscriptions` | 查看所有活跃订阅源及其条目数量 |
| `check_feeds` | 轮询所有订阅源,抓取新内容,自动转录YouTube视频 |
| `search_feeds` | 对订阅源收集的所有内容进行全文搜索 |
| `get_feed_items` | 浏览最近的条目,可按来源或类型筛选 |
**预配置的新闻源** —— 一个词即可订阅:`bbc`、`cnn`、`nyt`、`guardian`、`npr`、`aljazeera`、`techcrunch`、`ars`、`verge`、`wired`、`reuters`
**arXiv快捷方式** —— `ai`、`ml`、`cv`、`nlp`、`robotics`、`crypto`、`systems`、`hci````
"Subscribe to BBC News, r/LocalLLaMA, and Hacker News"
"Follow @elonmusk on Twitter"
"Subscribe to the YouTube channel @3Blue1Brown"
"Watch anthropics/claude-code on GitHub for new releases"
"Subscribe to the machine learning arXiv category"
"Check my feeds"
"Search my feeds for transformer architecture"
"What's new in my Reddit feeds?"
转录会议、转换格式、读取文档——全部本地处理,无需云端。
| 新工具 | 功能 |
|---|---|
transcribe_local | 使用Whisper转录任何本地音频或视频文件(mp3, wav, mp4, mkv等) |
convert_media | FFmpeg格式转换——视频转音频、格式互转、视频转GIF |
read_document | 从PDF、DOCX、HTML、CSV、JSON以及30多种文本格式中提取文字 |
拉取邮件、生成二维码、缩短链接、存档页面、查询维基百科、上传至S3。
| 新工具 | 功能 |
|---|---|
fetch_emails | 通过IMAP拉取邮件——Gmail、Outlook、Yahoo以及任何IMAP服务器 |
paste_text | 将文本发布到pastebin并获取可分享链接 |
shorten_url | 通过TinyURL缩短任意URL |
generate_qr | 为URL、Wi-Fi、联系人等任何数据生成二维码图像 |
archive_webpage | 将网页快照保存到Wayback Machine |
wikipedia | 查询任何语言、任何维基百科条目,支持摘要 |
upload_to_s3 | 上传文件到MinIO、AWS S3、DigitalOcean Spaces、Cloudflare R2 |
| "Transcribe this recording: ~/meeting.mp3" | |
| "Convert video.mp4 to mp3" | |
| "Read this PDF: ~/report.pdf" | |
| "Check my email: [email protected] password: xxxx" | |
| "Shorten this URL: https://very-long-url..." | |
| "Generate a QR code for https://mysite.com" | |
| "Archive this article: https://news.example.com/story" | |
| "Wikipedia: quantum computing" | |
| "Upload report.pdf to my MinIO bucket" |
**订阅源零额外依赖。** 完全基于 Python 标准库构建——SQLite 用于存储,FTS5 用于搜索,urllib 用于获取,xml.etree 用于解析。YouTube 和 Twitter 使用已有的 Playwright 浏览器。`convert_media` 需要 FFmpeg(通常已预装)。

---

## 所有 38 个工具按类别分类

### 实时订阅源
| 工具 | 描述 |
|------|------|
| `subscribe` | 订阅新闻、Reddit、HN、GitHub、arXiv、YouTube、播客、Twitter/X |
| `unsubscribe` | 移除订阅及其存储内容 |
| `list_subscriptions` | 列出所有活跃订阅及其项目数量 |
| `check_feeds` | 从所有或特定源获取新内容 |
| `search_feeds` | 对所有存储的订阅内容进行全文搜索 |
| `get_feed_items` | 按源或类型筛选获取最近项目 |

### Google 搜索与 Web
| 工具 | 描述 |
|------|------|
| `google_search` | 带时间筛选、站点筛选、分页、语言/区域的 Web 搜索 |
| `google_news` | 新闻搜索,内联显示文章缩略图 |
| `google_scholar` | 学术论文,含引用 |
| `google_images` | 图片搜索,结果在聊天中内联显示 |
| `google_trends` | 主题随时间热度、相关查询 |
| `visit_page` | 获取任意 URL 并提取可读文本 |

### 旅行与商业
| 工具 | 描述 |
|------|------|
| `google_shopping` | 产品搜索,含价格、商店、评分、图片 |
| `google_flights` | 航班搜索,含价格和旅行时间 |
| `google_hotels` | 酒店搜索,含图片、价格、评分、预订 URL |
| `google_translate` | 支持 100+ 种语言翻译 |
| `google_maps` | 地点搜索,含评分、评论和地图截图 |
| `google_maps_directions` | 路线导航,含逐步指示和地图截图 |

### 金融与信息
| 工具 | 描述 |
|------|------|
| `google_finance` | 股票价格、市场数据、公司信息 |
| `google_weather` | 当前天气状况和未来多天预报 |
| `google_books` | 图书搜索,含作者、ISBN、摘要 |

### 视觉与 OCR
| 工具 | 描述 |
|------|------|
| `google_lens` | 反向图片搜索——识别物体、产品、地标、文字 |
| `google_lens_detect` | 检测图像中的所有物体(OpenCV),并通过 Lens 识别每个物体 |
| `ocr_image` | 本地从图像中提取文字(RapidOCR,完全离线) |
| `list_images` | 列出目录中的图片文件,供视觉工具使用 |

### 视频与音频智能——AI 驱动的视频编辑
| 工具 | 描述 |
|------|------|
| `transcribe_video` | 下载并转写任意视频,带时间戳(faster-whisper) |
| `transcribe_local` | 转写本地音频/视频文件(mp3, wav, m4a, mp4, mkv 等) |
| `search_transcript` | 按关键词在转写后的视频中搜索主题 |
| `extract_video_clip` | AI 驱动的剪辑提取——告诉 LLM 你想要什么,它会根据转写上下文切割视频 |
| `convert_media` | 通过 FFmpeg 转换音视频格式 |

### 文档与数据
| 工具 | 描述 |
|------|------|
| `read_document` | 从 PDF、DOCX、HTML、CSV、JSON 及 30+ 种格式中提取文本 |

### 电子邮件
| 工具 | 描述 |
|------|------|
| `fetch_emails` | 通过 IMAP 拉取邮件——Gmail、Outlook、Yahoo、iCloud、任意 IMAP 服务器 |

### Web 工具
| 工具 | 描述 |
|------|------|
| `paste_text` | 将文本发布到 pastebin 并获取可分享的 URL |
| `shorten_url` | 通过 TinyURL 缩短任意 URL |
| `generate_qr` | 生成二维码图像(URL、Wi-Fi、联系人、任意数据) |
| `archive_webpage` | 在 Wayback Machine 上存档网页 |
| `wikipedia` | 任意语言的维基百科文章查询 |

### 云存储
| 工具 | 描述 |
|------|------|
| `upload_to_s3` | 上传文件到 MinIO、AWS S3、DigitalOcean Spaces、Cloudflare R2、Backblaze B2 |

---

## 支持的文件格式

### 文档 (`read_document`)
| 类别 | 格式 |
|------|------|
| 文档 | PDF(扫描页面有 OCR 后备)、DOCX |
| Web | HTML, HTM |
| 数据 | CSV, JSON, XML, YAML, YML, TOML |
| 文本 | TXT, MD, LOG |
| 配置 | INI, CFG, CONF, ENV |
| 代码 | PY, JS, TS, GO, RS, C, CPP, H, JAVA, KT, RB, SQL, R, M, SWIFT |
| Shell | SH, BASH, ZSH |

### 音频与视频 (`transcribe_local`, `transcribe_video`, `convert_media`)
| 类别 | 格式 |
|------|------|
| 音频 | MP3, WAV, M4A, FLAC, OGG, AAC, WMA, OPUS |
| 视频 | MP4, MKV, WEBM, AVI, MOV |
| 特殊 | GIF(视频转 GIF 输出) |
| 输入 | FFmpeg 能解码的任何格式(上百种格式) |