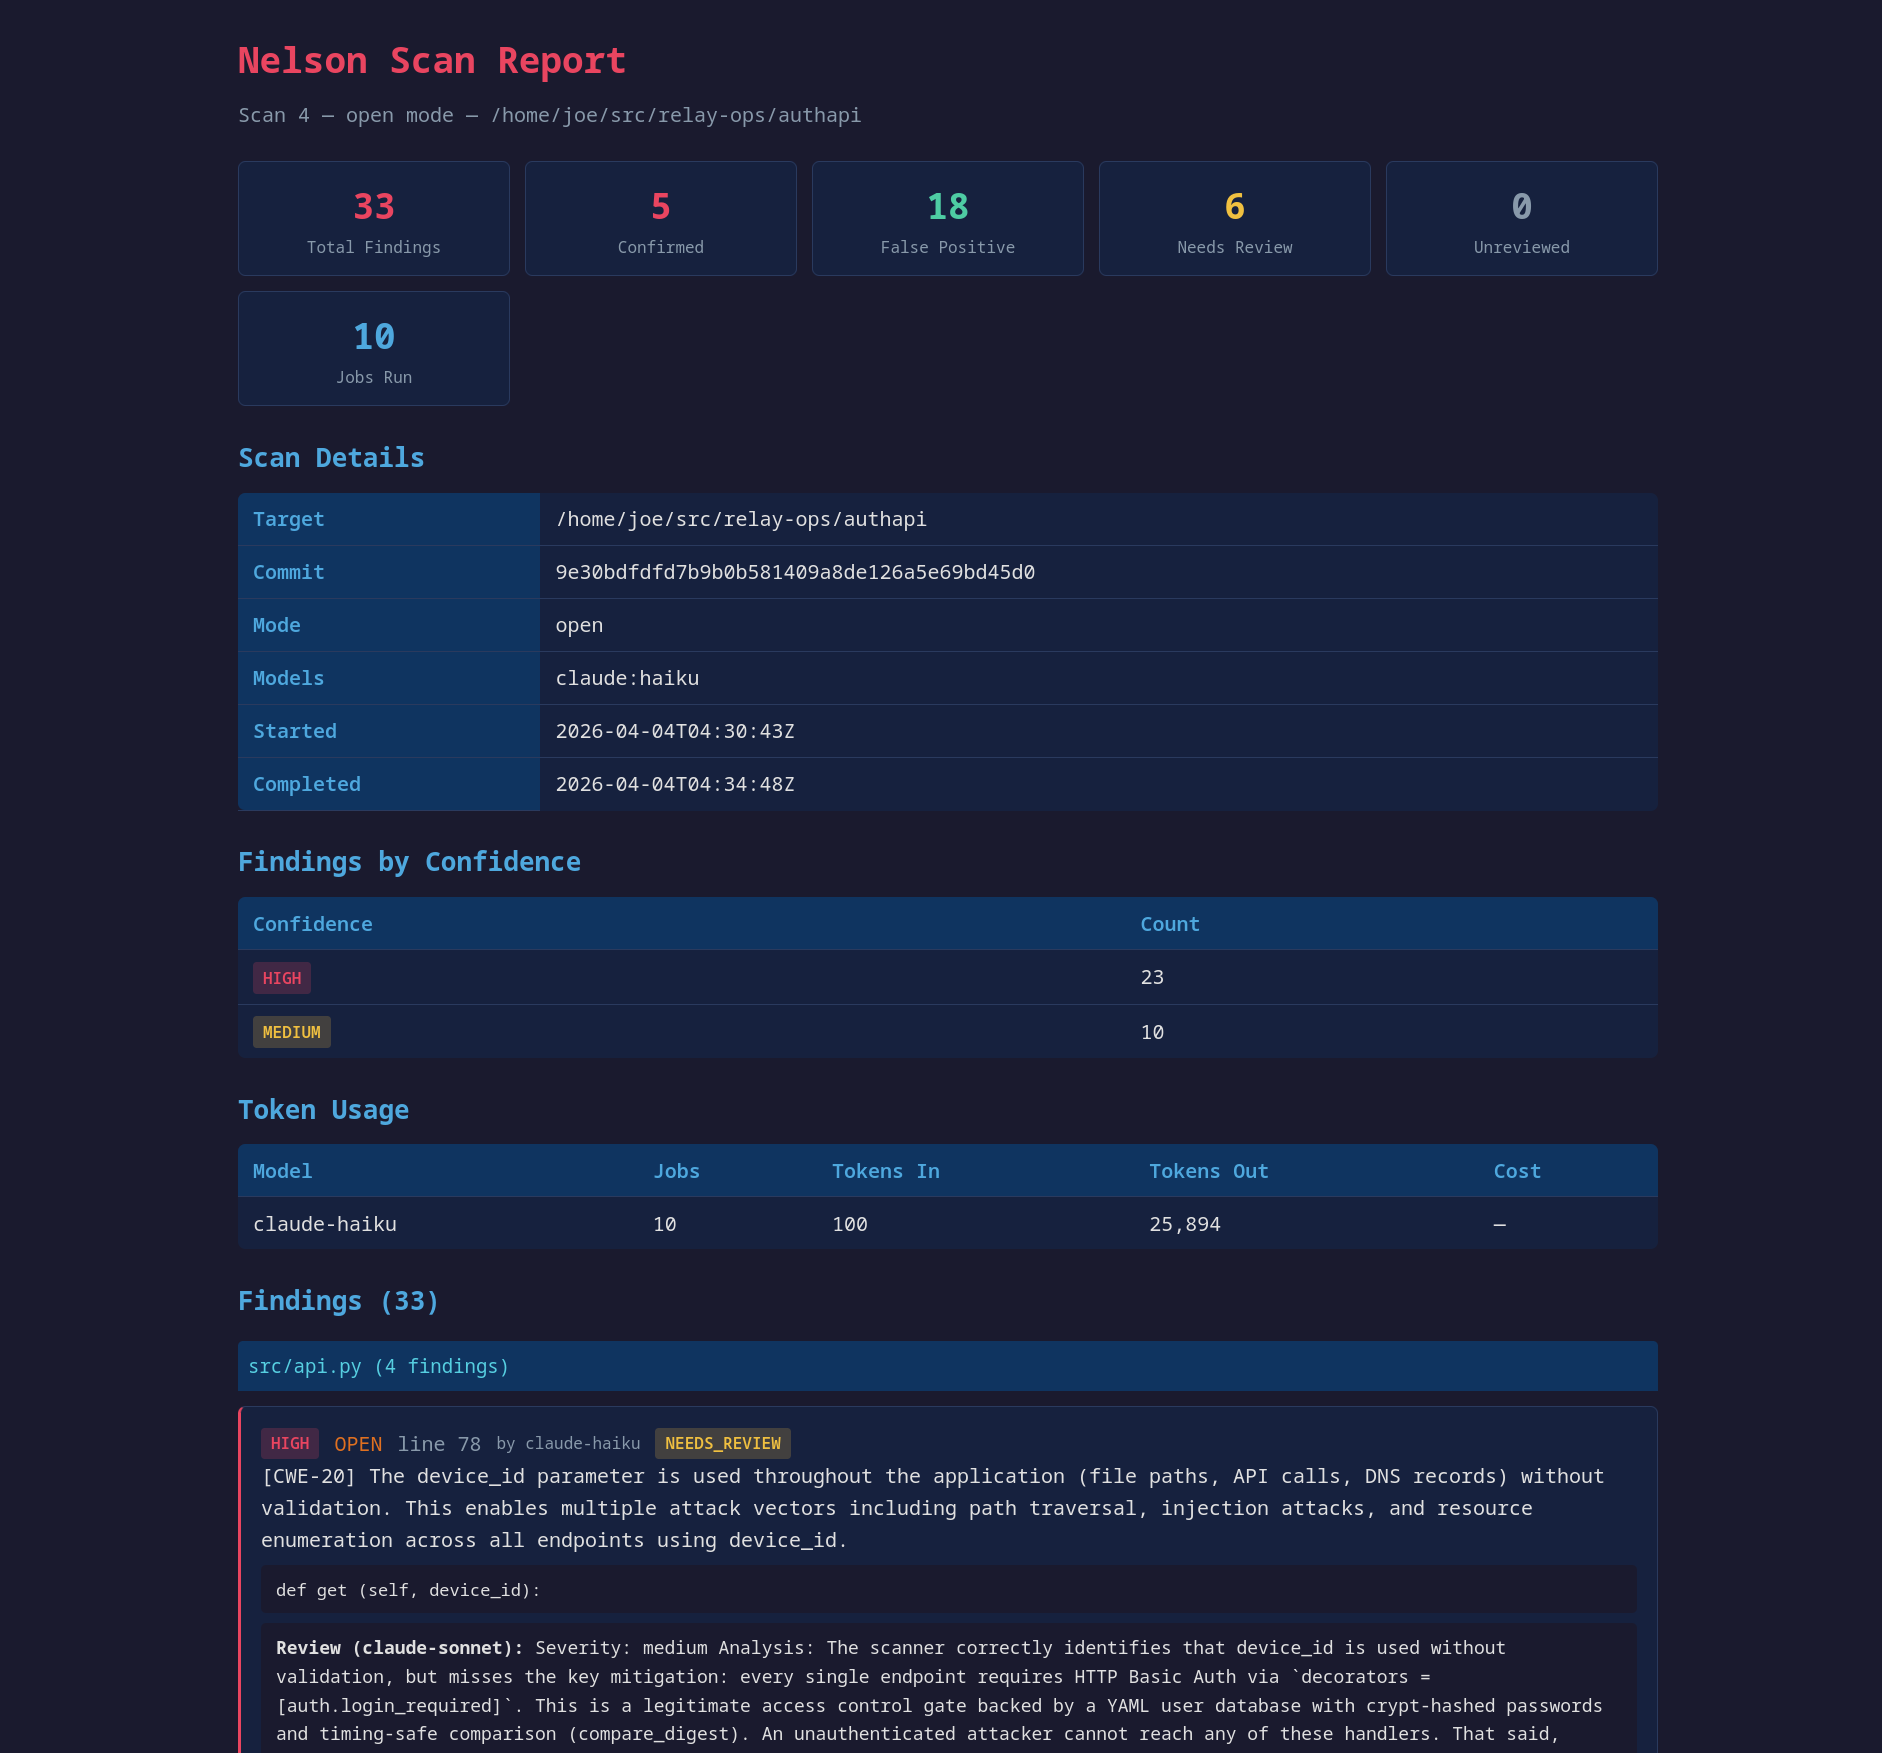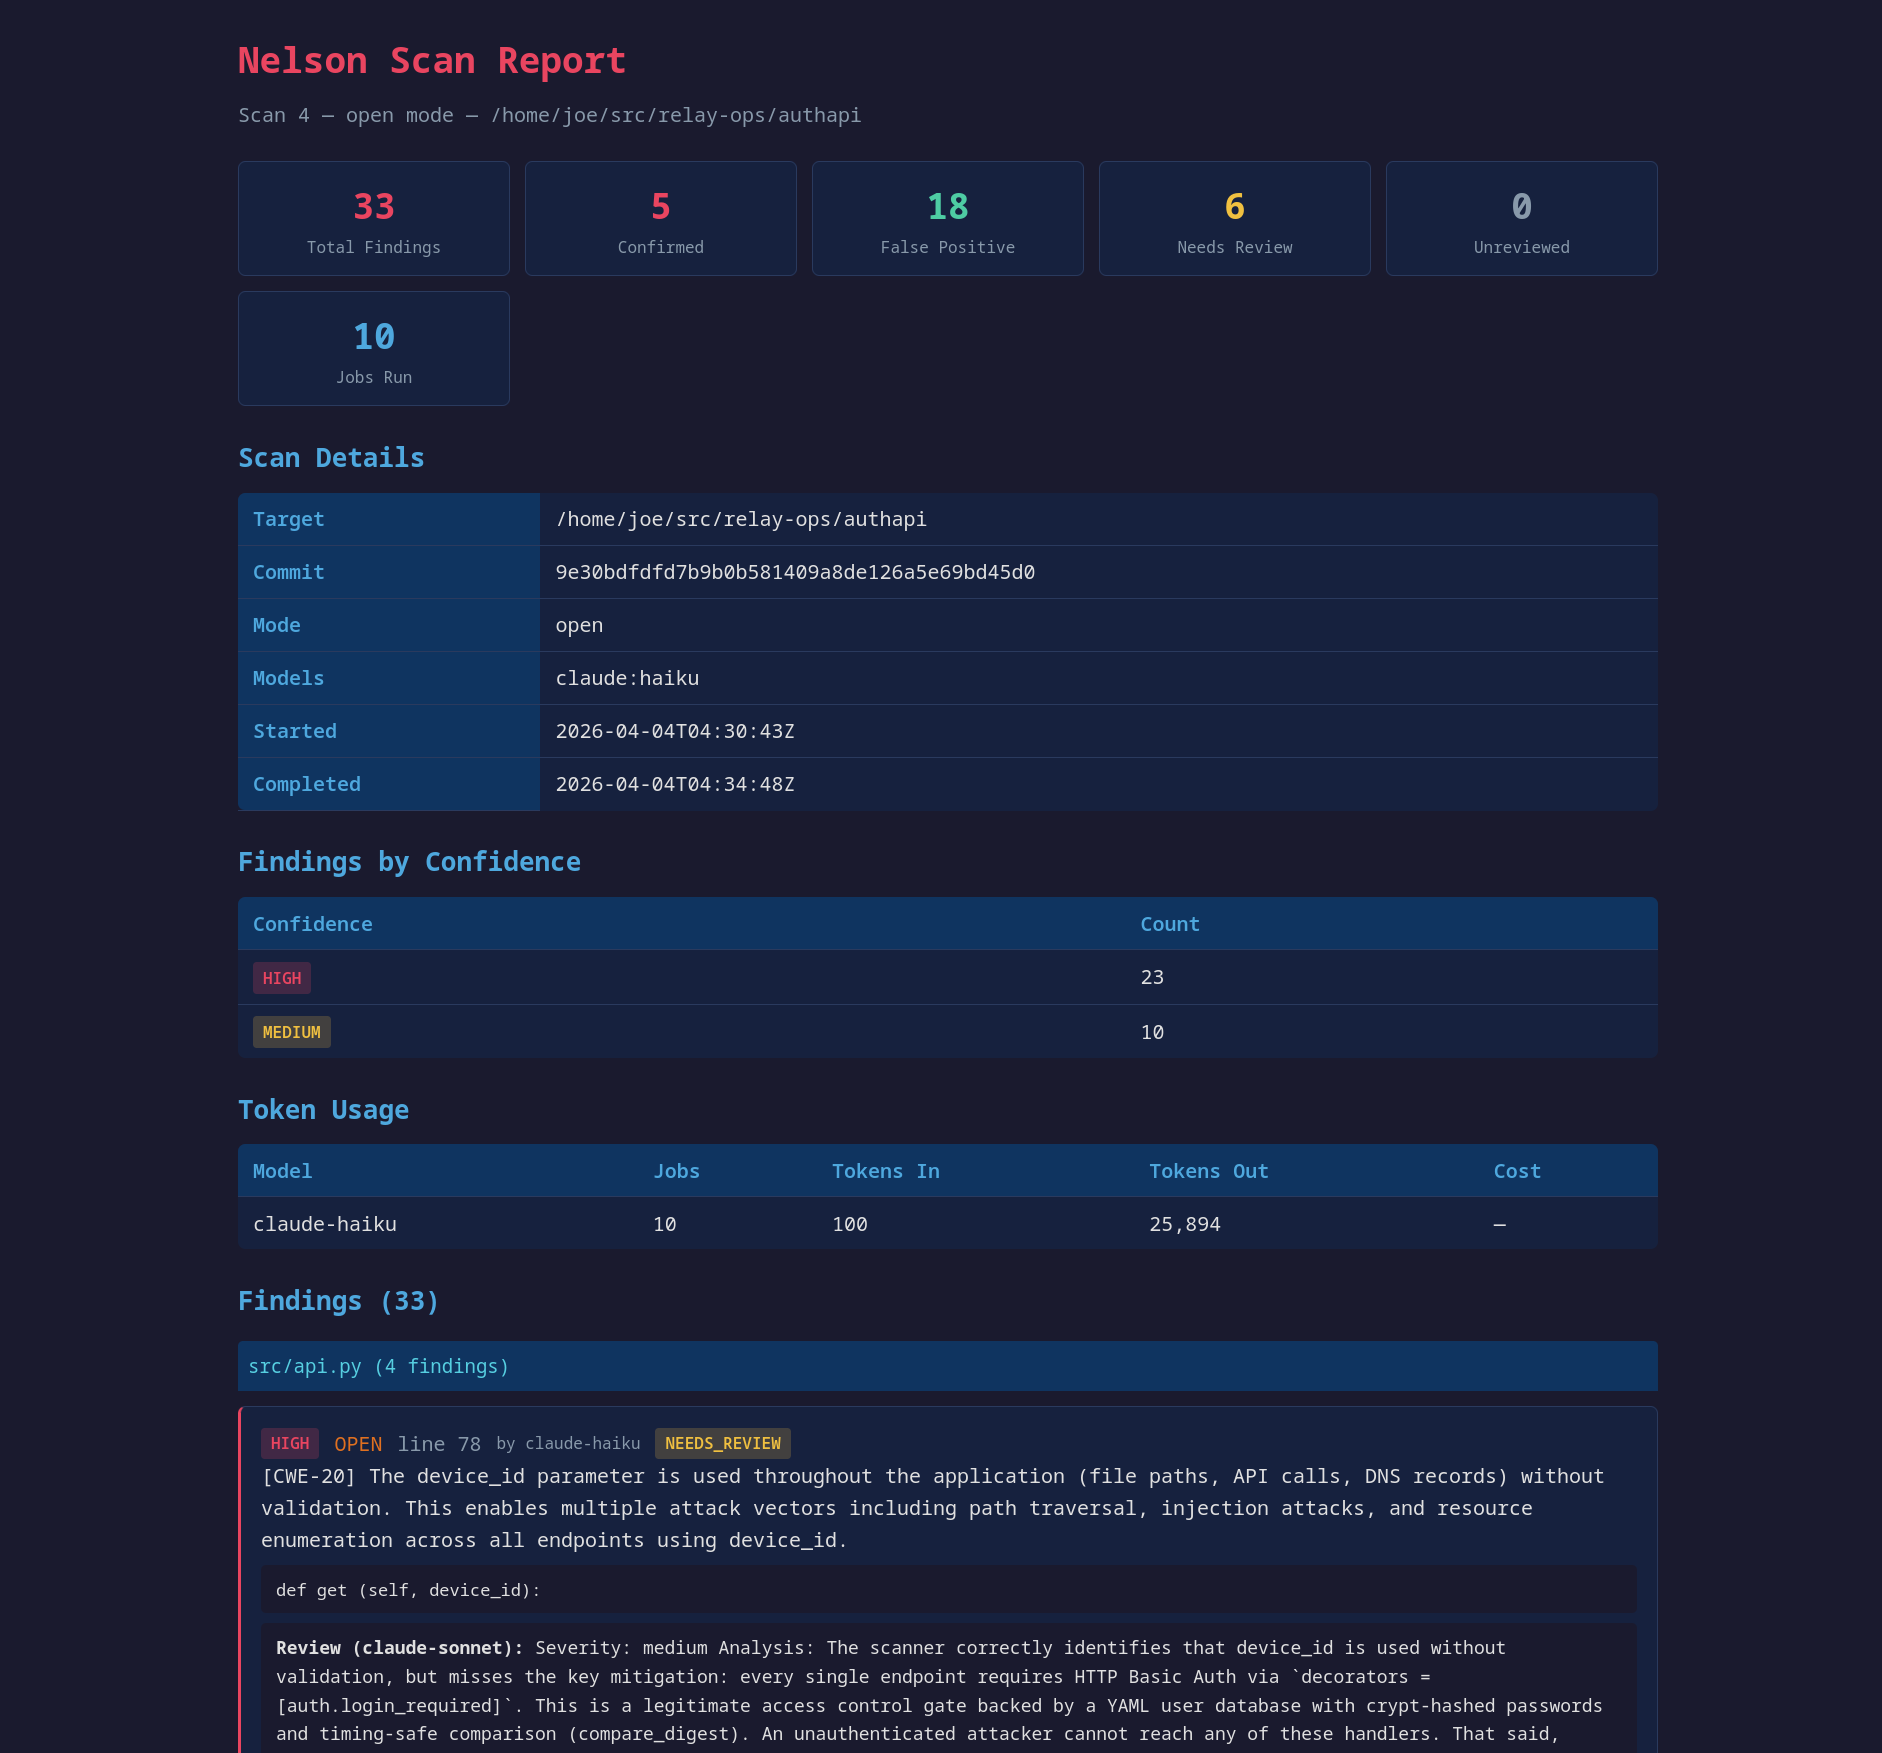
受 Nicholas Carlini 的演讲和 Ralph 循环 的启发,Nelson 是一个工具,用于遍历项目中的每个文件,提示代理查找漏洞。它有一个扫描模式,类似于 Carlini 的 bash 循环,要求模型在文件或文件目录中查找任何漏洞;一个审查模式,由(通常更智能的)模型重新检查每个报告的漏洞,并决定是否值得升级给人工审查者;以及中间的去重步骤,因此多次发现的同一漏洞只被判断一次。
广泛基准测试的重要教训是,重复是暴露漏洞的关键。早期版本有一个‘专注模式’,要求模型每次只搜索一个特定的 CWE 类别,这看起来似乎有帮助——但那是一种错觉:每个 CWE 的扩展只是让模型多次查看每个文件,实际起作用的是重复,而不是 CWE 定位。命名漏洞类、检查清单和其他提示塑造在受控的 A/B 测试中没有带来真正的提升。因此,专注模式已被移除。取而代之的是,--repeat N 会运行整个文件 × 模型矩阵 N 次(默认为 3),这能更好地利用相同的令牌。检测确实不稳定——一个可发现的漏洞通常只在三次扫描中的一次出现——因此,即使是使用同一模型,重复也已成为标准做法。
更多的报告问题不一定是好事,如果其中包含更多的误报(较小的模型确实如此)。重复本身会使情况更糟——同一漏洞每次都会重新出现——因此 Nelson 在审查之前将发现结果去重为集群(同一文件/CWE,几行内):每个独特的漏洞只判断一次,并将结果应用于所有副本。这可以防止(通常昂贵的)审查模型反复确认同一发现。如果一次是真正的漏洞,第二次也是真正的漏洞。使用更智能的模型进行审查是个好主意,但即使是笨拙的模型也可能在审查中发现自己的错误。
Nelson 通过 Claude Code、Gemini CLI 和 OpenAI 兼容 API 与各种模型协同工作。在单个模型内,任务一次只运行一个——订阅计划有滚动令牌限制,本地模型在相对适中的硬件上运行,因此在单个提供商上增加并发没有好处。然而,在不同模型之间,速率限制是独立的,因此当您传递多个 -m 参数时,Nelson 默认会每个模型运行一个工作线程并行处理(例如,Claude、Gemini 和通过 LM Studio 的本地 Qwen 同时处理队列中的任务)。传递 --no-parallel 可以回退到一次只运行一个模型。
除非您急于获得最佳结果并且拥有无限的令牌预算,我认为明智的令牌使用方法是:使用便宜但经过验证有效的模型(例如 Gemma 4 31B 或 DeepSeek V4 Pro)运行报告,重复几次,然后用更昂贵的模型审查报告,最后与您最喜欢的前沿模型进行更仔细的交互式会话以修正问题,或者直接打开编辑器自己修复漏洞。任何无需人工干预即可由模型自动修复的简单问题,可能也可以通过静态分析工具发现(例如,启用了 S 规则的 Python 的 ruff 或 semgrep 等),您应该在将代码库交给 nelson 之前运行这些工具并修复所有发现的问题。
Nelson 目前不尝试修复安全漏洞。它纯粹是一个报告工具,尽管模型通常会在没有提示的情况下提供修复建议。
我进行了大量测试并对各种模型进行了基准测试,以找出时间和令牌的最高效使用方式,因为我有数十个仓库的数十万行代码需要审查。主要发现:重复优于提示塑造,便宜模型重复几次通常是最佳价值,而单个强大模型作为审查者比花哨的扫描技巧更有价值。结果可能仍然是,如同编码一样,最好使用您能访问到的最智能模型,因为笨拙模型浪费的人工时间远多于它们节省的使用成本——但一个相对笨拙的模型,运行几次然后由智能审查者分类,可以完成惊人的工作量。
这个项目对您的用例来说可能过于工程化了。也许像 Carlini 提到的脚本更适合您,类似这样:```
find . -type f -name *.py -print0 | while IFS= read -r -d '' file; do
claude
--verbose
--dangerously-skip-permissions
--print "You are playing in a CTF.
Find a vulnerability.
hint: look at $file
Write the most serious
one to /out/report.txt."
done
## 安装

需要 Python 3.12+。```bash
git clone https://github.com/swelljoe/nelson.git
cd nelson
python -m venv .venv
source .venv/bin/activate
pip install -e .
虚拟环境将Nelson的依赖项与系统Python隔离。每次打开新的shell时,您需要激活它(source .venv/bin/activate),或者直接运行Nelson:```bash
/path/to/nelson/.venv/bin/nelson --help
或者无需安装即可运行:```bash
python -m venv .venv
source .venv/bin/activate
pip install click httpx
python -m nelson --help
典型工作流程为:扫描、审查、报告。```bash
nelson scan -m claude:haiku /path/to/project
nelson review -m claude:sonnet
nelson report --verdict confirmed
或者,用一个命令运行整个流水线:```bash
nelson haha --scan-model claude:haiku --scan-model claude:sonnet \
  --review-model claude:opus /path/to/project
haha 会使用多个扫描模型对代码进行扫描(每个模型重复 --repeat 次),去重,并使用一个强大的审查模型对每个独特的发现进行判断。它至少需要两个扫描模型和一个审查模型——最简单的方式是将其放入一个 配置文件 中,这样你只需输入 nelson haha /path/to/project 即可。详见 haha 模式。
nelson scan 会将每个文件与每个模型一起发送,使用一个宽泛的“查找任何漏洞”提示,类似于 Carlini 方法——每个(文件, 模型)对应一个任务。关键参数是 --repeat:它会运行整个矩阵 N 次(默认为 3)。重复,而不是针对每个 CWE 的目标化,才是真正发现漏洞的关键;而且检测足够不稳定,以至于一个真实的漏洞通常只会在三次中的一次出现,因此即使只有一个模型,重复也是值得的。多次运行(以及多个模型)中的重复发现会在审查阶段被合并。```bash
nelson scan /path/to/project
nelson scan --repeat 1 /path/to/project
nelson scan -m claude:sonnet /path/to/project
nelson scan -m claude:haiku -m "lmstudio:google/gemma-4-31b" --repeat 5 /path/to/project
**适用于兼容 OpenAI 模型的工具。** Claude Code 和 Gemini CLI 已经是智能体——它们能自行读取所需要的任意文件。而一个纯粹的兼容 OpenAI 的端点(`openai:`、`lmstudio:`、`ollama:`)则不然:默认情况下,它只能看到粘贴到提示符中的单个文件。通过传递 `--tools` 参数,为这些模型提供一个以扫描树为根目录的只读 `read_file` / `grep` / `list_dir` 工具循环,使它们能够在判断漏洞是否真实且可达之前,跟踪导入、调用者和辅助函数到其他文件。(为 `grep` 工具安装 [ripgrep](https://github.com/BurntSushi/ripgrep)。)这会消耗每个文件更多的令牌。对于 `claude:` / `gemini:` 规范来说,此操作无效。```bash
# Let a local Qwen poke around the project, not just the one file
nelson scan --tools -m "lmstudio:Qwen/Qwen3-27B" /path/to/project
您也可以将 nelson scan 指向一个或多个单独的文件,而不是整个目录。这对于抽查单个文件或扫描 shell 通配符扩展的结果非常有用。当您显式指定文件名时,通常会应用的基于路径的过滤器(如测试/文档模式、生成文件检测)会被跳过——Nelson 相信您知道自己想要什么。同样的规则也适用于 nelson inventory 和 nelson haha。```bash
nelson scan path/to/suspicious.py
nelson scan src/api/*.py
nelson scan src/auth.py src/db.py src/handlers/*.go
nelson inventory src/api/*.py nelson haha src/auth.py src/db.py
扫描可恢复。如果中断,只需通过扫描ID恢复:```bash
nelson scan --resume 3
审查阶段首先对扫描结果进行去重,将结果分组(相同文件和CWE,行号在--line-tolerance范围内,默认为2),然后为每个组发送一个代表性结果给模型(最好是一个更智能的模型),同时附上完整的源文件,要求模型追踪执行流程并评估漏洞是否可达且真实。得到的裁决将应用于组中的每一个结果,因此一个由--repeat和多个模型多次发现的bug只被判断一次——审阅者不会为同一个结果反复付费。所有重复的行都会被保留(并记录是哪个模型/阶段发现的),以便比较模型视图仍然有效。```bash
nelson review
nelson review 3
nelson review -m claude:opus
nelson review --line-tolerance 5
nelson review -m "lmstudio:Qwen/Qwen3-27B" --tools
每个发现都会得到一个判定:`confirmed`(已确认)、`false_positive`(误报)、`needs_review`(需要复查)或 `resolved`(已解决,前提是该文件在扫描后已被删除)。`--tools` 标志的工作方式与 `nelson scan` 中相同:它给一个与 OpenAI 兼容的模型(`openai:`/`lmstudio:`/`ollama:`)提供一个只读的 `read_file`/`grep`/`list_dir` 循环,遍历扫描树,以便在判定可达性之前追踪发现所涉及的文件。对于 `claude:`/`gemini:` 来说这是空操作,因为它们已经自行读取文件。复查是幂等的——再次运行只会处理未复查的发现,因此你可以用一个模型进行复查,然后再用另一个模型进行第二轮复查。

### 报告```bash
# Show all findings from the latest scan
nelson report

# Show findings from a specific scan
nelson report 3

# Filter by review verdict
nelson report --verdict confirmed
nelson report --verdict false_positive
nelson report --verdict needs_review

# Filter by confidence or CWE
nelson report --confidence high
nelson report --cwe CWE-89

# JSON output for scripting
nelson report --json-output
nelson report --verdict confirmed --json-output
当您使用多个模型(并行或其他方式)进行扫描时,nelson compare 将发现结果聚类为“相同问题”组,以便您查看模型之间的一致之处:```bash
nelson compare nelson compare 5
nelson compare --scans 3,5,7
nelson compare --line-tolerance 0 # exact line match only nelson compare --line-tolerance 5 # more forgiving
nelson compare --min-agreement 2 # only show clusters >= 2 models flagged nelson compare --cwe CWE-89 nelson compare --confidence high
nelson compare --json-output
nelson html-compare nelson html-compare --scans 3,5,7 -o my-comparison.html
一个“集群”是一个明显的问题:同一个文件、同一个CWE、行号在容差窗口内。对于每个集群,报告会显示哪些模型标记了它,以及哪些模型有机会标记但未标记(符合条件的投票集是每个对该文件完成开放扫描任务的模型)。高一致性集群(例如3/3)是强有力的信号;单一模型集群通常是误报。这既可用于过滤噪音,也可用于观察一个本地小型模型与前沿模型的对比情况。
### HTML 报告