
| 特性 | Token 级水印(KGW、SWEET、Unigram、STONE、STA-1) | 事后水印(ACW、SrcMarker、RoSeMary) | ✨ SEW |
|---|---|---|---|
| 访问方式 | 解码时(偏置 token 选择) | 事后(重写已完成的代码) | 事后(重写已完成的代码,模型无关) |
| 功能正确性 | 改变程序(可检测性与正确性的权衡) | 可能破坏程序(Java/C++ 的 pass@1 在神经重写下约为 12%) | 保持不变(pass@1 与未加水印的代码相同) |
| 可预测性 | — | 重复出现的模式(可从 10 个加水印的程序中恢复) | 依赖密钥和上下文(选择随每个程序的结构而变化) |
| 检测(TPR@FPR5%) | 14–60% | 31–98% | ⚡ 98.7–99.5% |
对 LLM 生成的代码加水印有助于来源追踪。在生成过程中修改 token 选择的水印需要在可检测性与功能正确性之间权衡,并且需要控制生成模型。事后方法则使用预定义的变换或训练好的神经模型对已完成的代码加水印,但它们重复出现的模式使水印在不同程序间可被预测,而且那些在未加水印代码中本就常见的模式会被计为水印证据,从而导致误检。SEW 提出的问题是:一个已经生成的程序的代码风格,能否承载一种构造上正确、难以预测、并针对人类编写代码进行校准的水印?
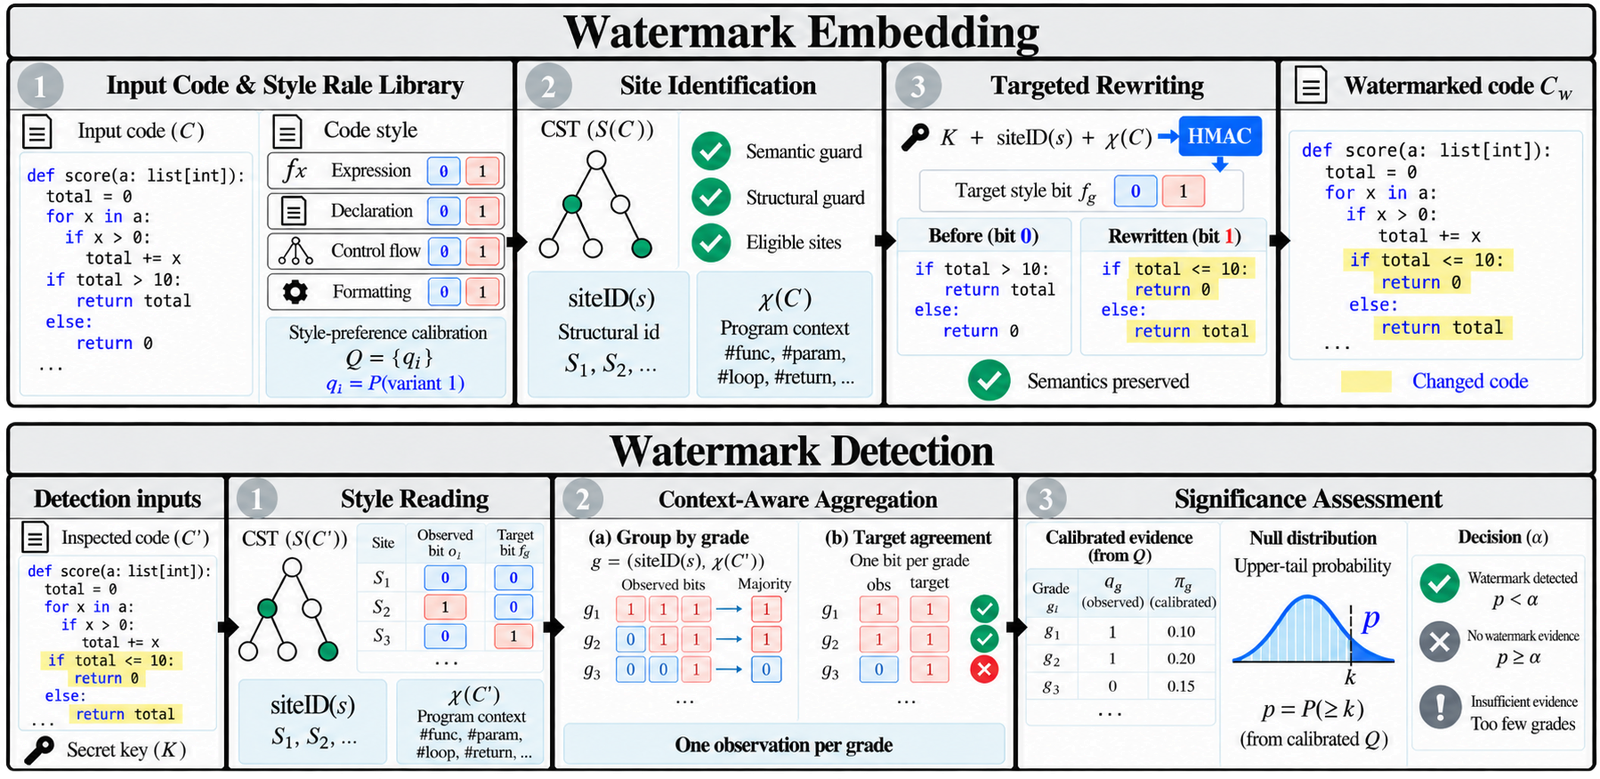
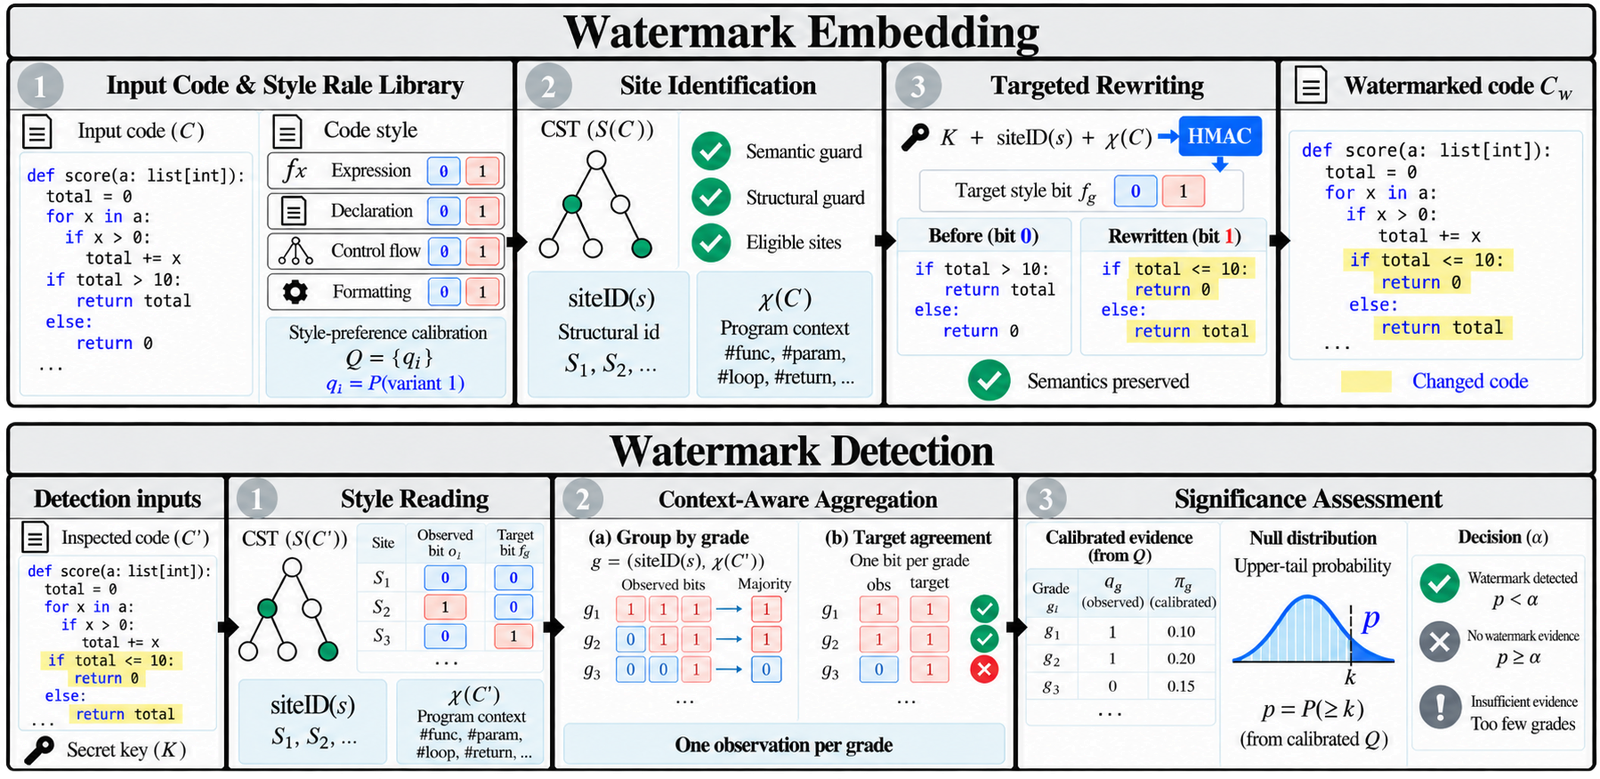
SEW(Style-Encoded Watermarking,风格编码水印)通过三个组件在已生成的代码中嵌入和检测水印:
x += 1 / x = x + 1、range(n) / range(0, n)、if (c) s; / if (c) { s; })在具体语法树(CST)上进行匹配。某个位置采用哪种变体由秘密密钥和该位置的结构上下文决定。检测只需要可疑代码和密钥——不需要生成模型、原始代码或任何嵌入记录。
✅ 模型无关且构造上正确 —— SEW 只重写两种变体语义相同的风格位置,因此它适用于任何模型的输出,并使 pass@1 与未加水印的代码保持一致。
✅ 校准的证据 —— 使用从人类编写代码(LeetCode 题解,与评估数据不相交)估计的风格概率进行泊松二项检验,使人类代码上的误检率保持较低。
✅ 鲁棒且难以推断 —— SEW 在格式化、lint、注释移除和变量重命名下仍能保持检测能力,而观察了加水印程序的对手无法像恢复事后基线那样恢复其风格选择。
主要结果——在 CodeContests 上的检测(TPR@FPR5% / AUROC,%),在三个 LLM(Qwen3.5-9B、gemma-4-12B-it、gpt-oss-20b)上取平均。
| 类型 | 方法 | Python | Java | C++ |
|---|---|---|---|---|
| Token 级 | KGW | 48.33 / 80.56 | 43.30 / 72.31 | 59.31 / 84.54 |
| SWEET | 59.92 / 85.18 | 41.19 / 76.56 | 60.01 / 87.24 | |
| Unigram | 57.45 / 88.97 | 36.54 / 71.37 | 47.05 / 71.13 | |
| STONE | 28.09 / 62.33 | 14.38 / 62.95 | 23.65 / 64.79 | |
| STA-1 | 35.26 / 66.26 | 20.93 / 61.48 | 44.71 / 73.72 | |
| 事后 | ACW | 90.10 / 95.05 | – | – |
| SrcMarker | 90.21 / 97.86 | 71.52 / 93.58 | 69.88 / 81.55 | |
| RoSeMary | 97.86 / 97.32 | 31.00 / 95.46 | 81.26 / 89.44 | |
| SEW | 99.49 / 99.64 | 98.70 / 98.99 | 99.22 / 99.38 |
功能正确性(加水印代码的 pass@1,%;未加水印代码:57.63 / 52.05 / 53.74)。
| 方法 | Python | Java | C++ |
|---|---|---|---|
| ACW | 56.00 | – | – |
| SrcMarker | 56.78 | 11.87 | 11.82 |
| RoSeMary | 56.39 | 11.71 | 11.52 |
| SEW | 57.63 | 52.05 | 53.74 |
对代码编辑攻击的鲁棒性(TPR@FPR5%,%,在三个 LLM 和三种语言上取平均;ACW:仅 Python)。
| 方法 | 无攻击 | 格式化 | Lint | 注释移除 | 重命名 |
|---|---|---|---|---|---|
| KGW | 50.31 | 43.31 | 49.99 | 24.48 | 43.26 |
| SWEET | 53.71 | 49.79 | 53.00 | 19.34 | 48.83 |
| ACW | 90.10 | 0.51 | 93.56 | 89.35 | 3.17 |
| SrcMarker | 77.20 | 77.23 | 76.42 | 77.20 | 26.43 |
| RoSeMary | 70.04 | 67.00 | 69.42 | 70.04 | 22.26 |
| SEW | 99.14 | 95.57 | 98.99 | 99.14 | 99.14 |
我们在 CodeContests 上使用三个 LLM 和三种编程语言进行的实验表明:
完整表格、规则感知翻转和 LLM 重写攻击以及消融实验,请参见论文。
| 方法 | 嵌入方式 | 编辑示例 | 出了什么问题 | SEW 下的同一位置 |
|---|---|---|---|---|
| ACW | 固定规则,方向始终相同;检测 = 重新应用并观察是否有变化 | line = line + w → line = w + lineif n > 0 → if 0 < n | ❌ 无类型保护:abcde → ecdab❌ 到处是相同模式:10 个程序即可揭示(99.7%) ❌ 空格是标记的一部分: black 会重写它,重新应用会改变代码,检查失败(90.1 → 0.5) | ✅ 仅限数值操作数:保留 line + w✅ 方向由密钥 + 上下文决定(19.9%) ✅ 语法选择在 black 下仍保留,并被单独测试(99.1 → 95.6) |
| SrcMarker | 训练好的选择器挑选变换 + 重命名标识符;训练好的提取器读取它们 | while (n-- > 0) → while (--n > 0) | ❌ 少一次迭代:Java/C++ pass@1 ≈ 12% ❌ 重命名会丢失标识符比特(77.2 → 26.4) ❌ 需要提取器模型 | ✅ 值被使用的 n-- 不是位置✅ 名称不是证据(99.1 → 99.1) ✅ 仅需密钥 |
| RoSeMary | 与提取器一起训练的 CodeT5 重写器;标记在学到的编辑 + 重命名的标识符中 | int count → int cnti-- > 0 → --i > 0 | ❌ 同样的循环破坏:pass@1 ≈ 12% ❌ 学到的编辑会重复出现:10 个程序即可揭示(86%) ❌ 重命名(70.0 → 22.3);需要提取器 | ✅ 标识符从不被重写或计数 ✅ 同一规则,每个程序目标不同(19.9%) ✅ 无模型:解析器 + 密钥 + 概率表 |