Merlion 是一个用于时间序列智能的 Python 库。它提供了一个端到端的机器学习框架,包括加载和转换数据、构建和训练模型、后处理模型输出以及评估模型性能。它支持多种时间序列学习任务,包括单变量和多变量时间序列的预测、异常检测和变点检测。该库旨在为工程师和研究人员提供一站式解决方案,以便针对其特定的时间序列需求快速开发模型,并在多个时间序列数据集上对其进行基准测试。
Merlion 的关键特性有:
DefaultDetector 和 DefaultForecaster 模型,高效、稳健地实现良好性能,并为新用户提供起点。下表直观概述了 Merlion 的关键特性与其他用于时间序列异常检测和/或预测的库的对比。
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 单变量预测 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| 多变量预测 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 单变量异常检测 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| 多变量异常检测 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 预处理 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||
| 后处理 | ✅ | ✅ | ||||||||||
| AutoML | ✅ | ✅ | ✅ | |||||||||
| 集成 | ✅ | ✅ | ✅ | ✅ | ||||||||
| 基准测试 | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| 可视化 | ✅ | ✅ | ✅ | ✅ | ✅ |
以下是 Merlion 2.0 中新增的功能:
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 外生回归变量 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 变点检测 | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| 可点击的可视化 UI | ✅ | |||||||||||
| 分布式后端 | ✅ | ✅ |
Merlion 由两个子仓库组成:merlion 实现该库核心的时间序列智能功能,ts_datasets 为多个时间序列数据集提供标准化的数据加载器。这些加载器将时间序列加载为带有相应元数据的 pandas.DataFrame。
您可以通过调用 pip install salesforce-merlion 从 PyPI 安装 merlion。您也可以通过克隆此仓库并调用 pip install Merlion/ 从源码安装,或调用 pip install -e Merlion/ 以可编辑模式安装。您可以通过 pip install salesforce-merlion[all] 安装额外的依赖项,或者如果从源码安装,请调用 pip install "Merlion/[all]"。可选依赖项包括:用于 GUI 仪表盘的 dashboard、用于通过 PySpark 进行分布式计算后端的 spark,以及用于所有深度学习模型的 deep-learning。
要安装数据加载包 ts_datasets,请克隆此仓库并调用 pip install -e Merlion/ts_datasets/。如果您不想在初始化数据加载器时手动指定每个数据集的根目录,则必须以可编辑模式(即使用 -e 标志)安装此包。
请注意以下外部依赖项:
我们的一些预测模型依赖于 OpenMP。如果使用 conda,请在安装我们的包之前执行 conda install -c conda-forge lightgbm。这将确保 OpenMP 在您的 conda 环境中与 lightgbm 包(我们的依赖项之一)正常配合工作。如果使用 Mac,请安装 Homebrew 并调用 brew install libomp,以便模型可以使用 OpenMP 库。
我们的一些异常检测模型依赖于 Java 开发工具包 (JDK)。对于 Ubuntu,请执行 sudo apt-get install openjdk-11-jdk。对于 Mac OS,请安装 Homebrew 并调用 brew tap adoptopenjdk/openjdk && brew install --cask adoptopenjdk11。同时确保 java 可以在您的 PATH 中找到,并且已设置 JAVA_HOME 环境变量。
有关示例代码和 Merlion 的介绍,请参阅 examples 中的 Jupyter 笔记本以及此处的引导式演练。您可以在此处找到详细的 API 文档(包括示例代码)。技术报告概述了 Merlion 的整体架构,并展示了单变量和多变量时间序列在时间序列异常检测与预测方面的实验结果。
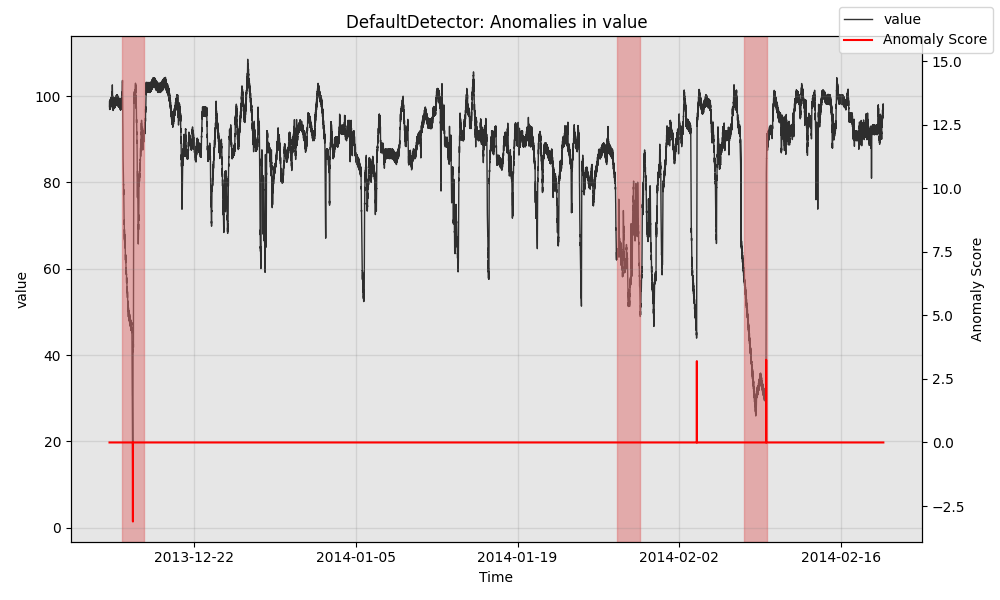
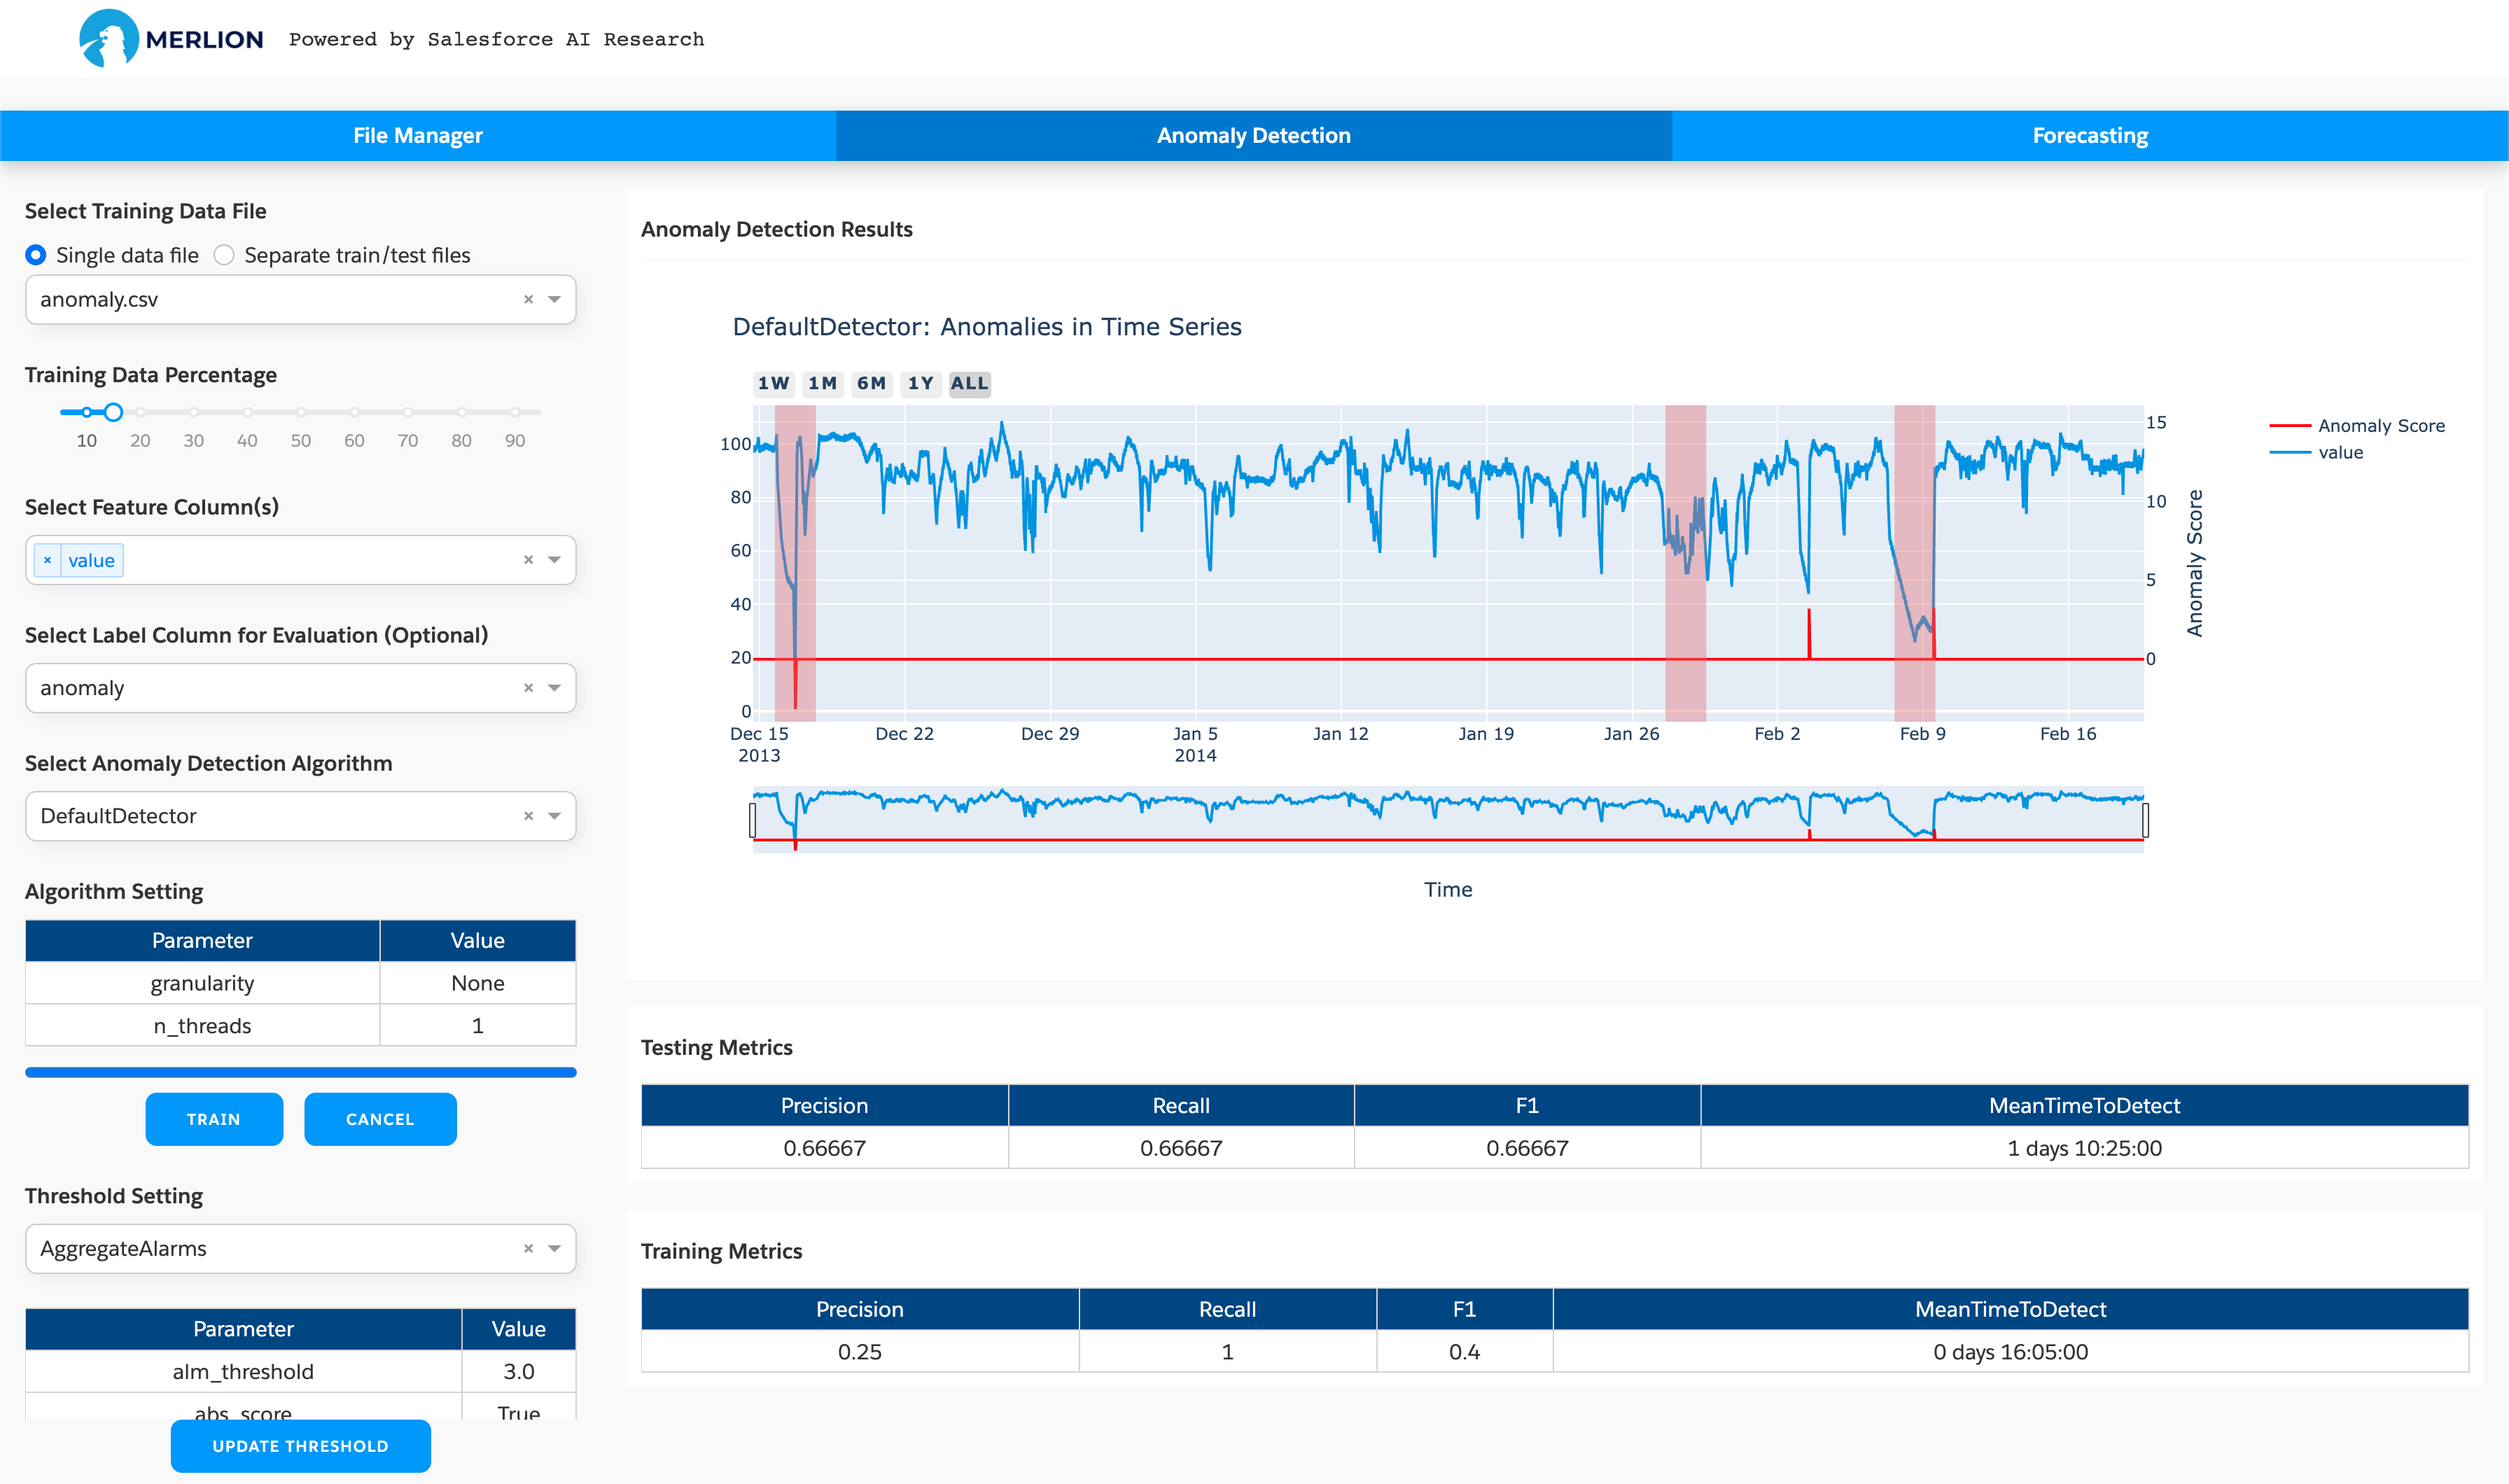
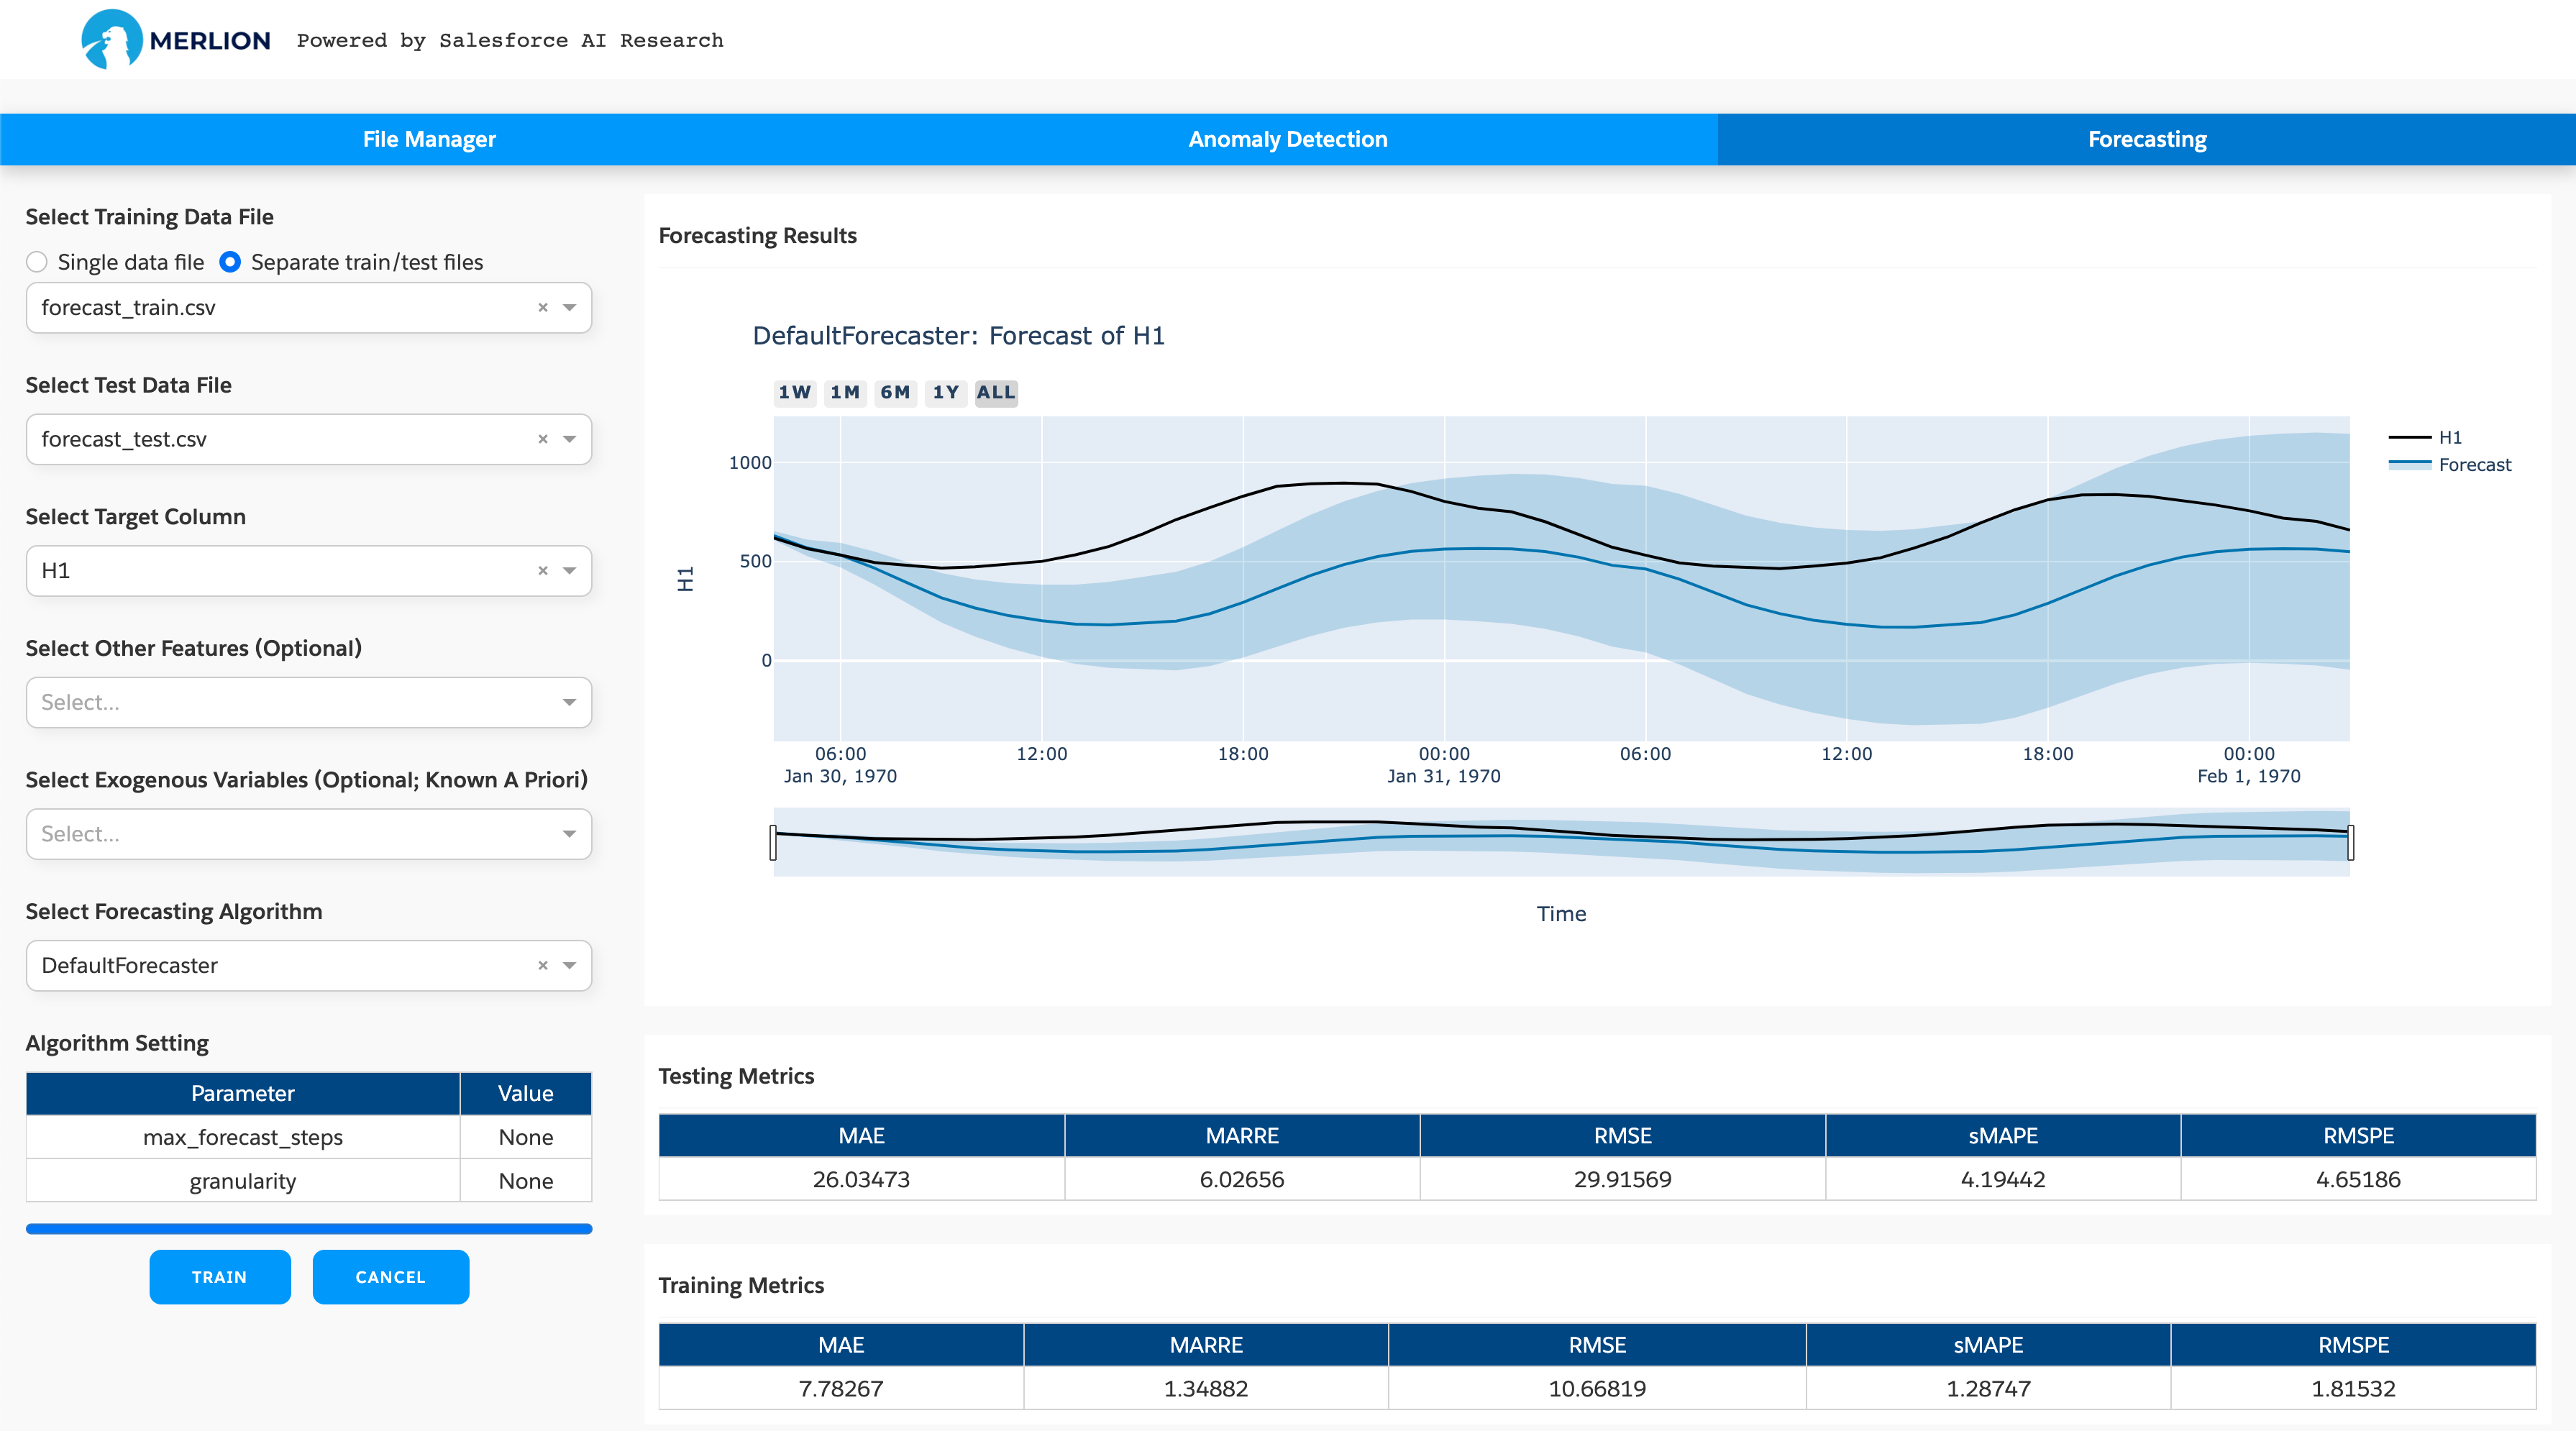
开始使用的最简单方法是使用基于 GUI 网页的仪表盘。该仪表盘为您提供了一种在自定义数据集上快速试验多种模型的绝佳方式。要使用它,请安装带有可选 dashboard 依赖项的 Merlion(即 pip install salesforce-merlion[dashboard]),然后在命令行中调用 python -m merlion.dashboard。您可以在 http://localhost:8050 查看仪表盘。下面,我们展示异常检测和预测的仪表盘截图。
为了帮助您在自己的代码中开始使用 Merlion,我们在下面提供了一些使用 Merlion 默认模型进行异常检测和预测的最小示例。
在这里,我们展示用于复现上述异常检测仪表盘结果的代码。我们首先导入 Merlion 的 TimeSeries 类和 Numenta 异常检测基准 NAB 的数据加载器。然后,我们可以将该数据集中的特定时间序列划分为训练集和测试集。
from merlion.utils import TimeSeries
from ts_datasets.anomaly import NAB

# Data loader returns pandas DataFrames, which we convert to Merlion TimeSeries
time_series, metadata = NAB(subset="realKnownCause")[3]
train_data = TimeSeries.from_pd(time_series[metadata.trainval])
test_data = TimeSeries.from_pd(time_series[~metadata.trainval])
test_labels = TimeSeries.from_pd(metadata.anomaly[~metadata.trainval])
然后,我们可以初始化并训练 Merlion 的 DefaultDetector,这是一个在性能与效率之间取得平衡的异常检测模型。我们还可以获取其在测试集上的预测结果。
from merlion.models.defaults import DefaultDetectorConfig, DefaultDetector
model = DefaultDetector(DefaultDetectorConfig())
model.train(train_data=train_data)
test_pred = model.get_anomaly_label(time_series=test_data)
接下来,我们可视化模型的预测结果。
from merlion.plot import plot_anoms
import matplotlib.pyplot as plt
fig, ax = model.plot_anomaly(time_series=test_data)
plot_anoms(ax=ax, anomaly_labels=test_labels)
plt.show()
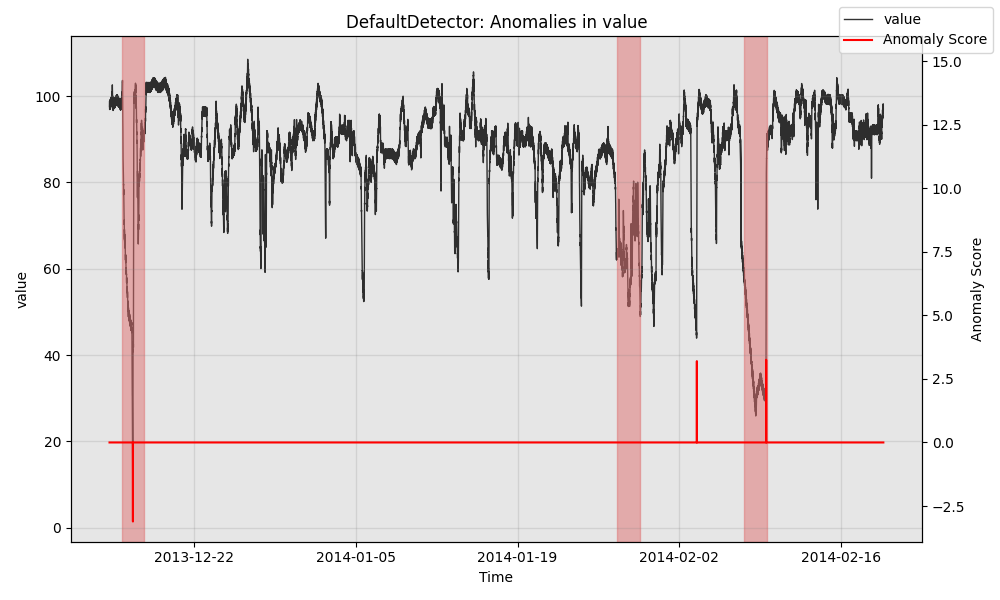
最后,我们可以定量评估该模型。精确率和召回率来自模型触发的 3 次警报,其中 2 次真正例、1 次假负例和 1 次假正例。我们还会评估模型正确检测到的每个异常的平均检测时间。
from merlion.evaluate.anomaly import TSADMetric
p = TSADMetric.Precision.value(ground_truth=test_labels, predict=test_pred)
r = TSADMetric.Recall.value(ground_truth=test_labels, predict=test_pred)
f1 = TSADMetric.F1.value(ground_truth=test_labels, predict=test_pred)
mttd = TSADMetric.MeanTimeToDetect.value(ground_truth=test_labels, predict=test_pred)
print(f"Precision: {p:.4f}, Recall: {r:.4f}, F1: {f1:.4f}\n"
      f"Mean Time To Detect: {mttd}")
Precision: 0.6667, Recall: 0.6667, F1: 0.6667
Mean Time To Detect: 1 days 10:22:30
在这里,我们展示用于复现上述预测仪表盘结果的代码。我们首先导入 Merlion 的 TimeSeries 类和 M4 数据集的数据加载器。然后,我们可以将该数据集中的特定时间序列划分为训练集和测试集。
from merlion.utils import TimeSeries
from ts_datasets.forecast import M4

# Data loader returns pandas DataFrames, which we convert to Merlion TimeSeries
time_series, metadata = M4(subset="Hourly")[0]
train_data = TimeSeries.from_pd(time_series[metadata.trainval])
test_data = TimeSeries.from_pd(time_series[~metadata.trainval])
然后,我们可以初始化并训练 Merlion 的 DefaultForecaster,这是一个在性能与效率之间取得平衡的预测模型。我们还可以获取其在测试集上的预测结果。