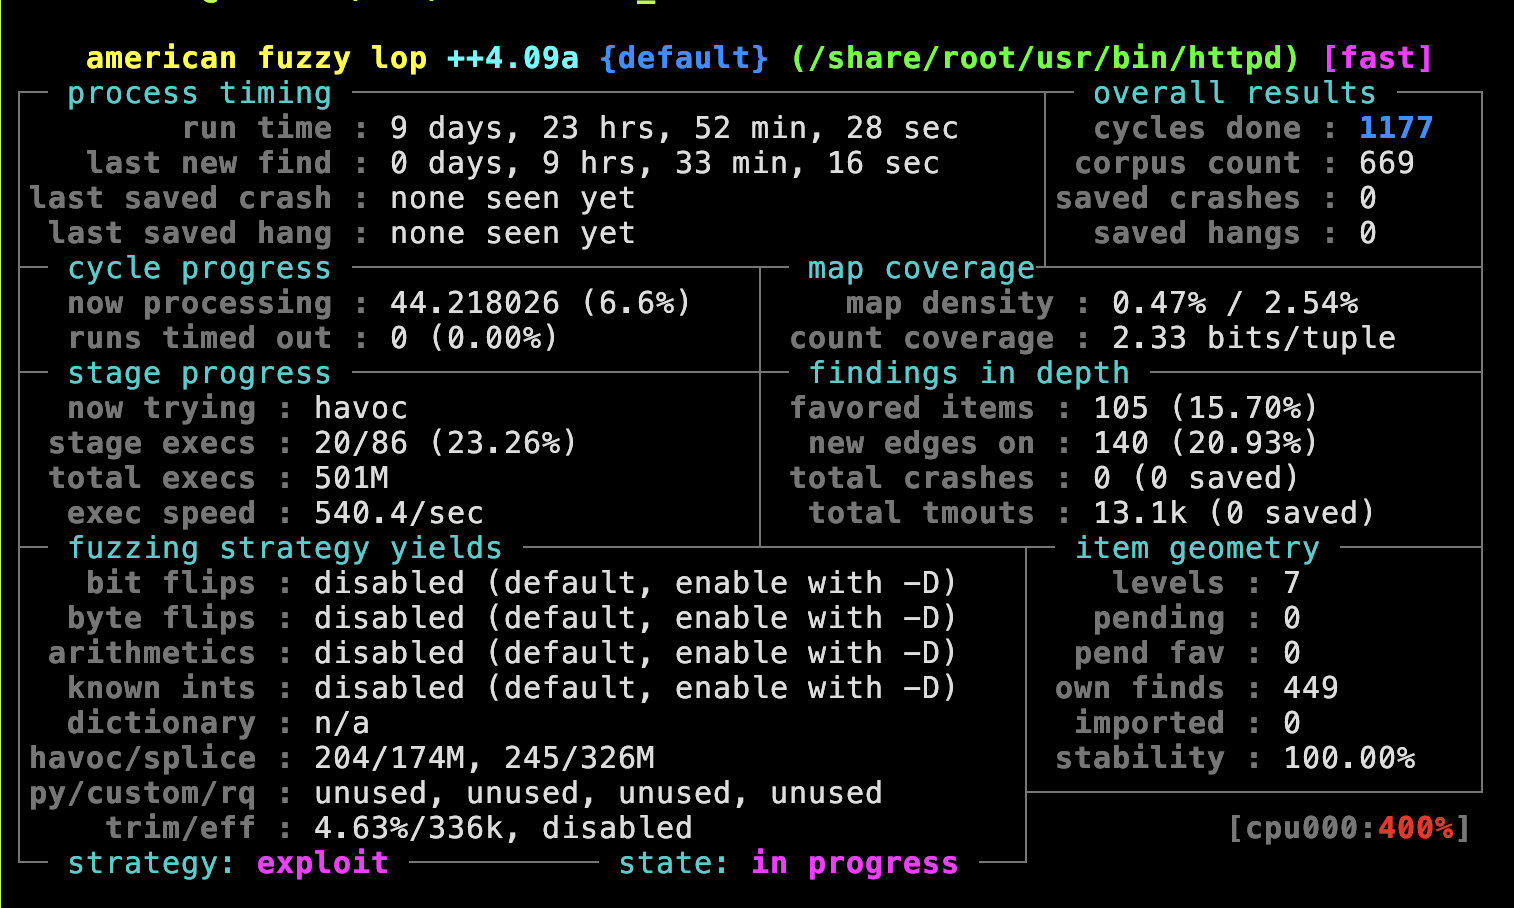
这是我的学期论文的 HTML 版本,可在此处下载 PDF 此处。
模糊测试已成为发现软件漏洞的“最有效方法之一”。许多当前与模糊测试相关的论文都以这种或类似的论断开篇 [google-scholar]。 我们上一篇关于“易受攻击的物联网”主题的学期论文的主要目标是找到一个内存相关漏洞,然后为这个漏洞编写利用程序。我们通过逆向固件成功找到了一个漏洞,但没有发现内存相关的漏洞。手动逆向二进制文件来发现缓冲区溢出不仅耗时,而且需要大量经验。与此同时,模糊测试正是为了成为发现此类内存相关漏洞的“最有效方式”。例如,谷歌推出了 OSS-Fuzz,它持续对开源软件进行模糊测试,并已在 1000 个项目中发现了超过 10,000 个漏洞 [oss-fuzz]。
这篇学期论文的目标同样是发现一个内存相关漏洞,但这次是通过模糊测试。目标漏洞应当能够在不知道管理员凭证的情况下通过网络被利用。本文描述了实现这一目标的方法。为此,本文分为两个部分。第一部分重点介绍如何找到一个有力的目标、可以使用哪些工具,以及一个好的模糊测试目标应该具备什么条件。第二部分则描述如何开发和调试一个能够对二进制中特定函数进行模糊测试的测试驱动程序。然后使用开发出的测试驱动程序,通过 AFL++ 对目标函数进行模糊测试。接下来,简要介绍相关背景以及物联网设备模糊测试的当前技术水平。
在本学期论文范围内创建的所有文件也已在 GitHub 上完整发布,可通过以下 URL 访问: otsmr/blackbox-fuzzing。
对物联网设备进行模糊测试并不像对开源项目进行模糊测试那样容易。源代码通常是专有的,这使得为了获得最佳模糊测试性能而对源代码进行插桩的灰盒模糊测试无法实现 [afl-persistent]。 此外,CPU 架构往往不被模糊器原生支持,这需要使用像 QEMU 这样的模拟器 [qemu],这也会降低模糊测试速度 [afl-persistent]。 另一个问题是硬件外设,这使得通用方法的开发变得复杂。论文《嵌入式模糊测试:挑战、工具与解决方案综述》 [embedded-fuzzing] 概述了不同的模糊测试策略,例如基于硬件的嵌入式模糊测试。这些策略中的大多数都需要目标程序的源代码,例如在将 AFL 等模糊器的源码移植到基于 ARM 的物联网设备上以在物联网硬件上运行模糊器时。在设备硬件上运行模糊器也存在性能问题,因为这些设备通常配备低端 CPU,比普通台式机 CPU 更慢。该论文提出的另一种方法是基于模拟的嵌入式模糊测试,即在模拟器中执行单个目标程序以进行覆盖率引导的模糊测试,或者模拟整个系统。
上述方法都通过使用模拟器或对源代码进行插桩来直接针对二进制文件。这些方法需要通常必须为单个物联网设备专门定制的模糊测试环境,并且难以通用化。为此,研究人员创建了一个名为 IoTFuzzer 的程序,旨在成为一个自动化模糊测试框架,目标是“在无法访问固件镜像的情况下发现内存损坏漏洞
[iotfuzzer]。” IoTFuzzer 基于这样一个观察:大多数物联网设备都有一个用于控制它们的移动应用程序,而这些应用程序包含有关与设备通信所用协议的信息。然后,该程序识别并重用特定于程序的逻辑来变异测试用例,以有效测试物联网目标
[iotfuzzer]。
测试驱动程序(harness)描述了一系列处理模糊器提供输入的 API 调用。与通常不需要测试驱动程序的普通应用程序相反,一个实现可重用函数的库必须使用正确的参数并按正确的顺序调用,以便维持多个共享函数调用之间的状态。如果不构建状态机而对库进行随机模糊测试,不太可能成功,反而会在库依赖关系未得到强制执行时产生大量误报崩溃。例如,当模糊器跳过了缓冲区大小检查,导致出现虚假的缓冲区溢出时,就可能发生这种情况。
在本文中,我们将对普通应用程序进行模糊测试,但由于使用套接字和多线程所带来的硬件依赖,我们也需要为它们创建测试驱动程序。该测试驱动程序在二进制的上下文中加载,并能调用目标程序的内部函数,如 代码 10 所示。
术语“corpus”(语料库)描述的是有效输入样本或测试用例,并作为在模糊测试过程中生成新输入数据的基础参考。在 代码 10 中,例如,它可以是一个 HTTP 请求。然后,模糊器利用该语料库生成变异或多样化的测试用例,通过探索各种输入场景来帮助检测软件漏洞。
黑盒模糊测试中最耗时的部分是查找固件中潜在的可漏洞函数。第一步是找到有趣的二进制文件,例如,可通过网络访问、使用不安全函数或未启用栈金丝雀(stack canary)等安全功能的二进制文件——栈金丝雀是缓冲区溢出保护机制。我们之前的论文
([iovt])
已经描述了如何从目标路由器中提取固件以及如何找到潜在危险的二进制文件。为此,使用了 EMBA 工具 [emba]。EMBA 根据固件中发现的二进制文件的不安全函数(如 strcpy)数量、网络访问情况以及栈金丝雀或 NX 位等安全保护对它们进行排序;在利用缓冲区溢出时这些信息会变得很有价值,如 代码 1 所示。
代码 1:不安全使用函数 strcpy 的 EMBAs 结果。
由于本文的目标是找到一种可以在不知道管理员凭据的情况下通过网络利用的内存漏洞,因此 易受攻击的函数必须能够通过网络调用,并应直接与所提供的用户输入交互。但具有网络交互性 并不意味着该二进制文件也可以直接通过网络访问。为了确定哪些二进制文件正在监听, 我们可以使用已在 [iovt] 中建立的 UART 根 shell。
```txt ~ # netstat -tulpn Active Internet connections (only servers) Proto Recv-Q Send-Q Local Address Foreign Address State PID/Program name tcp 0 0 127.0.0.1:20002 0.0.0.0:* LISTEN 1045/tmpd tcp 0 0 0.0.0.0:1900 0.0.0.0:* LISTEN 1034/upnpd tcp 0 0 0.0.0.0:80 0.0.0.0:* LISTEN 1027/httpd tcp 0 0 0.0.0.0:22 0.0.0.0:* LISTEN 1224/dropbear udp 0 0 0.0.0.0:20002 0.0.0.0:* 1048/tdpd [...] ```代码 2:使用 UART root shell 执行 netstat
第一个看起来有希望的二进制是 wscd。该二进制包含最多不安全的 strcpy 调用(除了 libcmm.so 库之外)以及网络交互,就 wscd 而言,这意味着它会连接到一个 UPnP 设备,并且不监听特定端口。如下文所示,它有一个易于模糊测试的函数,这就是为什么本文选择该二进制作为示例来解释一般流程。在逆向之前,我们可以使用 UART root shell 来确认该二进制是否正在运行以及它是如何启动的。
代码3:使用ps命令显示所有正在运行的程序。
通过ps,我们不仅可以看到二进制文件正在运行,还可以看到其参数,这些参数
对于验证某个潜在功能是否被调用非常重要。这些参数的含义可以
从CLI帮助中获取,该帮助在不带任何参数调用二进制文件时会显示。
代码 4:二进制文件 wscd 的选项。
如 代码 4 所示,wscd 以“Enabled UPnP Device service”启动,这看起来
很有希望。确认该二进制文件确实在路由器上运行后,就可以
使用 Ghidra 分析该二进制文件,以搜索可疑函数。对于模糊测试,
解析函数尤其值得关注,因为它们通常很复杂,而且被解析的输入
往往带有长度字段来标识所包含的数据,就像 TCP 数据包包含有效载荷的
长度一样。
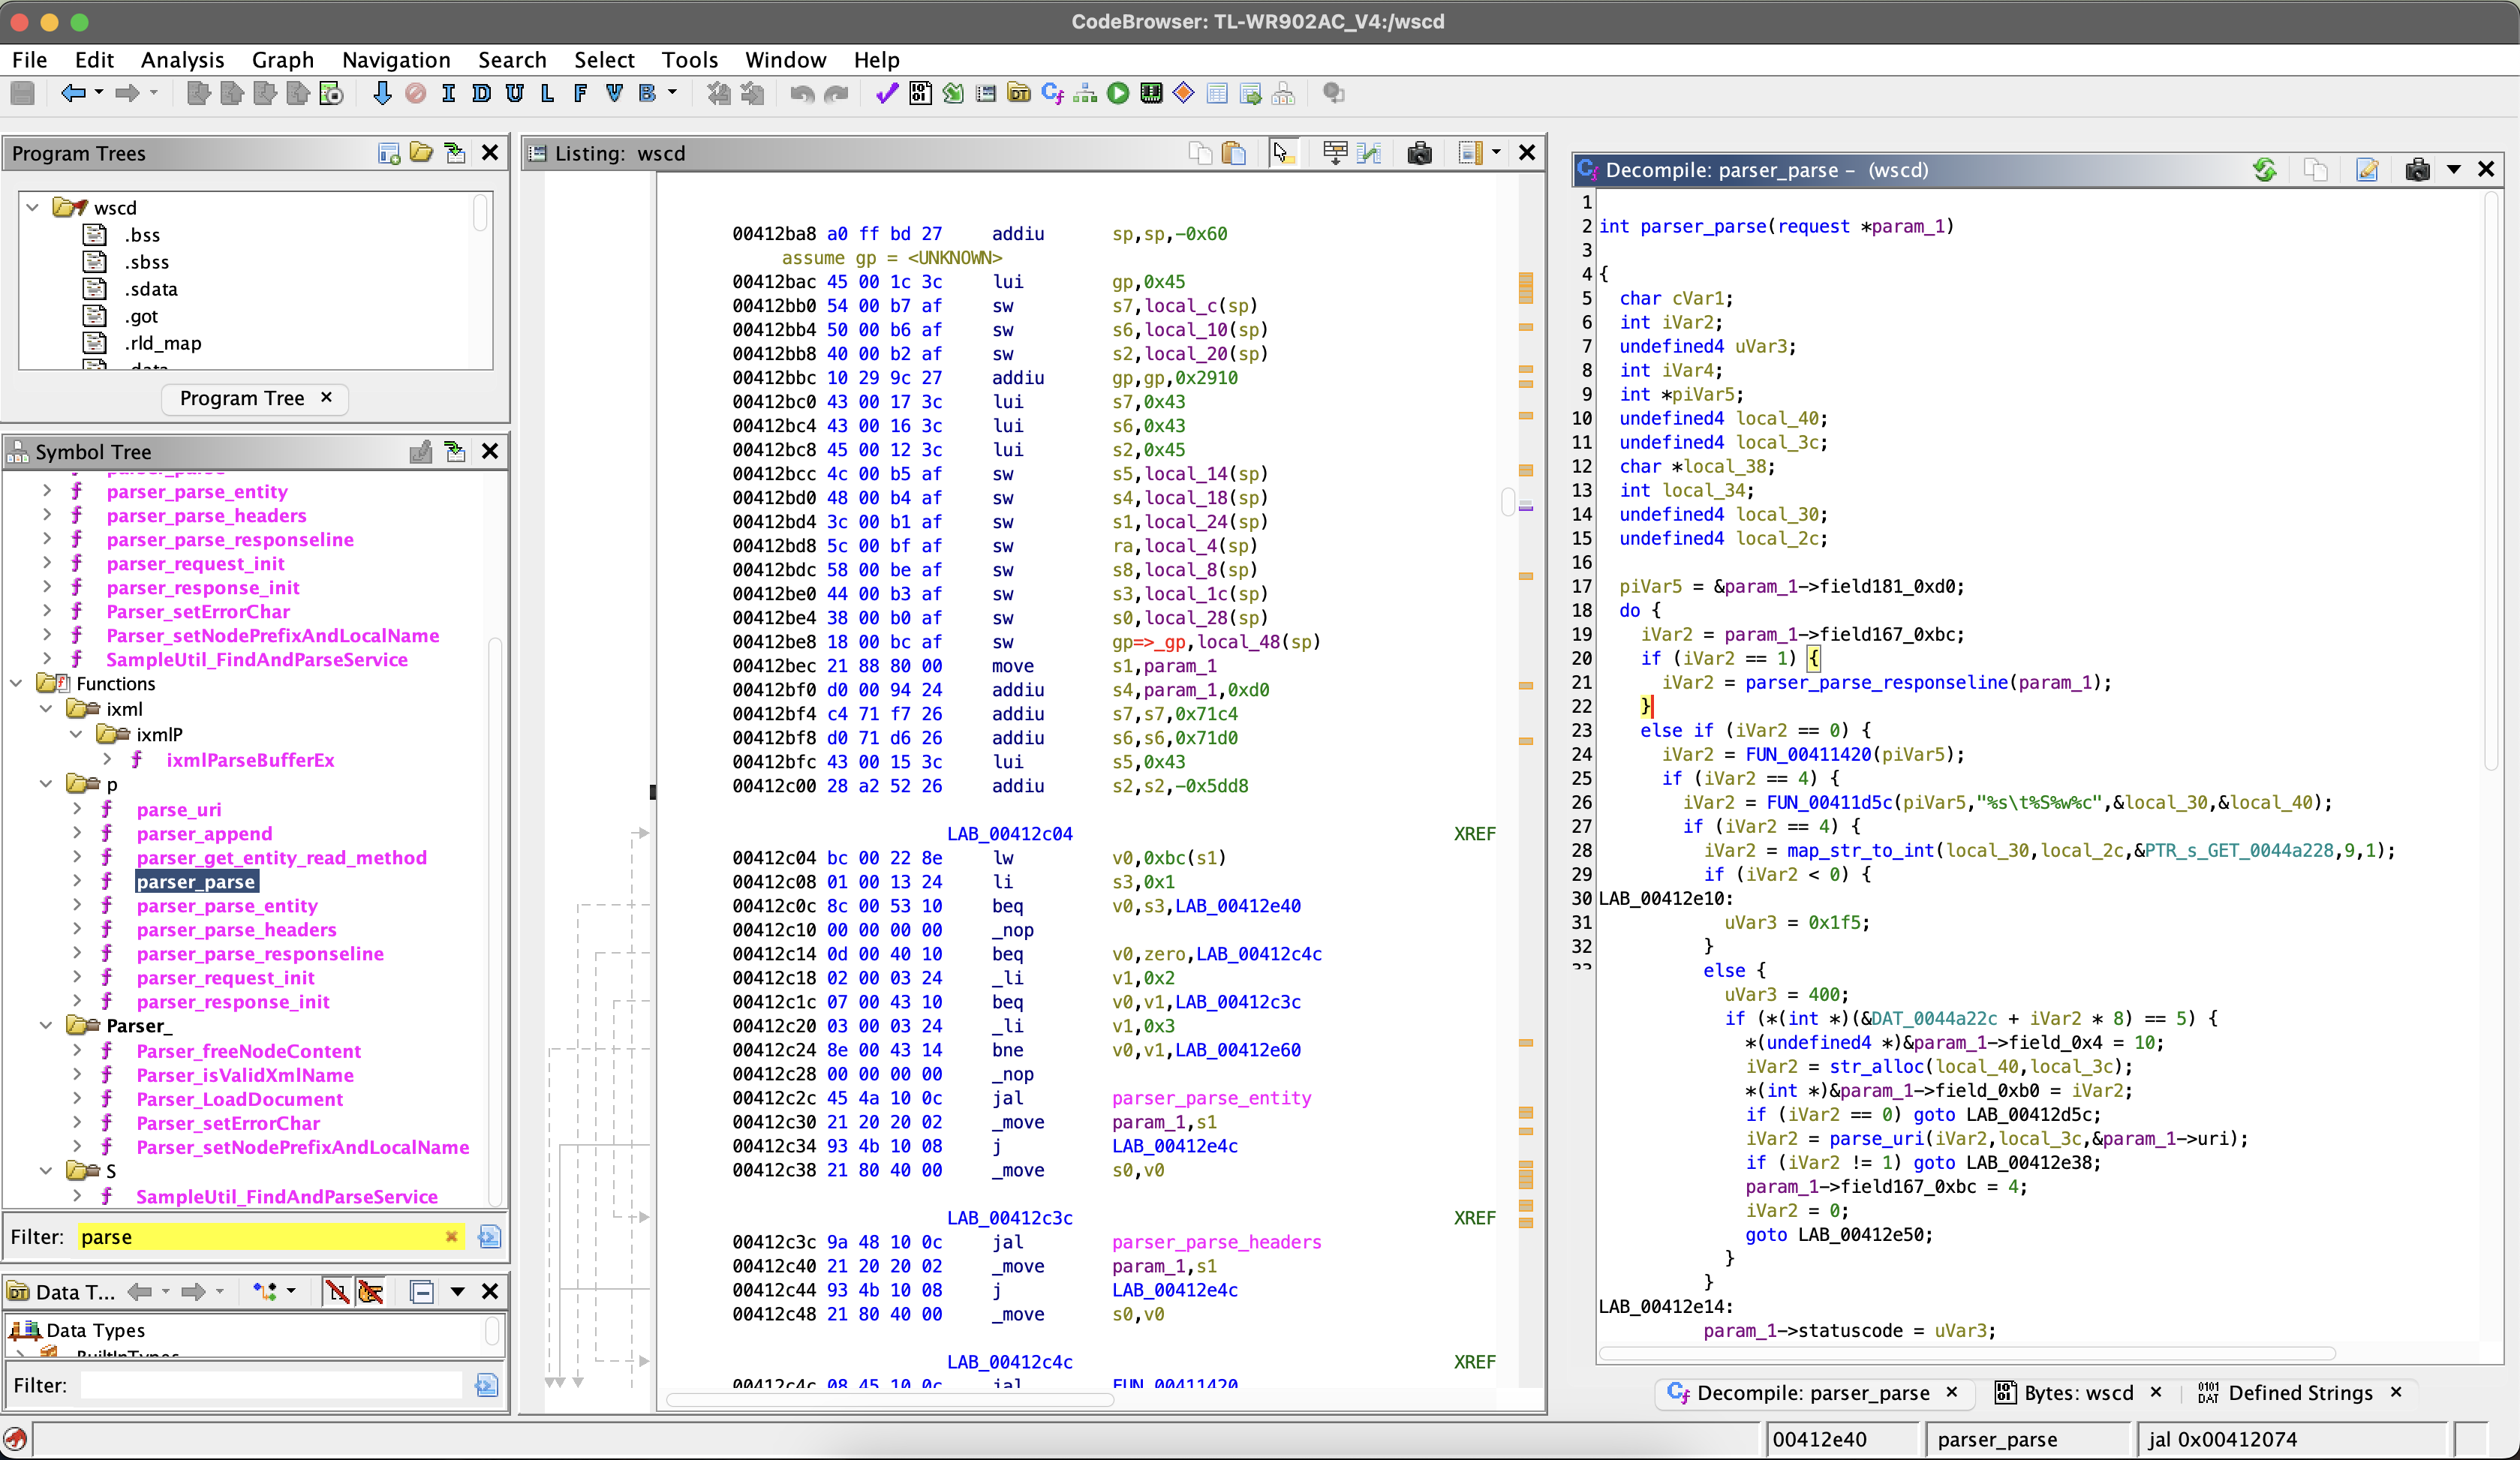
图 1:使用 Ghidra 搜索解析函数。
解析函数的一个好处是,它们通常不与其他部分的代码交互, 也不通过网络与用户交互。因此,解析函数可以直接用输入调用, 而无需修改二进制文件或覆盖其他函数,因此该函数可以被 模糊测试。
在开始对函数进行模糊测试之前,应检查该函数是否真的会被触发,
因为只有当函数被用户控制的输入调用时,它才值得关注。为此,
可以使用 Ghidra 搜索对目标函数的引用。以
parser_parse 函数为例,有多个途径。由于我们知道程序的启动方式,
可以将调用缩减为单一的函数调用树,如 代码 5 所示。
代码 5:函数 parser_parse 的调用树
找到目标函数后,我们现在可以创建一个模糊测试环境来对该函数进行模糊测试,这将在下一部分中描述。但首先介绍其他潜在函数。
为了撰写本文,我们手动分析了多个潜在二进制文件以寻找可疑函数。以下是发现的其他可能目标函数的简要总结。
二进制文件 httpd 是管理员 Web 界面的后端。该二进制文件可通过网络在 80 端口访问。在 httpd 中,一个有趣的函数是 httpd_parser_main 函数。使用 Ghidra 浏览解析器实现时,可以识别出几个不同的可疑代码部分。其中一个可疑部分是 Content-Type 的解析。下面是一个基本的 HTTP 请求。```txt
POST / HTTP/1.1\r\n
Content-Type: multipart/form-data; boundary=X;\r\n
Host: example.com\r\n
\r\n
\r\n
DATA\r\n
以下是 `httpd_parser_main` 函数的一个片段,该函数从用户提供的
http 请求中解析 `Content-Type`。


<div id="c6"></div>```c
// user_input_ptr points to
//  "Content-Type: multipart/form-data; boundary=X;\r\nHost: example.com\r\n..."
cursor = strstr(user_input_ptr,"multipart/form-data");

if (user_input_ptr == cursor) {
 cursor = strstr(user_input_ptr,"boundary=");
 user_input_ptr = cursor + 9;

 // user_input_ptr points now to "X;\r\nHost: example.com\r\n..."