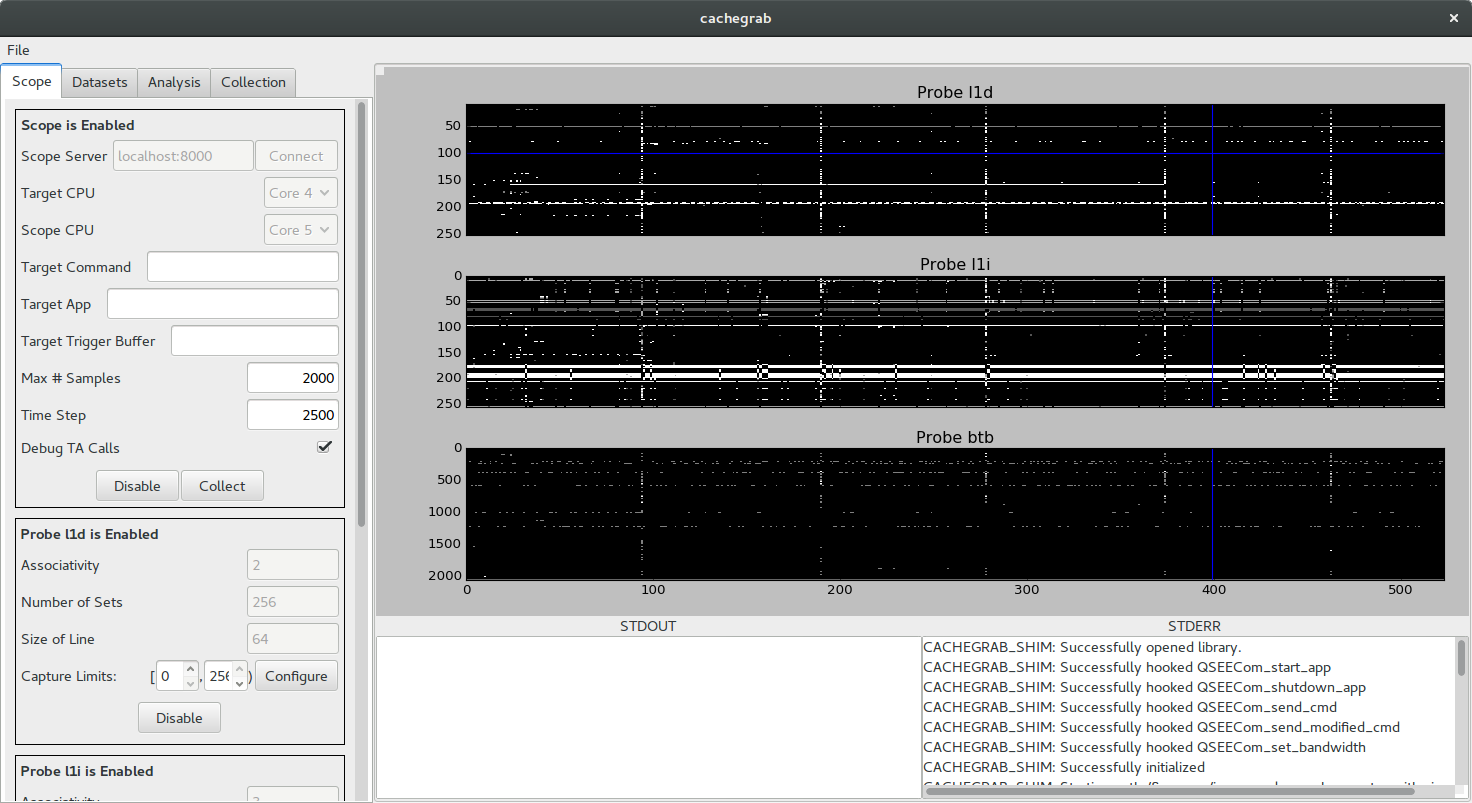
Cachegrab 是一款旨在帮助对支持 TrustZone 的 ARMv8 内核安全世界(secure world)中运行的软件执行并可视化跟踪驱动缓存攻击的工具。有关 Cachegrab 底层工作原理的概述,请参阅 Cachegrab 发布公告。
可以在 Android 设备上使用 Cachegrab。由于现代版本的 Android 不允许内核模块,因此应启用 CONFIG_MODULES 和 CONFIG_MODULE_UNLOAD 内核选项,重新构建内核,并将其刷写到设备中。针对内核源码构建 Cachegrab 内核模块,并使用 insmod 将其插入目标设备正在运行的内核中。
接下来,构建 Cachegrab 服务器和 shim 库,并将两者复制到 /data/local/tmp。启动服务器。最后,使用 adb forward tcp:8000 tcp:8000 将本地 TCP 端口 8000 绑定到设备的端口。
警告: 服务器允许攻击者指定任意 shell 命令来调用受害者代码。这些命令通过 HTTP 指定并以 root 权限运行,因此运行 Cachegrab 的测试设备必须位于可信网络中,这一点至关重要。
最后,加载 Cachegrab GUI 并连接到 localhost:8000。
Cachegrab 客户端围绕流水线(pipeline)的概念构建,该流水线处理包含攻击数据的样本。流水线由样本源、一组过滤器和分析器组成。样本源可以是文件系统上的位置、运行 Cachegrab 服务器的设备,或其他自定义来源。流水线从来源收集样本,并将每个样本传递给流水线中的各个过滤器,这些过滤器能够修改样本中的数据。最后,过滤后的样本被传递给分析器,由其执行攻击数据的最终处理。
客户端的许多功能都可以通过 GUI 交互使用,GUI 提供了一种简单的方式来管理一对有用的流水线。第一条流水线从“范围”(Scope)面板中配置的 Cachegrab 服务器收集样本。它将样本传递给一系列过滤器,并将过滤后的样本存储在数据集中。可以使用 GUI 导入或导出数据集,从而轻松传输样本数据。第二条流水线从数据集中获取样本,通过另一系列过滤器运行样本,并将过滤后的跟踪绘制到窗口中。

cachegrab 客户端 Python 模块也可以直接用于编写收集或分析脚本。以下脚本接收 GUI 导出的数据集,对每个样本中的跟踪执行一些处理,并打印出结果数据。
from cachegrab import Pipeline
from cachegrab.data import Dataset, Trace
from cachegrab.sources import DatasetSource
from cachegrab.filters import Filter
from cachegrab.sinks import AnalysisSink

class SampleFilter(Filter):
    def filter(self, sample):
        for t in sample.get_trace_names():
            data = sample.get_trace(t).data
            sample.set_trace(t, Trace(data - data.mean()))
        return sample

class SampleAnalysis(AnalysisSink):
    def analyze_once(self, sample):
        for t in sample.get_trace_names():
            print sample.get_trace(t).data

dataset = Dataset().load("exported_dataset_location")
pipeline = Pipeline(DatasetSource(dataset), SampleAnalysis())
pipeline.add_filter(SampleFilter())
pipeline.run()