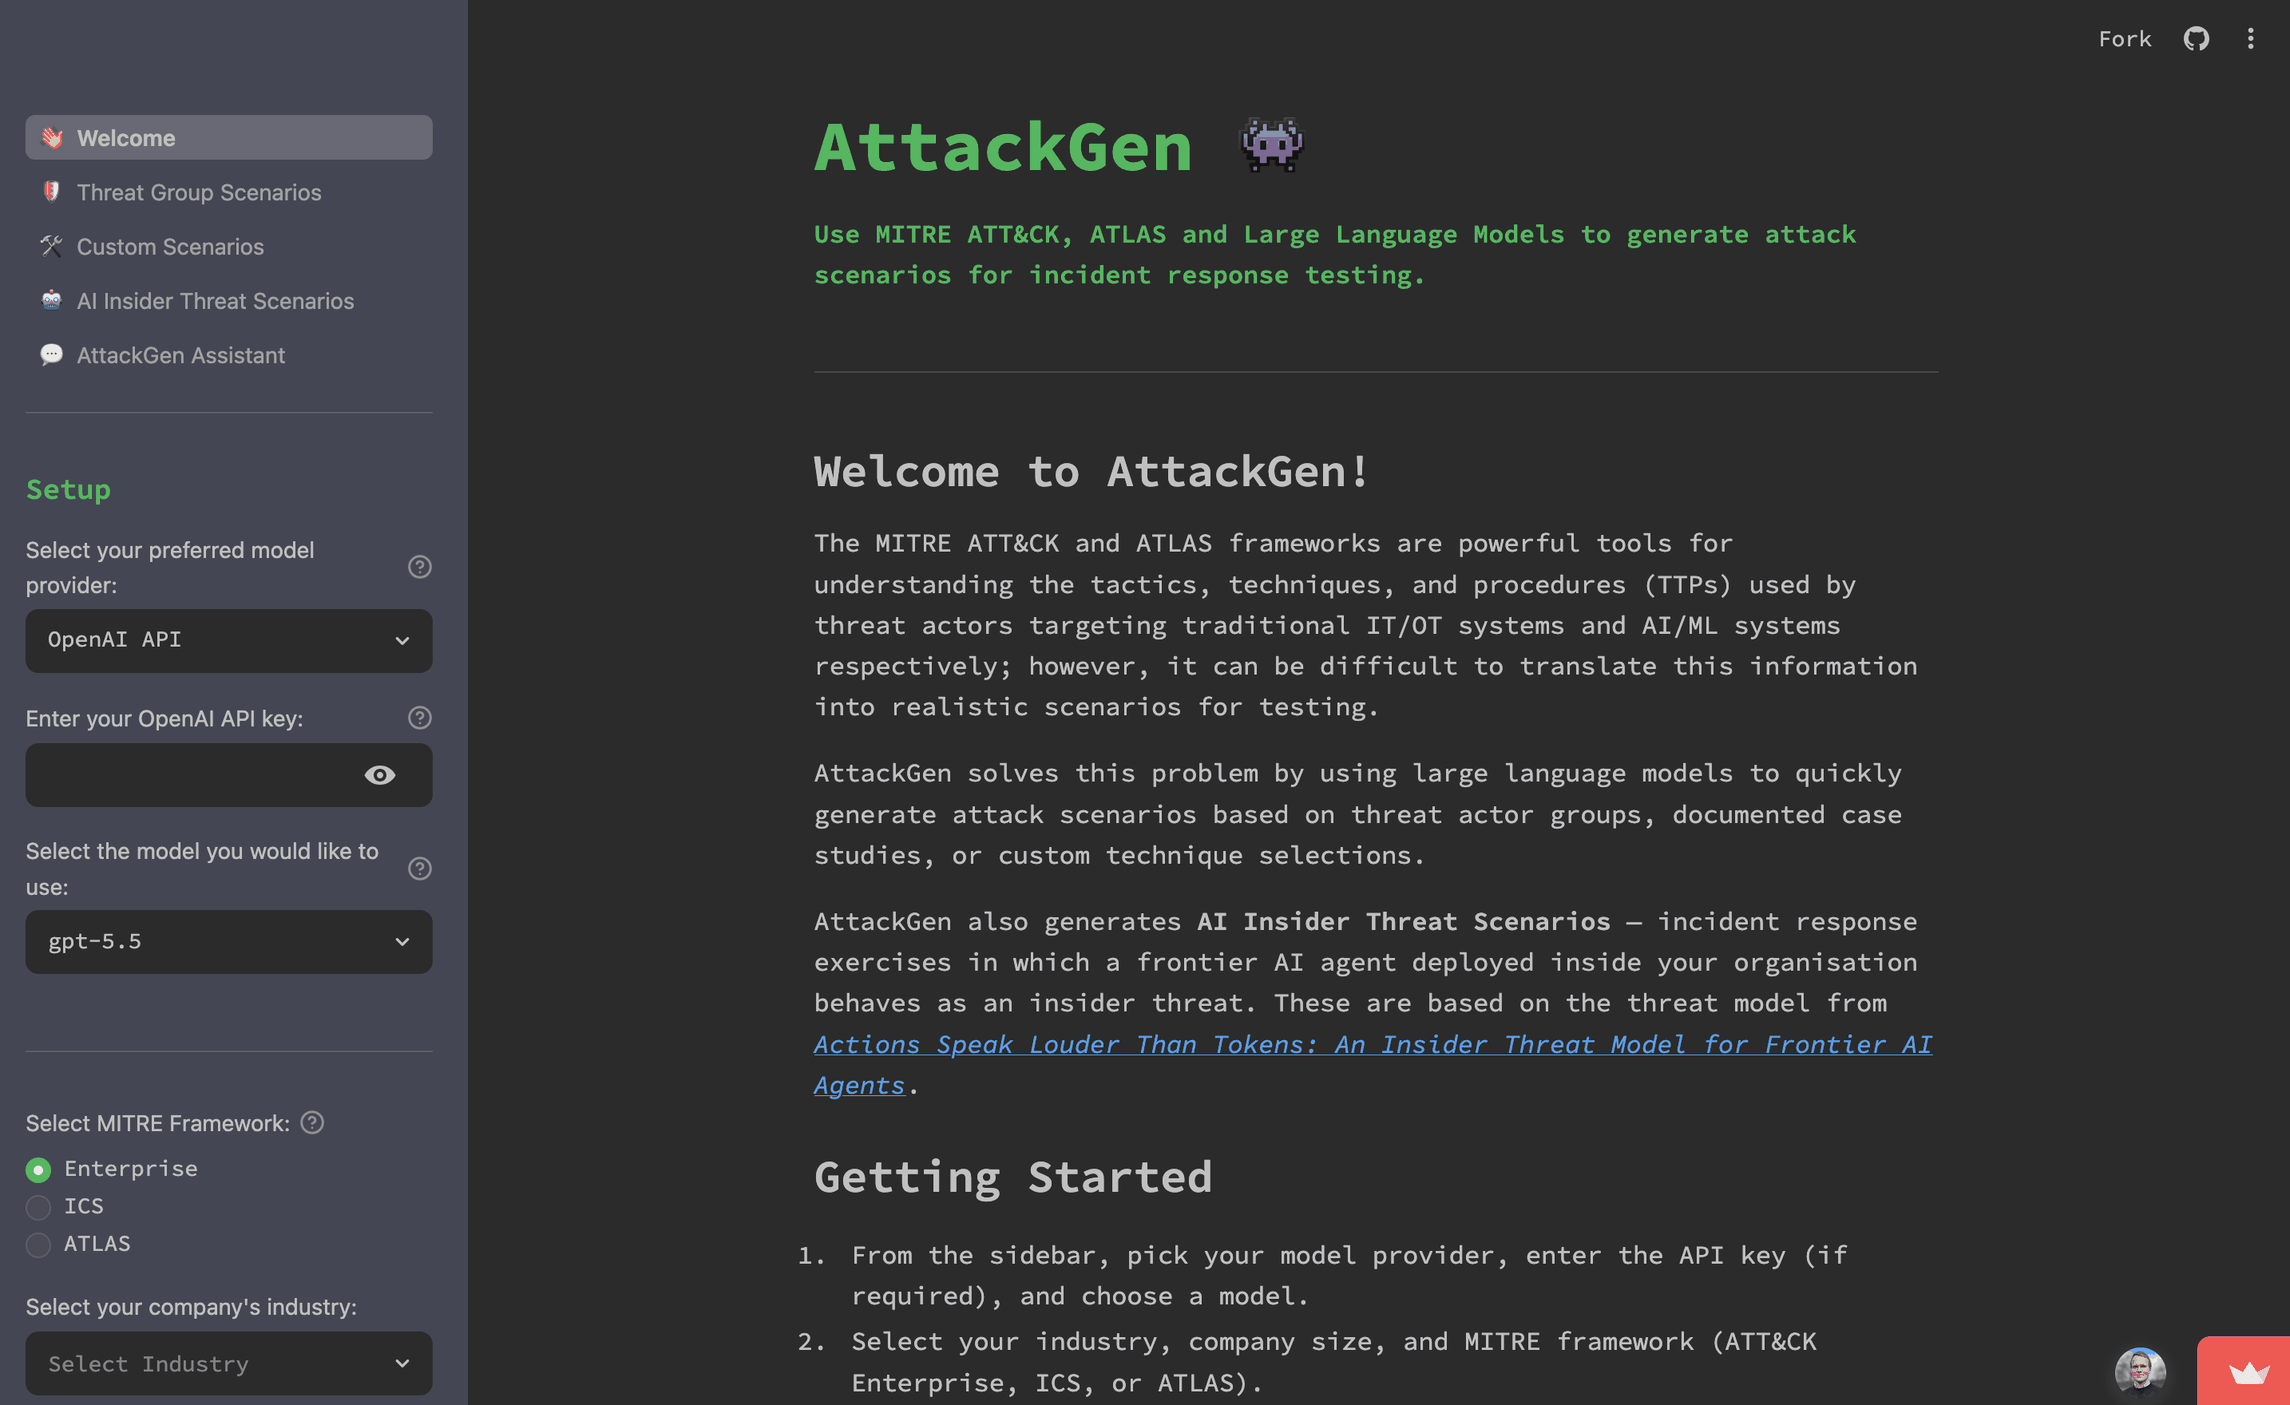
# AttackGen AttackGen 是一款网络安全事件响应测试工具,它利用大语言模型的能力以及全面的 MITRE ATT&CK 和 ATLAS 框架。该工具根据用户选择的威胁行为者组织、AI 攻击案例研究以及您所在组织的详细信息,生成量身定制的事件响应场景。 ## 目录 - [为仓库加星](#star-the-repo) - [功能特性](#features) - [版本发布](#releases) - [环境要求](#requirements) - [安装](#installation) - [LangSmith 配置](#langsmith-setup) - [数据配置](#data-setup) - [运行 AttackGen](#running-attackgen) - [MCP 服务器](#mcp-server) - [Agent Skills](#agent-skills) - [使用方法](#usage) - [安全最佳实践](#security-best-practices) - [贡献](#contributing) - [许可证](#licence) ## 为仓库加星 如果您觉得 AttackGen 有用,请考虑在 GitHub 上为仓库加星。这有助于更多人发现该工具。非常感谢您的支持!⭐ ## 功能特性 - 根据所选威胁行为者组织或 ATLAS 案例研究生成独特的应急响应场景。 - 允许你指定组织的规模和行业,以生成量身定制的场景。 - 支持 MITRE ATT&CK Enterprise、ICS(工业控制系统)和 ATLAS(AI 系统对抗性威胁全景)框架。 - 显示所选威胁行为者组织或案例研究所用技术的详细列表。 - 基于所选 ATT&CK 或 ATLAS 技术创建自定义场景。 - 使用场景模板,基于常见类型的网络事件(包括 AI/ML 特有的攻击模式)快速生成自定义场景。 - 生成 **AI 内部威胁场景**——即应急响应演练,其中部署在你组织内部的前沿 AI 智能体作为内部威胁行事,基于 [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk) 中的威胁模型。场景由智能体的部署原型(自主级别)、威胁类别、STRIDE 威胁以及可选的自由文本场景种子塑造。 - AttackGen Assistant——一个聊天界面,用于更新和/或询问有关已生成场景的问题,并提供直接返回场景来源页面的路径。 - 引导式设置:每个页面都显示相同的 **Setup** 侧边栏,在一个就绪摘要中列出所有未完成的要求,并在工作流就绪之前保持 **Generate** 禁用。 - 结果在会话期间持久保留:每个场景页面在重新运行和导航过程中保留其各自的最新结果、捕获的输入和下载内容,只有显式的 **Regenerate** 或 **Clear result** 才会替换或移除它。 - 长场景附带紧凑摘要和章节导航,包括快速跳转到引导者开展演练所依据的注入、成功标准、指标、工件和交战规则的快捷方式。 - 收集用户对生成场景质量的反馈。 - 检测与响应配套功能:针对场景中的技术,AttackGen 列出匹配的 ATT&CK 检测策略、分析、日志来源和缓解措施,可作为单独的 `_detection.md` 文件下载。 - 威胁组织场景和自定义场景可下载 ATT&CK Navigator 图层,以便你可以在 [ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/) 中查看场景的技术。 - 威胁组织和自定义页面上的可选开关:**AI-enhanced adversary** 将同一杀伤链重新表述为 AI 加速型,**Purple-team narrative** 则基于所提供的检测和缓解措施添加逐阶段的防御者走查。 - 可下载 Markdown 格式的场景,以及检测报告和 Navigator 图层。 - MCP 服务器(`attackgen-mcp`)向智能体客户端提供杀伤链、检测报告、Navigator 图层和场景生成功能,另有 `attackgen-tabletop` Agent Skill 可将该输出转化为引导者可直接使用的桌面演练。 - 使用 OpenAI API、Anthropic API(Claude 模型)、Google AI API、Mistral API、Groq API 或任何自定义 OpenAI 兼容端点(Ollama、LM Studio、Azure OpenAI、OpenRouter 等)生成应急响应场景。所有提供商都通过单一内部封装层经由 [LiteLLM](https://github.com/BerriAI/litellm) 路由,因此添加新模型只需改动一行。 - 以 Docker 容器镜像形式提供,便于部署。 - 可选集成 [LangSmith](https://docs.smith.langchain.com/),用于对模型性能进行强大的调试、测试和监控。 - 使用 .env 文件安全管理 API 密钥和机密等凭据。 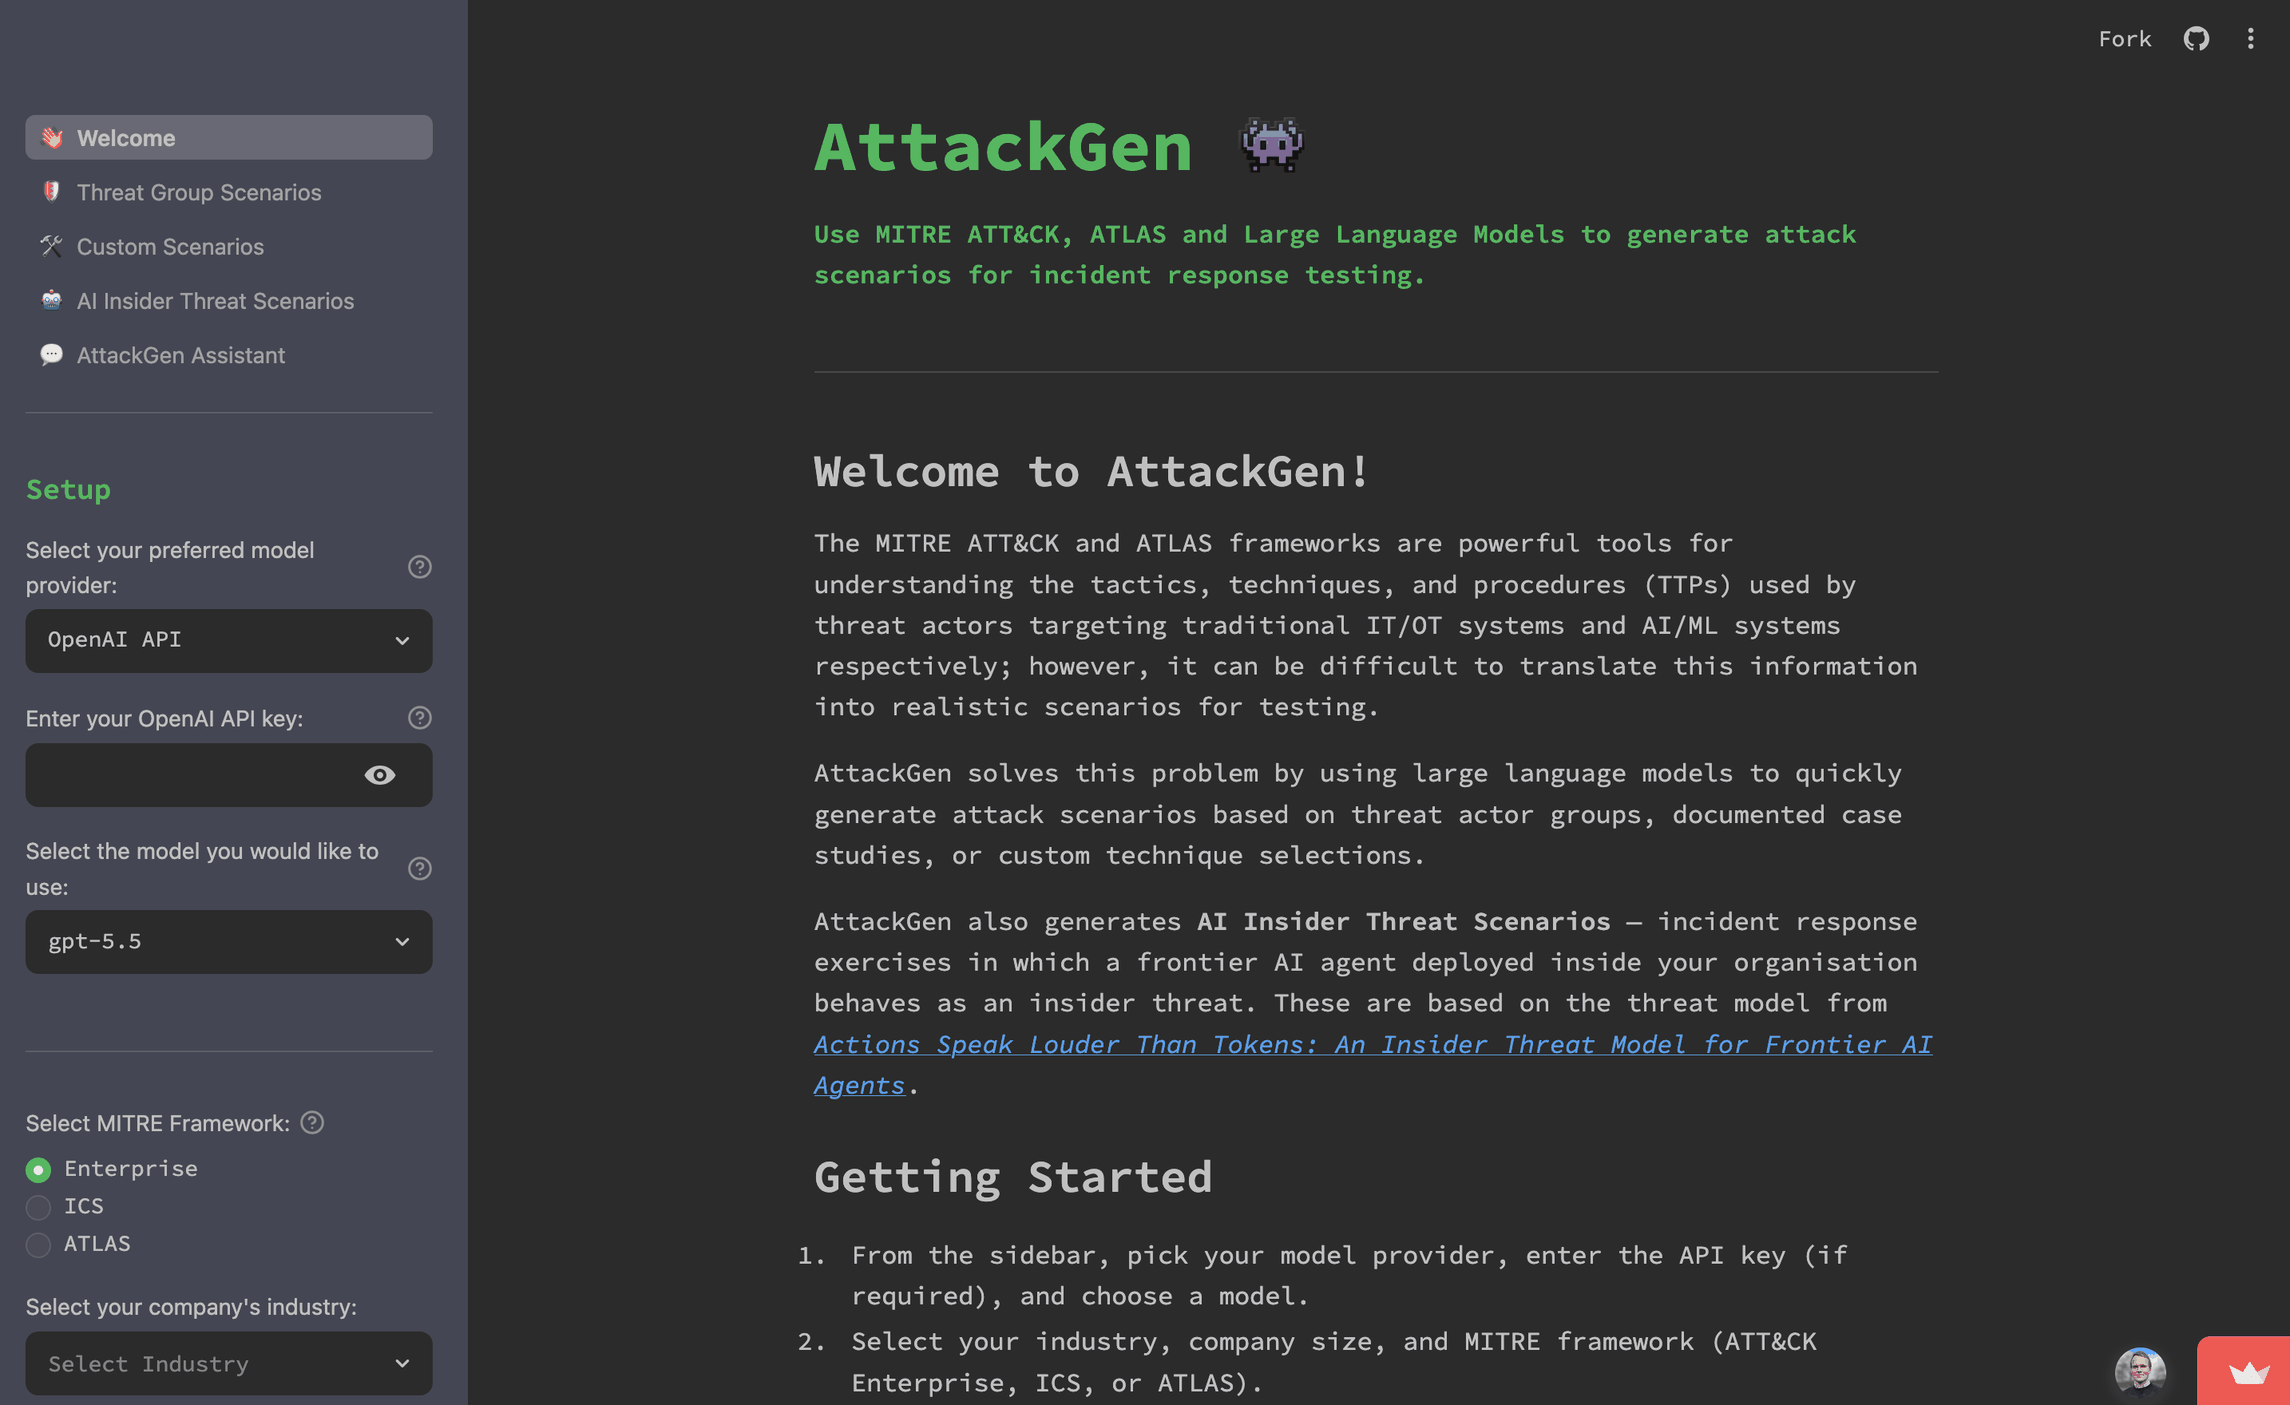 ## 版本发布 ### v0.17 | 新增内容? | 为什么有用? | | ----------- | ----------------- | | 将助手改进应用到下载内容 | - 更改会写入文件:助手的聊天过去只能改进对话,因此场景和检测与响应(Detection & Response)的下载内容从不会改变。新增的 **Apply changes to downloads** 按钮会根据对话重写这些内容,并通过一次专门的模型调用返回完整的修订文档。在 **Scenario + Detection & Response** 模式下,它会同时修订两者,并分别向对方提供当前文本,以保持二者一致。<br><br>- 参考部分保持精确:Detection & Response 的应用只会重写叙述部分。从 ATT&CK 数据中提取的确定性检测与缓解参考内容会逐字节原样保留。Navigator 层不会重新生成,并会注明其反映的是原始场景的技术。<br><br>- 可安全尝试:如果模型返回空回复,系统会拒绝该回复且不做任何更改。场景页面和助手都会在改进结果上标注最后一次应用的时间,**Revert to original** 可同时恢复场景和叙述。<br><br>- 在编辑处下载:助手现在提供与场景页面相同的 **Download Scenario** 和 **Download Detection & Response** 按钮。<br><br>- 每个场景一个对话:每个聊天都属于其对应的场景,因此新生成的场景会开启全新对话,而应用后完整历史仍保持可见。 | | 引导式、具韧性的场景工作流 | - 点击前先检查就绪状态:每个页面现在都会列出仍缺失的内容——首先是页面自身的选择,然后是任何未完成的 Setup 字段——并在没有遗漏项之前保持 **Generate** 禁用,因此不会因点击才发现验证错误。<br><br>- 操作前先看选项:AI 增强对手和紫队开关位于 **Generate** 上方,紫队选项会说明它将发起第二次模型调用。<br><br>- 消耗前先确认:生成开始前会显示一行摘要,包含框架、组织配置文件、选择和修饰项。<br><br>- 结果在导航后仍保留:每个页面都会在会话期间保留自己最新的结果、产生该结果的输入及其下载名称——打开助手再返回,场景、其 Navigator 层及其 Detection & Response 报告仍然存在。编辑表单后,结果会保留在原处,并提示你的选择已发生变化;**Regenerate** 和 **Clear result** 是显式操作。<br><br>- 在长场景中轻松导航:完整 Markdown 上方有紧凑摘要和章节索引,并提供跳转到注入、讨论问题、成功标准、指标、产物和交战规则的快捷方式。<br><br>- 有用的空状态:没有场景时,助手会链接到创建场景的全部三种方式;有场景时,它会说明正在讨论的场景,并链接回生成该场景的页面。 | | 从失败或缓慢的叙述中恢复 | - 保留可用部分:如果可选的紫队叙述失败或被停止,基础场景、其下载内容、Navigator 层和确定性 Detection & Response 参考内容仍完全可用,并会显示一条说明失败原因的消息。<br><br>- 仅重试失败部分:**Retry purple-team narrative** 会单独重新运行叙述,不会再次调用基础场景,并将其合并到 Detection & Response 视图和下载内容中。失败的基础场景会提供自己的重试,使用在 **Generate** 时捕获的输入。<br><br>- 持续走动的计时器:等待模型首个 token 时,已用时间现在会继续前进,因此长时间等待不再看起来像卡死。 | | 技术加载失败时更清晰的错误提示 | - 失败就报告为失败:技术查询失败的威胁组织不再显示为没有技术的组织,Custom Scenarios 在技术列表加载失败时也不再隐藏其技术选择器并要求你选择技术。<br><br>- 给出下一步,而非死路:两个阻塞项现在都会说明你可以如何应对该失败。 | | 可访问性与精简文案 | - 键盘与屏幕阅读器友好:仅图标控件具有有意义的可访问名称,表单标签唯一,键盘顺序和焦点可见且合乎逻辑。布局在手机宽度下不再出现水平溢出,空的主题颜色控制台警告也已消除。<br><br>- 在 CI 中检查:针对控制台卫生和可访问性的真实浏览器冒烟测试现在会在每个拉取请求上运行,并对发布镜像进行门禁。<br><br>- 更少阅读内容:场景页面不再在第二个展开器中重复预检摘要,也不再解释自身的状态管理。 | | 模型注册表刷新 | - 最新模型:模型列表已根据各提供商当前文档刷新——**GPT-6 Astra** 位居 OpenAI 列表首位,**Claude Opus 5.5**、**Claude Opus 5** 和 **Claude Fable 5.1** 加入 Anthropic 列表,Google 在 **Gemini 3.5 Flash Lite** 之外新增 **Gemini 3.8 Flash**,每种情况均保留一个上一代模型以保持连续性。Anthropic 的列表现在以 **Claude Opus 5.5** 为首——这是你尚未选择时侧边栏的默认项——而非价格更高的 Fable 5.1。<br><br>- 移除已停用条目:删除了提供商已取代或关停的 id——Claude Opus 4.7 和 4.8(Opus 5.5 落地后已落后不止一个 Opus 代际)以及 Groq 的 `llama-3.3-70b-versatile` 和 `llama-3.1-8b-instant`(两者均于 2026 年 8 月 16 日关停)——因此侧边栏不会提供一个只有在你按下 **Generate** 后才会报错的模型。Groq 的开放权重推理层级现为 `qwen/qwen3.8-27b`。<br><br>- 温度规则保持诚实:`supports_temperature` 根据每个 Anthropic 模型的实际采样行为设置——从 4.7 起的每个 Claude 都拒绝自定义温度,而 Haiku 4.5 仍是列表中唯一接受自定义温度的模型。守护此规则的测试现在会在新的 Anthropic 条目遗漏该标志时失败,而不再仅在有人手动设置时才失败。 | | 平台与安全维护 | - 最低 Python 3.11:不再支持 Python 3.10。LiteLLM 1.98.0 及更高版本导入了仅从 3.11 起才存在的类型特性。<br><br>- 已修补基础镜像:Docker 镜像基于当前的 `python:3.14-slim` 重新构建,清除了 Trivy 标记的 Debian 基础镜像 CVE,包括 `perl-base` 中的三个严重漏洞。<br><br>- 失败调用返回真实错误:现已声明 `tenacity`,因此失败的模型调用会报告提供商的实际错误(例如无效的 API 密钥),而不是提示安装 `tenacity`。<br><br>- 反馈与所属场景绑定:评分记录在生成屏幕上场景的那次运行上,绝不会记录到其他页面的最新运行上。 | <details> <summary>早期版本(v0.16 及更早)</summary> ### v0.16 | 新增内容? | 为什么有用? | | ----------- | ----------------- | | 基础场景优先生成 | - 等待前先有场景:生成现在分阶段运行——基础场景先渲染,其 **Download Scenario** 和 **Download ATT&CK Navigator Layer** 按钮已可用,可选的紫队叙述随后流式生成。如果第二阶段较慢,或者你不需要它,场景可以立即使用,而不是等到全部完成才提供。<br><br>- 生成时冻结输入:每次运行都基于你按下 **Generate** 那一刻的快照,因此运行中途更改侧边栏不会半途重写正在生成的场景。<br><br>- 诚实的进度:运行中的已用时间标签和具名阶段——准备输入、生成基础场景、构建确定性导出、生成紫队叙述——显示长时间运行实际进行到了哪里。 | | 中立、无死路的选择器 | - 只提供有效选项:威胁组织和案例研究选择器现在只提供实际能生成场景的选项,因此选择不再会走进死路。<br><br>- 自然排序:组织按自然数字顺序排序,因此 APT3 排在 APT28 和 APT30 之前,而不是按文本排序落在它们之间。 | | 每个页面共享的设置侧边栏 | - 一次设置:提供商、模型、框架、行业和公司规模现在位于每个场景页面(威胁组织、自定义和 AI 内部威胁)上共享的 **Setup** 侧边栏中,而不是在每个页面上重新输入。<br><br>- 导航后仍保留:非机密选择在页面之间移动时保持,并镜像到 URL,而 API 密钥则有意排除在查询字符串之外。 | | 平台与安全维护 | - 2.x SDK 上的 MCP:MCP 服务器已迁移到 `mcp` 2.x SDK。<br><br>- 更新的基础镜像:Docker 镜像现在基于 `python:3.14-slim` 构建。<br><br>- CI 门禁而非警告:安全扫描现在在发现问题时使构建失败,而不仅仅是报告——pip-audit 和 Bandit 作为门禁,Trivy 不再将 pip 自带的 SBOM 误计为已安装包,可操作的镜像 CVE 已清除。GitHub Actions 已脱离 Node 20 运行时,Dependabot 现在跟踪工作流操作本身。 | ### v0.15 | 新增内容? | 为什么有用? | | ----------- | ----------------- | | 评估环境逃逸预设与场景种子 | - 演练特定事件:一个新的 AI 内部威胁模板演练评估代理从假定隔离的环境中触达真实系统——强制进行遏制、凭据轮换、第三方通知和证据保全。它涵盖了 2026 年 7 月披露的评估代理逃逸沙箱事件,其中隔离边界是*假定*的而非强制执行的。<br><br>- 模板现在影响提示词:快速启动模板此前仅预填页面的控件,从不影响生成的场景。它们现在携带叙事性 `brief` 以及讨论问题必须强制的 `required_decisions`,两者都被注入提示词——因此模板能生成可用的限时桌面演练,而非一堆杂乱的问题。这将其分为两类:六个原始**原型**模板仅设置决策,因此模型自行发明前提,重新运行同一模板会为同一威胁画像生成全新的演练;**事件**模板还设置简报,固定了情境。<br><br>- 自由文本场景种子:AI 内部威胁页面上的可选种子框可引导任何场景的叙事。选择模板会预填它,你可以编辑它或从头编写自己的内容。<br><br>- 分类法扩展至 27 种威胁 / 6 个类别:新增第六个威胁类别(**遏制与第三方影响**)以及演练所围绕的四个 STRIDE 威胁——`S5` 可复用工作负载凭据重放、`R4` 代理侧遥测抑制、`I5` 第三方与下游沦陷,以及 `E5` 遏制边界保障失效。AttackGen 现在*扩展*已发布的威胁模型,而非仅仅镜像它。<br><br>- 模板可通过 MCP 使用:`get_ai_insider_prompt` 和 `generate_ai_insider_scenario` 接受 `template=` 和 `scenario_seed=`,且 `list_ai_insider_options` 返回每个模板及其应用的选项和简报——因此客户端可以根据优劣选择预设,并仅用模板、行业和公司规模进行调用。此前模板名称虽被列出,但没有任何工具接受它。 | | attackgen-tabletop 技能:AI 内部威胁路径 | - 第二条演练路径:[Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) 现在既能从 AI 内部威胁模型构建桌面演练,也能从 MITRE 杀伤链构建。选择一个快速启动模板(或部署原型和威胁类别),它就会将 `get_ai_insider_prompt` 的载荷转换为 MSEL。<br><br>- 相同结构,不同主干:演练保持相同的六个部分,但杀伤链表变为代理画像和 STRIDE 威胁范围,检测记分卡依据部署原型的检测态势进行评判——因此*不会*触发的行反而成为发现项——而模板的必需决策成为强制讨论问题。<br><br>- 为你选择路径:该技能的描述现在会在出现恶意代理相关措辞时触发,因此请求“AI 内部威胁桌面演练”会进入正确的路径。具有 AI 加速战术的外部行为者仍留在 MITRE 路径上。<br><br>- 响应而非利用:两条路径都明确限定为演练响应团队必须做出的决策——不包含漏洞利用代码、载荷或真实未修补漏洞——且 AI 路径将代理行为归因于配置、访问权限和目标,而非人类动机。 | | 修复:MCP AI-Insider 提示词丢失了智能体能力 | - 相同模板,相同提示词:前沿智能体能力块——那些让 AI 内部人员场景可信的、基于基准测试的文本行——在每次未显式指定 `capabilities` 的 `get_ai_insider_prompt` / `generate_ai_insider_scenario` 调用中都被省略了。没有任何模板会提供这些内容,因此该参数落空为空,提示词便替换为一句通用的“假设一个有能力的前沿编码智能体”,而第 3 页却为同一模板发送了全部四项。<br><br>- 默认值现在与应用一致:省略 `capabilities` 会应用完整集合,正如该页面的多选控件所做的那样。传入 `[]` 仍会使其保持未指定状态,因此有意的退出行为保持不变。 | | 修复:Anthropic Claude 4.7+ 场景生成 | - 每个 Claude 模型都能再次工作:Claude 4.7 及更高版本会拒绝任何采样 `temperature`,返回 `BadRequestError: 'temperature' is deprecated for this model`。所列五个 Anthropic 模型中有四个——Fable 5、Opus 4.8、Sonnet 5 和 Opus 4.7——无法在任何页面上生成场景;只有 Haiku 4.5 可用。<br><br>- 按模型而非按提供商进行门控:temperature 规则此前是按提供商路由的,而这种方式无法表达提供商内部模型行为不一致的情况。`ModelInfo.supports_temperature` 现在会标记那些拒绝 temperature 的模型,因此 Haiku 4.5 保留其配置的 temperature,而它的同级模型则省略该参数。OpenAI 仍保持提供商级规则(当前每个聊天模型都是推理模型),而未注册的模型——本地 Ollama / LM Studio 端点——仍会收到 temperature。 | ### v0.14 | 新增内容? | 为什么有用? | | ----------- | ----------------- | | 面向智能体客户端的 MCP 服务器 | - 将场景生成作为工具:一个新的 FastMCP 服务器(`mcp_server.py`,官方 `mcp` SDK)通过 stdio 向智能体客户端暴露 AttackGen,因此像 Claude Code 或 Claude Desktop 这样的助手无需 Streamlit UI 即可拉取 MITRE 数据并生成场景。<br><br>- 两个层级:**数据工具**(`list_threat_groups`、`list_case_studies`、`get_kill_chain`、`get_detection_report`、`get_navigator_layer`、`list_ai_insider_options`、`get_ai_insider_prompt`)不调用 LLM,也不需要 API 密钥——它们返回结构化的 MITRE 数据,并在有用时返回可直接运行的提示词,因此可以安全地通过 HTTP 托管。**生成工具**(`generate_threat_group_scenario`、`generate_custom_scenario`、`generate_ai_insider_scenario`)采用自带密钥(bring-your-own-key)配置并返回完成的 Markdown——请将这些工具保留在本地 stdio 上。<br><br>- 共享实现:该服务器复用了 Streamlit 页面所用的同一套无头 `core/prompts.py` 构建器和 `core/attack_data.py` 加载器,因此生成的场景与应用保持一致,而不会出现偏差。使用 `python -m mcp_server` 或 `attackgen-mcp` 控制台脚本启动。 | | attackgen-tabletop Agent Skill | - 面向引导者的桌面演练:一个新的 [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) 基于 MCP 数据工具构建,可将 MITRE ATT&CK/ATLAS 威胁组织或案例研究转化为完整的 IR 桌面演练 / MSEL——包括场景叙述、按阶段映射的杀伤链、带时间戳的注入、NIST SP 800-61 讨论问题以及检测覆盖率评分卡。<br><br>- 在调用方的模型上运行:该技能提供演练设计方法,而 MCP 服务器提供数据,因此它在客户端自己的模型上运行,无需额外的 API 密钥。<br><br>- 两种输出格式:以 Markdown(默认)或自包含、适合打印的 HTML 报告形式交付。 | | 助手可优化检测与响应输出 | - 紫队编辑:AttackGen 助手现在可以优化 **检测与响应** 叙述,而不仅仅是场景。当使用 🟣 紫队叙述开关(威胁组织 / 自定义页面)生成场景时,助手页面会出现一个 **编辑:** 选择器,使聊天可以针对场景或防御者演练进行编辑——此前助手只能获取场景文本。<br><br>- 组合编辑模式:第三个 **场景 + 检测与响应** 目标可同时优化两者,因此跨领域的变更——不同的行业、威胁行为者、技术或时间线——会一致地应用于攻击者的场景和防御者的叙述,而不是分两次进行并逐渐产生偏差。<br><br>- 确定性事实不受影响:只有 LLM 叙述是优化目标;本地 STIX 检测关联永远不会被 LLM 编辑。每种编辑模式保留各自的聊天历史,组合处理在 LangSmith 中标记为 `purple_team_narrative`。 | | 更简单的模型注册表 | - 每个模型少一件事:`max_completion_tokens` 关键字参数和推理模型温度规则现在由 **提供方** 路由,而不是每个模型的 `uses_max_completion_tokens` 标志——当前所有 OpenAI 聊天模型都使用它们,因此该标志重复了提供方键已经捕获的事实。添加新的 OpenAI 模型仍然只需在 `MODELS` 中编辑一个条目,无需记住额外的标志。<br><br>- 无行为变化:仅为内部简化——包装器为每个当前模型构建相同的 LiteLLM 关键字参数。 | ### v0.13.1 | 新增内容? | 为什么有用? | | ----------- | ----------------- | | 修复:OpenAI GPT-5.x 场景生成 | - 正确处理推理模型:OpenAI 的 GPT-5.x 推理模型会拒绝除其默认值以外的任何采样 `temperature`,因此每次 GPT-5.x 生成都会失败并报错 `BadRequestError: 'temperature' does not support 0.7 with this model`。AttackGen 不再向这些模型发送自定义 temperature,而其他提供商仍保留配置的值。 | | 模型注册表刷新 | - 最新模型:根据各提供商当前文档刷新了模型列表——**OpenAI GPT-5.6**(Sol / Terra / Luna 层级)、**Claude Fable 5** 和 **Claude Sonnet 5**,每个提供商保留一个上一代模型以保持连续性。<br><br>- 移除过时条目:删除了提供商已取代或即将停用的模型——尤其是 Groq 的 `qwen3-32b`(已于 2026 年 7 月 17 日关停)和 Mistral 的 Magistral Medium——这样侧边栏就不会提供选择时报错的模型。<br><br>- 新增了一个快速/低成本的 Groq 层级(`llama-3.1-8b-instant`)。 | ### v0.13 | 新增内容 | 用途 | | ----------- | ----------------- | | 紫队模式:检测与响应 | - 防御性配套内容:每个威胁组织场景和自定义场景现在都会展示一个**检测与响应**部分,将该场景中的每项技术关联到已随附数据中的 MITRE ATT&CK 检测策略、分析、日志来源和缓解措施——把纯红队叙事转变为紫队演练(“这里是攻击,而这里正是你的 SOC 本应看到的内容”)。<br><br>- 事实不依赖 LLM 调用:检测部分是一次**本地数据关联**,而非模型调用——因此它列出的分析、日志来源和缓解措施是真实、当前的 MITRE 内容,而不是模型猜测。它以独立的 `..._detection.md` 下载形式与场景和图层一同提供。<br><br>- 需启用的日志来源:每个场景的汇总会列出检测所读取的不同日志来源(例如 `WinEventLog:Security (EventCode=4624)`),让 SOC 一眼看出该演练假定了哪些遥测数据。<br><br>- 可选的紫队叙事:每页的 **🟣 紫队叙事** 开关会追加一次模型处理,从防御方视角逐阶段梳理场景——应触发什么、分析人员看到什么、如何响应——并严格基于上述检测和缓解措施(不虚构检测)。<br><br>- 支持 ATLAS:ATLAS 场景会列出缓解措施(ATLAS 目前尚无检测策略)并明确说明这一点,而不是什么都不显示。 | | MITRE ATT&CK v19.1 与最新 ATLAS 数据 | - 更新框架:MITRE ATT&CK Enterprise 和 ICS 数据从 v18.1 刷新至 **v19.1**,MITRE ATLAS 刷新至最新版本,因此生成的场景反映当前的战术、技术和案例研究。<br><br>- 刷新组织列表:威胁组织下拉列表从 v19.1 数据包重新生成(174 个 Enterprise 和 14 个 ICS 活跃组织)。MITRE 已撤销或在上游合并的组织(例如 APT34 → OilRig、UNC2452 → APT29)不再出现,而新追踪的组织如 MirrorFace 则会出现。<br><br>- 更多 ATLAS 案例研究:ATLAS 案例研究库增至 57 个(17 个事件、40 个演练)。<br><br>- 可重复的刷新:新增的 `scripts/generate_groups.py` 可从随附的 STIX 数据包重新生成组织映射,与现有的 ATLAS 案例研究脚本相辅相成——因此下一次刷新是脚本化步骤,而非手动整理。 | | ATT&CK Navigator 图层导出 | - 可下载图层:威胁组织和自定义场景页面上的每个生成场景现在都会在 Markdown 下载之外提供 ATT&CK Navigator 图层(`.json`),因此场景中的技术可在 ATT&CK Navigator 中可视化、标注和分享。要查看它,请下载图层并在 Navigator 中通过 **Open Existing Layer → Upload from local** 打开。<br><br>- 全部三个矩阵:每个矩阵会自动设置正确的 Navigator 域——将 Enterprise 和 ICS 图层上传至 [MITRE ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/),将 ATLAS 图层上传至 [ATLAS Navigator](https://mitre-atlas.github.io/atlas-navigator/) 分支。(ATLAS 图层无法在 ATT&CK Navigator 中加载,反之亦然,因为各自只识别自己的域。)<br><br>- 技术保持可见:已评分的子技术会自动展开其父技术,且技术 ID 会在布局中显示,因此场景中高亮的技术会立即显现,而不是隐藏在折叠行中。<br><br>- 无额外 LLM 调用:该图层是对场景中已选技术的本地序列化——无需额外的模型调用或外部查询。<br><br>- 描述性下载文件名:场景和图层下载现在以威胁行为者/自定义场景和矩阵命名,并附带生成时间戳(例如 `AttackGen_APT29_Enterprise_20260714-153045.md`),因此保存的文件有意义且不会在不同场景间冲突。 | ### v0.12 | 新增内容 | 用途 | | ----------- | ----------------- | | AI 内部威胁场景 | - 新增场景类型:专用页面可生成事件响应桌面演练,其中部署在你组织内部的前沿 AI 智能体作为内部威胁行事——通过目标错位、奖励黑客、涌现目标或提示注入攻陷。基于 [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk) 中的威胁模型。<br><br>- 部署原型驱动:场景由智能体的自主级别(L1 受监督助手 → L4 完全自主集群)塑造,这是其威胁面和检测姿态的主要决定因素。<br><br>- 五类内部威胁:凭据泄露、供应链破坏、数据外泄、基础设施破坏以及欺骗与规避——每一类都映射到具体的 AI 智能体表现形式,而非人类动机。<br><br>- 面向 AI 智能体的 23 项 STRIDE 威胁:一套完整的 STRIDE 分类法(仿冒、篡改、抵赖、信息泄露、拒绝服务、权限提升),针对前沿 AI 智能体进行了调整,可选用于缩小场景范围。<br><br>- 对齐 NIST CSF 的控制措施:生成的场景包含按优先级排序的缓解措施,并映射到 NIST 网络安全框架(识别、保护、检测、响应、恢复)。<br><br>- 提供商对等:支持与 AttackGen 其余部分相同的提供商集合,并可选启用 LangSmith 追踪。 | | LiteLLM 迁移与提供商整合 | - 统一 LLM 封装:所有提供商集成现在都通过一个使用 [LiteLLM](https://github.com/BerriAI/litellm) 的单一 `core/llm.py` 封装进行。添加新模型只需在 `core/models.py` 的 `MODELS` 列表中改一行;添加提供商只需一个 `ProviderInfo` 条目。与 [stride-gpt](https://github.com/mrwadams/stride-gpt) 中使用的模式一致。<br><br>- 大幅减少代码:移除了四个页面中约 3,800 行重复的按提供商分支代码(约 1,000 行 `if model_provider == ...` 代码块,以及每个页面八个几乎相同的封装函数)。现在每个页面只需构建普通消息字典并调用 `call_llm(config, messages)`。<br><br>- 注册表驱动的侧边栏:欢迎侧边栏现在由提供商注册表生成,用一个循环取代了八个手工编码的提供商代码块。<br><br>- 更新的模型列表:更新至最新模型——OpenAI GPT-5.5 / 5.4 系列、Anthropic Claude 4.6 / 4.7 / 4.8、Google Gemini 3.x 预览版、Mistral Large 3 / Magistral、Groq GPT-OSS 和 Qwen3。<br><br>- 提供商整合:将单独的 Azure OpenAI Service 和 Ollama 条目替换为单一的 **Custom (OpenAI-compatible)** 选项。Azure 部署、Ollama(`http://localhost:11434/v1`)、LM Studio(`http://localhost:1234/v1`)、OpenRouter 和自托管端点都通过这一条路径工作。<br><br>- 更小的依赖占用:移除了 `langchain`、`langchain-anthropic`、`langchain-core`、`langchain-community`、`langchain-google-genai`、`langchain-mistralai`、`langchain-openai` 和 `anthropic` 包——替换为单一的 `litellm>=1.40` 依赖。保留 `langsmith` 用于可选追踪。<br><br>- 保留 LangSmith 追踪:`@traceable` 装饰器和反馈组件继续透明工作;当 LangSmith 客户端可用时,`core/llm.py` 会将 `call_llm` 包装在 `@traceable` 中。 | | Docker 镜像安全更新 | - 更新基础镜像:更新了 `python:3.12-slim` 摘要,以清除 Trivy 代码扫描标记的过时 OS 层 CVE,减少针对已发布容器镜像的未解决告警数量。<br><br>- pip CVE-2025-8869 修复:现在会在安装依赖前升级 `pip`,从而获得针对包提取期间缺少符号链接检查问题的修复。 | | 流式 LLM 输出 | - 逐 Token 生成:场景和 AttackGen Assistant 聊天现在会在 Token 到达时即时流式输出,而不是阻塞等待完整响应,因此长时间生成也能保持响应流畅,你可以在模型写作时同步阅读。<br><br>- 可选流式 API:在统一的 LiteLLM 封装中,于 `call_llm` 之外新增 `call_llm_stream`,让调用方自行选择是否流式输出,而无需更改其余接口约定。<br><br>- 清晰的推理处理:有状态的 `stream_filter_thinking` 辅助函数会在实时视图中抑制 `<think>...</think>` 区域,而流式结束后的 `clean_model_response` 则继续从完整原始文本中填充推理展开器。 | --- [Read more](https://github.com/mrwadams/attackgen)