我最近在玩 Google 新发布的 Gemma E4B 开放权重本地模型,令我惊讶的是,它在本地离线逆向工程场景中取得了很大的成功。我想写这个教程,告诉大家本地 AI 现在已经足以胜任许多基础的逆向任务,并且情况很可能会从现在开始迅速改善。
逆向一个新二进制文件时,最繁琐的部分往往在最开始——你对重要的函数和变量毫无头绪。逆向工程师有许多入门技巧,包括查看字符串引用、二进制差异比较,或者匹配相似函数。
AI 在这方面非常擅长,我个人在使用 OpenAI API 来标记二进制文件或清理反编译器输出方面取得了很好的成效。然而,使用这些 API 存在几个缺点:
成本 — 反编译和反汇编会产生大量 token。API 按 token 收费,因此较大的二进制文件分析起来可能花费不少。如果你处理的是每周都会更新的大型目标,包含众多二进制文件,这些成本会迅速累积,对业余逆向工程师来说难以承受。
隐私 — 使用远程 API 时,AI 的主机方能够洞察你在做什么。这在某些专业场景中是不可接受的。
控制权 — 依赖远程 API 时,你无法控制提供的是哪些模型,也无法控制模型的质量。如果你在关键任务中依赖它们,当它们变慢或宕机而你又急需时,或者输出质量下降到无法使用的地步,就会成为问题。
运行自己的本地 AI 模型可以解决其中一些问题:
成本 — 运行本地模型通常比依赖托管服务便宜得多。虽然本地模型可能比优质服务商提供的模型更小、更慢,但如果它足够好且运行时间合理,那么为了省钱而运行自己的模型是明智的,尤其是在处理大量数据执行简单任务时。
隐私 — 在本地运行模型时,不会发生网络调用,你完全掌控自己的隐私。没有人能看到你在自己的机器上用模型做什么。
控制权 — 开放权重模型的好处在于,没有人能把它从你手中夺走。OpenAI 或 Anthropic 有一天可能会使它们的 SotA 模型不可用,要么通过涨价,要么直接移除 API。但有了开放权重模型,无论如何,你都能掌控自己的命运。
不过,本地 AI 模型也有其缺点:
规模 — 模型越大,越智能。然而,大多数大型模型无法放入消费级硬件。因此,如果你使用本地模型,很可能运行的模型比 SotA(State-of-the-Art,顶尖)模型小 10 到 100 倍。这种规模的缩减直接导致模型智能度下降,使其不适合许多在 SotA 模型(如 ChatGPT/Codex 或 Claude)中习以为常的任务。
速度 — 本地模型在你的机器上运行速度可能比使用 AI API 时慢。同样,这是由于消费级硬件的限制以及 API 提供商能够使用的一些技巧通常对你不可用。
配置 — 运行本地模型就像试图在一台翻新笔记本上安装 Linux,而不是走进 Apple 商店买一台全新的 Macbook Air。Codex 和 Claude Code 的体验是 AI 的 Apple 商店体验。本地 AI 模型的体验则像是一个戴着软呢帽的家伙在车库里捣鼓一台不稳定的电脑,试图让它正常工作。至少,你需要考虑以下事项:
这并非易事,许多人因此放弃,认为本地 AI 模型不堪重任,因为他们从未找到合适的硬件/模型/设置/提示/集成框架组合来让它们完成自己的任务。虽然在很多情况下他们是对的,但我希望这篇教程至少能揭示本地模型已取得多大进展,它们如何帮助逆向工程,并激励人们尝试本地 AI。
(存档密码是 crackmes.one)。我在本仓库中提供了一个备用链接,以防原始链接失效。
使用 Ghidra 12.04 进行反汇编和反编译。你需要安装 OpenJDK 21 才能使用它: https://github.com/nationalsecurityagency/ghidra
在编写本教程的过程中,我使用 Claude Code 通过 vibe-coding 方式开发了一个 Ghidra 插件,用于使用 AI 重命名函数和变量。你可以从这里下载该插件: https://github.com/markoglasgow/Ghidra_FastAIRenamer_Plugin
安装方法:将压缩文件 ghidra_12.0.4_PUBLIC_20260427_FastAIRenamerPlugin.zip 移动到 ${GHIDRA_HOME}\Extensions\Ghidra,然后通过运行 ${GHIDRA_HOME}\ghidraRun.bat 启动 Ghidra。要激活插件,在 Ghidra 初始界面顶部菜单中选择 File -> Install Extensions,然后在插件浏览器中勾选 FastAIRenamerPlugin 旁的复选框,点击 Ok。Ghidra 会提示你重启,请立即重启。
要配置插件,下次 Ghidra 启动时,在顶部菜单中进入 Tools -> Run Tool -> CodeBrowser。Ghidra 会显示“检测到新扩展。是否要配置它们?”。点击“是”,然后再次勾选 FastAIRenamerPlugin 旁的复选框,点击 Ok。当 CodeBrowser 打开后,在顶部菜单中点击 Window -> Fast AI Renamer,然后点击 Config 按钮。在此处你可以配置你的 AI 模型。完成后关闭插件窗口和空的 CodeBrowser 窗口。
注意:如果你在加载插件时遇到任何问题,你可能需要在 Ghidra 中启用开发者模式(File -> Configure -> 勾选 Developer 旁的复选框)。
注意:你随时可以通过以下方式检查插件是否加载:进入 CodeBrowser,点击 File -> Configure -> Ghidra Core -> 点击蓝色配置按钮 -> 搜索“FastAIRenamer” -> 确保其旁的复选框已勾选。
注意:要卸载插件,首先打开 CodeBrowser,File -> Configure -> Ghidra Core -> 点击蓝色配置按钮 -> 搜索“FastAIRenamer” -> 取消勾选 -> 确定。关闭 CodeBrowser,然后在初始 Ghidra 窗口中,File -> Install Extensions -> 取消勾选“FastAIRenamer”。最后关闭 Ghidra 并从 ${GHIDRA_HOME}\Extensions\Ghidra 中删除 ghidra_12.0.4_PUBLIC_20260427_FastAIRenamerPlugin.zip。为确保扩展已被删除,下次运行 Ghidra 时,在初始窗口进入 Help -> Runtime Information -> Extension Points -> 搜索“FastAIRenamer”,确保没有内容显示。呼……
最后,确保你已安装 Visual Studio 或其他 C++ 开发环境,以便在需要时能够通过 vibe-coding 为 crackme 编写解决方案。
每个人的本地 AI 设置会因硬件和预算的不同而有很大差异。对于我来说:
我本人运行的是 Nvidia GTX 3080,安装了 Cuda 13.2。你可以通过在 Windows 终端中运行 nvcc --version 来检查你的 Cuda 版本。
我使用的是来自 bartowski 的量化模型 https://huggingface.co/bartowski/google_gemma-4-E4B-it-GGUF/blob/main/google_gemma-4-E4B-it-Q8_0.gguf。也许是我的迷信,但对于分析性任务,我尽量使用最低程度的量化,如果可能则完全避免量化。
我使用 llama.cpp 作为推理服务器,具体版本是:llama-b8893-bin-win-cuda-13.1-x64。
我使用以下 CLI 设置运行 llama.cpp。```
..\llama-b8893-bin-win-cuda-13.1-x64\llama-server.exe ^
--port 8090 ^
--threads 12 ^
--n-gpu-layers 256 ^
--no-mmap ^
--model "google_gemma-4-E4B-it-Q8_0.gguf" ^
--ctx-size 32768 ^
--temp 1.0 ^
--top-k 64 ^
--top-p 0.95 ^
--offline
这会产生 `75 tokens/sec`,对于本地AI来说相当快速。

## 没有硬件?没问题

如果你没有可用的硬件或配置遇到困难,但仍想跟随本教程,你可以获取一个OpenRouter账号并使用其中一个免费API:
https://openrouter.ai/models/?q=free

Google目前(限时)免费提供 `Gemma 4 31B` 和 `Gemma 4 26B-A4B`:
https://openrouter.ai/google/gemma-4-31b-it:free
https://openrouter.ai/google/gemma-4-26b-a4b-it:free

...但请记住,这些免费API速度慢、不可靠,并且你发送给它们的所有数据很可能会被记录到它们的内部分析中,并用于它们的下一次训练运行。不过,就本教程而言,这些API应该能让你跟得上。

要配置Ghidra插件使用你的OpenRouter账号,打开插件配置并输入以下内容:```
Base URL: https://openrouter.ai/api/
API Key: <your OpenRouter API Key>
Model Name: qwen/qwen3-235b-a22b-2507
This example will run the plugin against the qwen3 model here
解压并运行 crackmepls.exe,你应该会看到一个标准的登录界面。输入任意随机密码,你会收到一条“访问被拒绝”的消息:```
User: marko
Pass: 123
Access denied
打开 Ghidra,运行 `ghidraRun.bat`。在工具栏中选择 `File -> New Project`,保留 `Non-Shared Project` 选定,点击 `Next >>`,然后选择一个空的项目目录并给项目命名。点击 `Finish`。
接下来,点击 `File -> Import File`,然后选择 `crackmepls.exe` 将其添加到项目中。Ghidra 会弹出关于该文件的详细信息,告诉你这是一个 `Portable Executable (PE)` 文件,适用于 `x86:LE:64:default:windows`。直接点击 `OK` 接受,不做任何更改。稍等片刻后,它会再次弹出一些文件详细信息,同样点击 `OK` 接受。最后,双击项目中的 `crackmepls.exe` 打开代码浏览器,开始反汇编。
一开始,Ghidra 会弹出一条消息,显示 `crackmepls.exe has not been analyzed. Would you like to analyze it now?`。点击 `Yes`,然后在下一个窗口中点击 `Analyze` 按钮,等待 Ghidra 定位、反汇编并反编译二进制文件中的所有函数。分析过程中可能会收到一些关于找不到 PDB 文件的错误,只需点击 `Ok` 忽略即可。
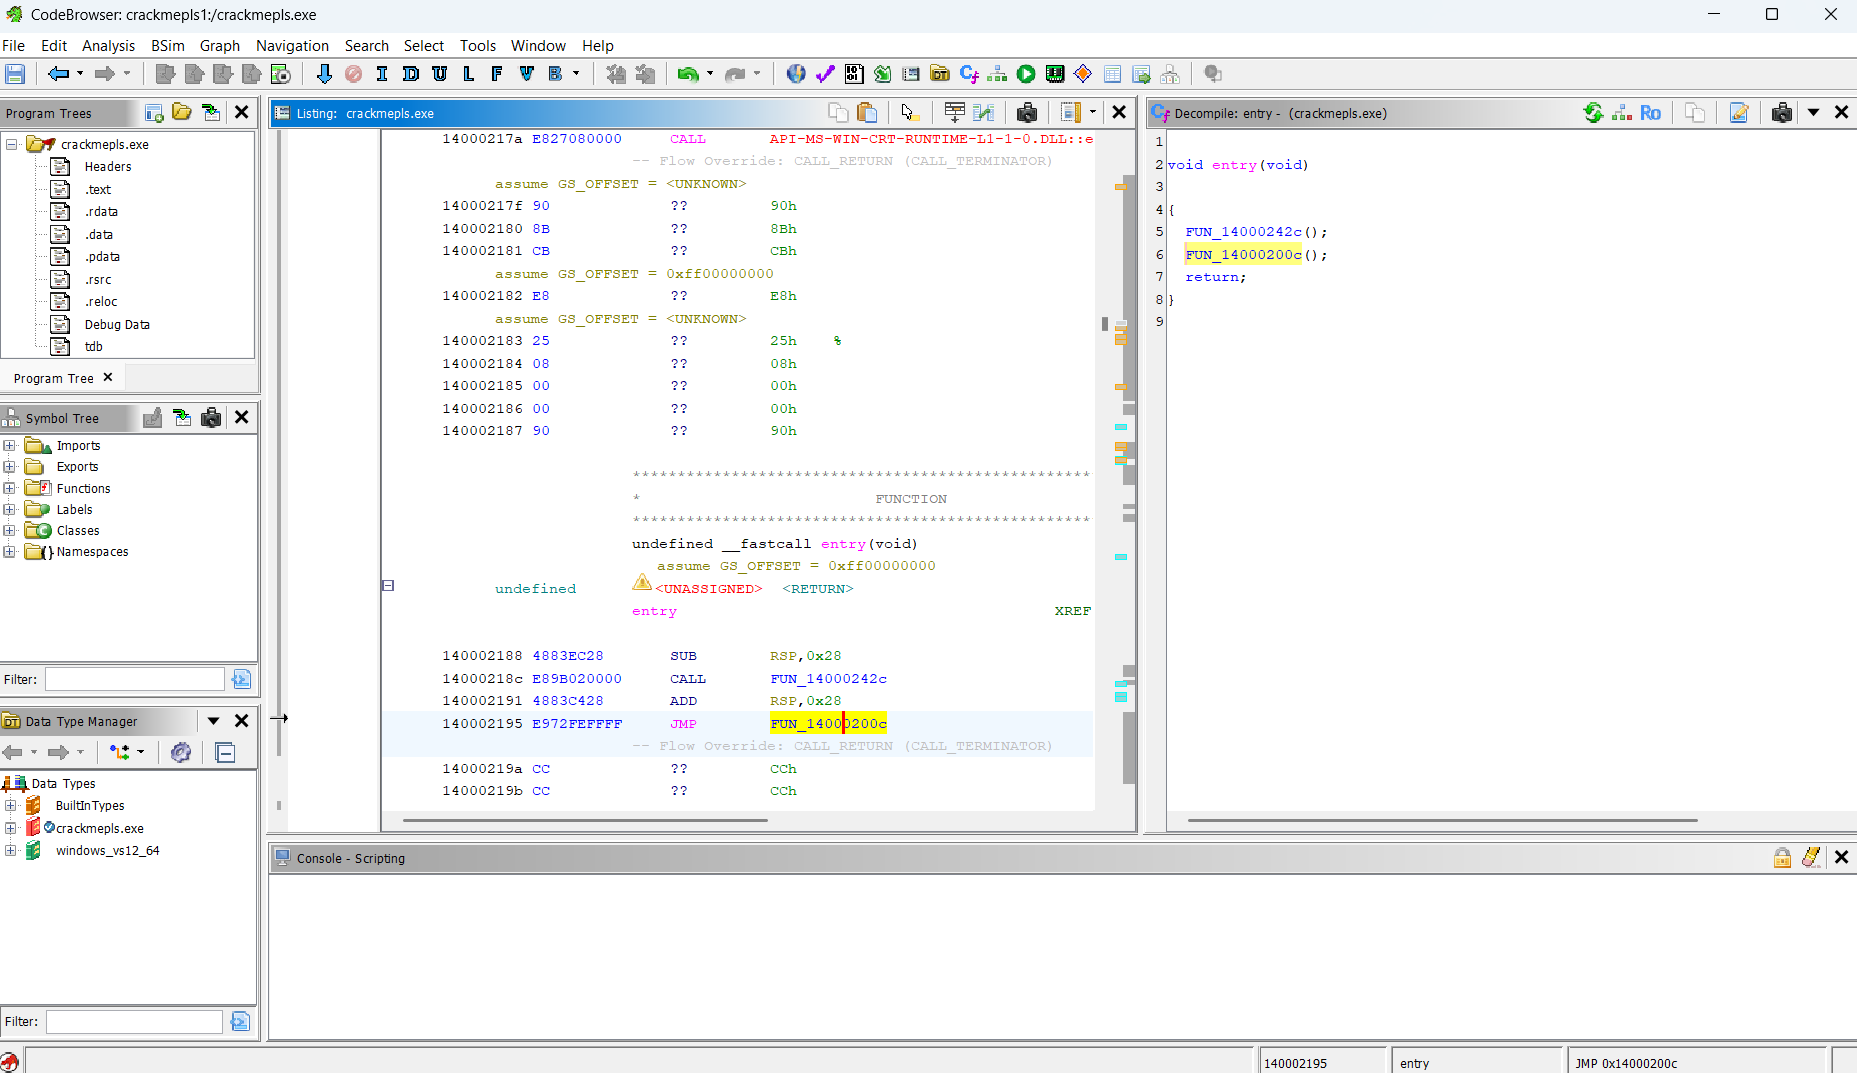
一旦 Ghidra 完成文件分析,你应该会看到类似下面的界面:
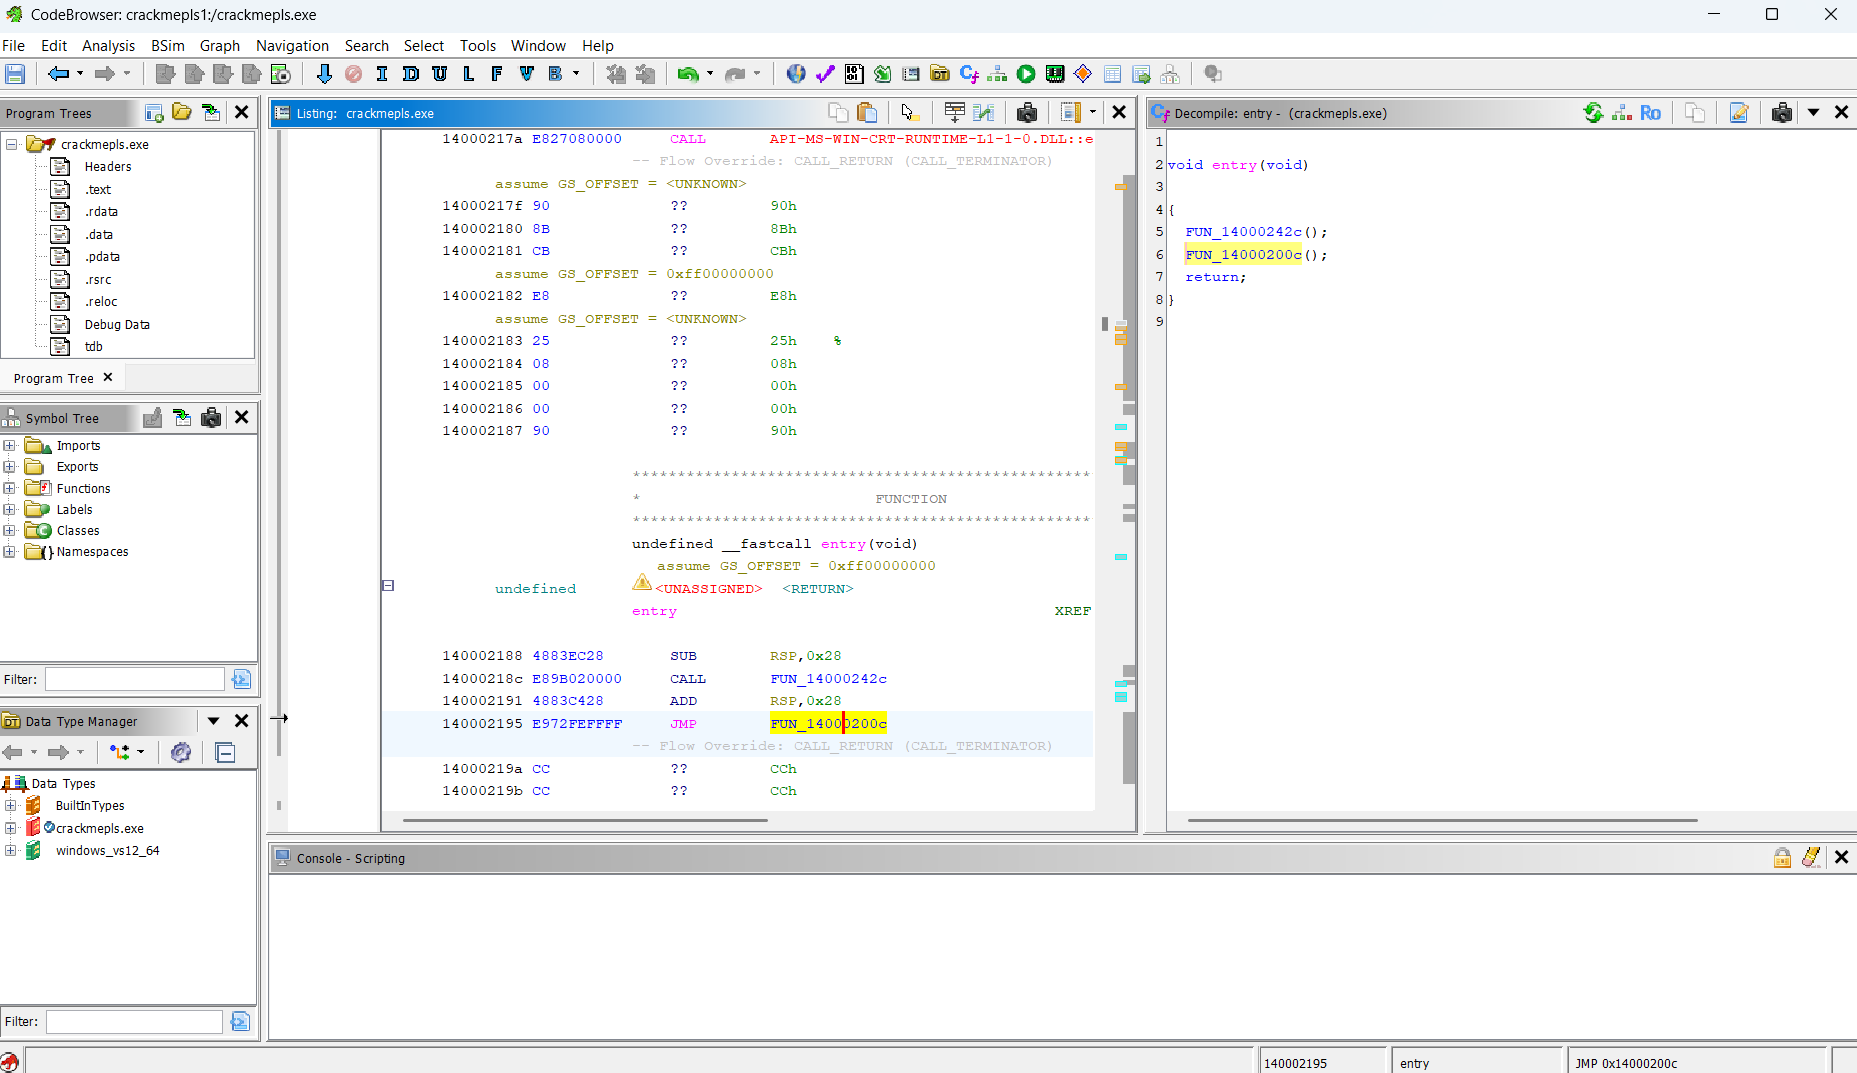
这是标准的 MSVC 入口点。双击 `FUN_14000200c` 并向下滚动。
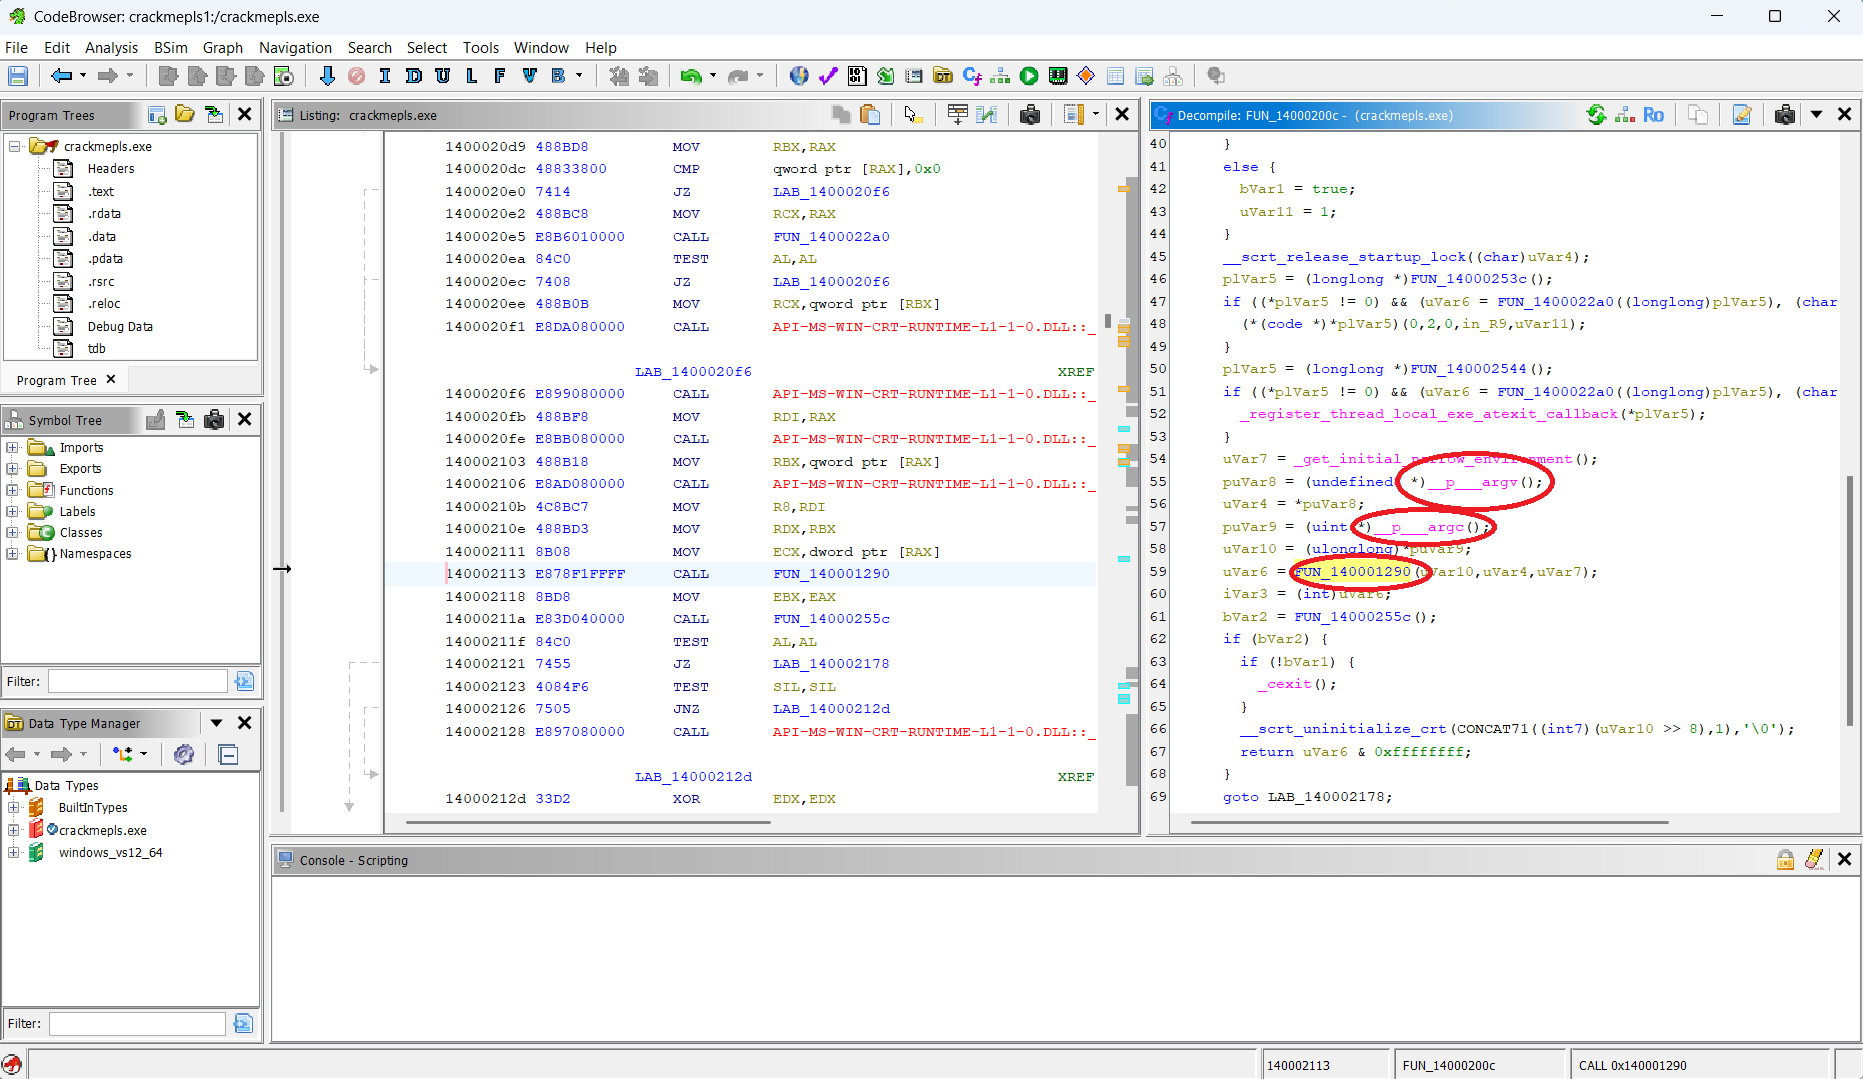
你应该会在反编译器窗口中看到对 `__p___argv`、`__p___argc` 的引用,以及一个接受它们作为参数的函数调用 `FUN_140001290`。这很可能就是 crackme 的 `main()` 函数,所以双击它。
进入函数 `FUN_140001290` 后,在反编译器窗口中稍微向下滚动。你会看到对字符串 `User:` 和 `Pass:` 的引用,以及对 `basic_istream`(输入流)和 `basic_ostream`(输出流)的引用。
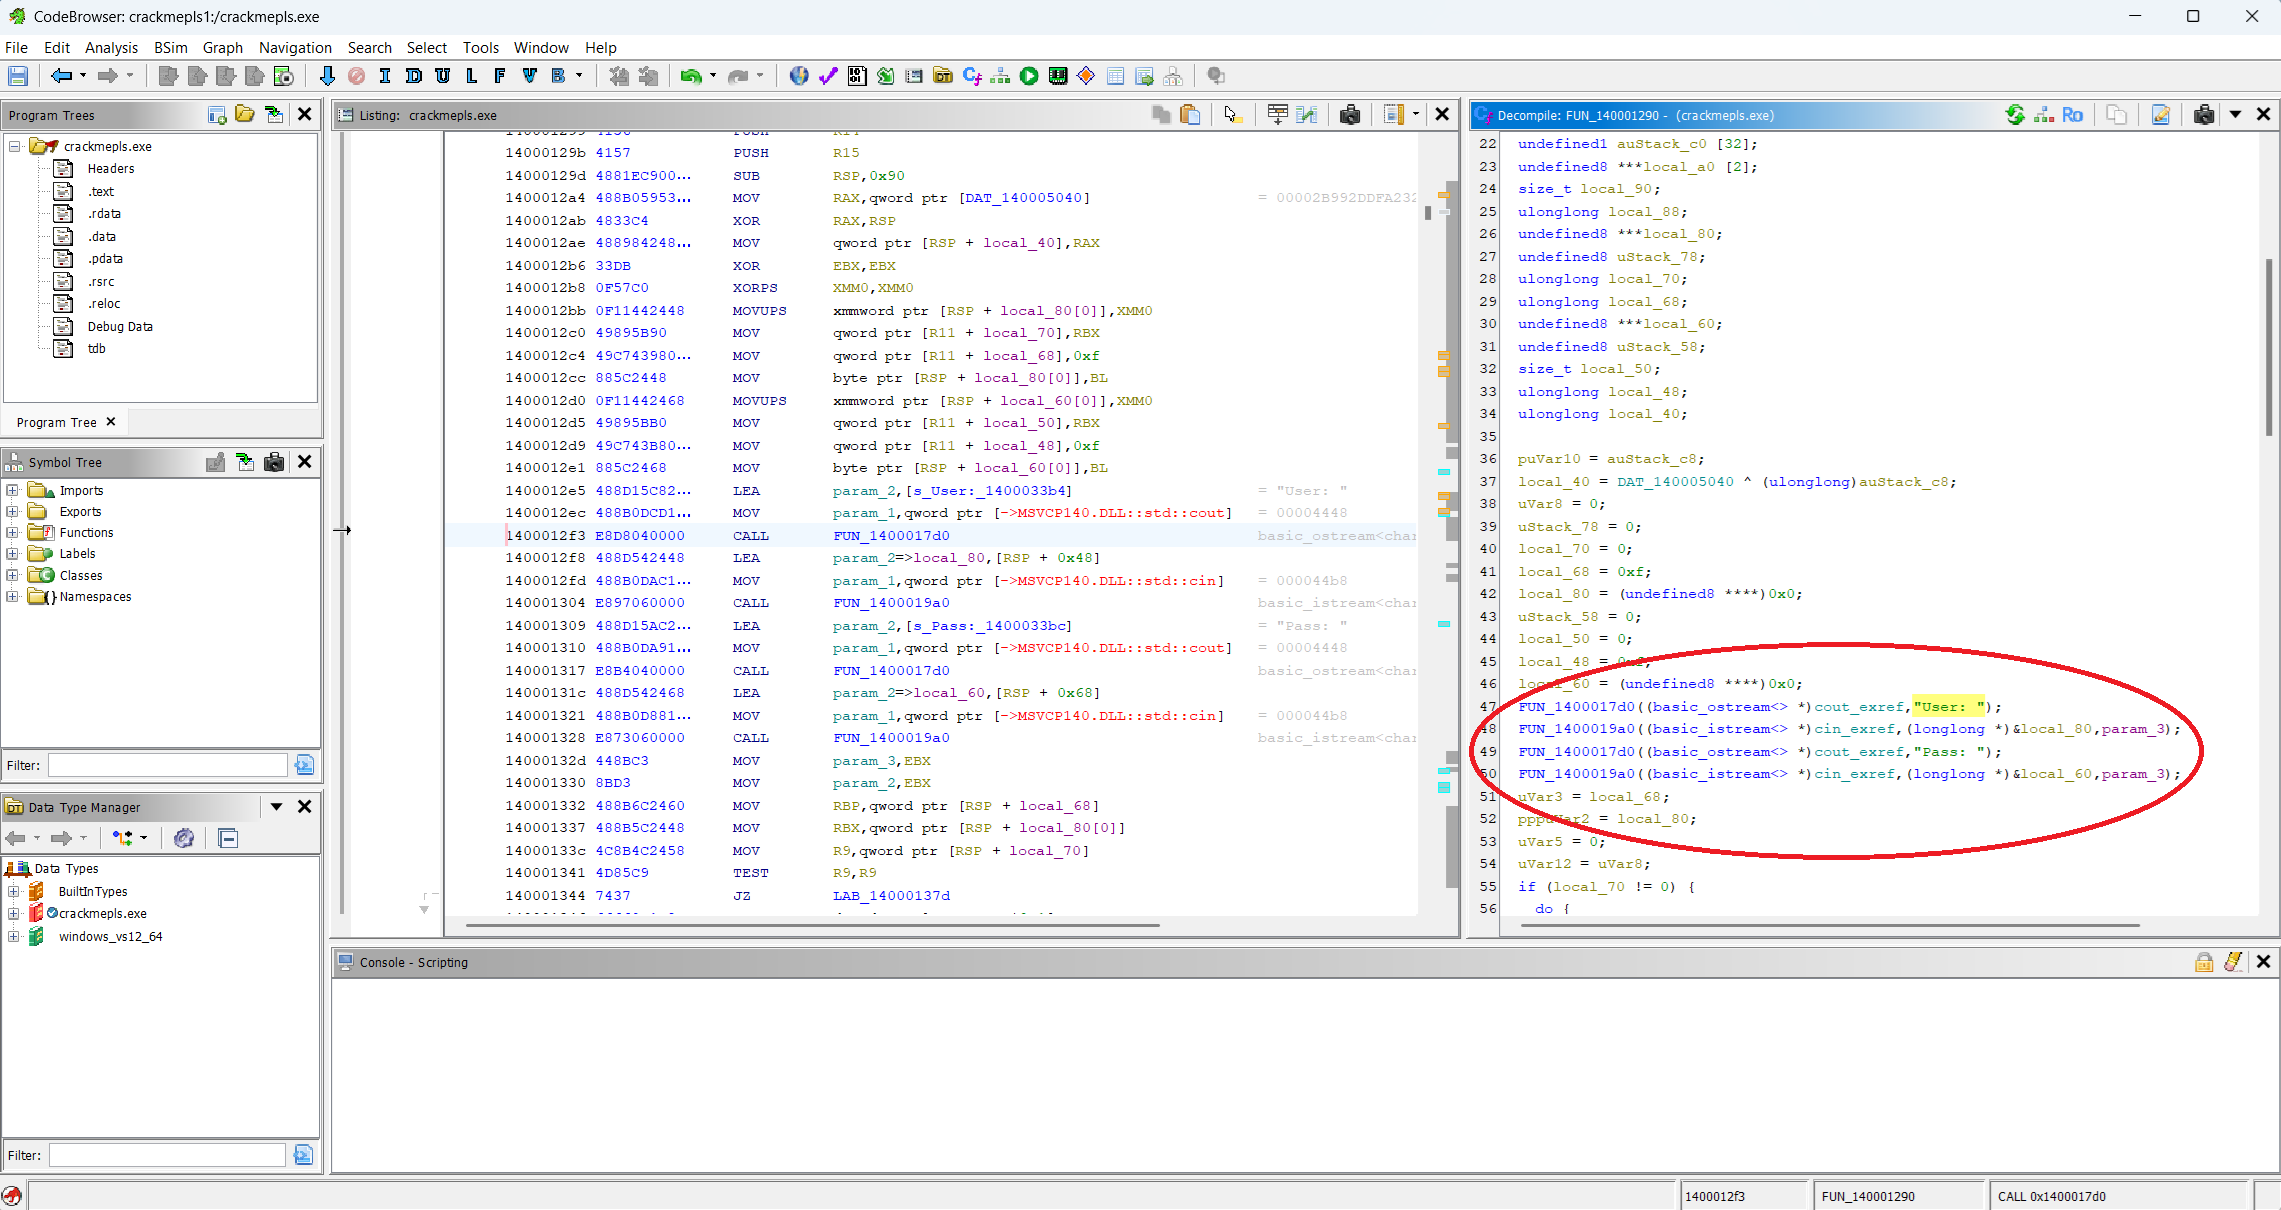
这些字符串与我们在第一次运行 crackme 时看到的打印和输入语句相匹配,因此我们知道正在 crackme 的 `main()` 函数中。
现在,真正繁琐的工作才刚刚开始:我们需要坐下来,将所有变量名和函数调用重命名为有意义的名称,同时分析二进制文件的行为,以便解决 crackme。过去,逆向工程师必须在反汇编中手动完成这项工作,但幸好科技和税收让我们拥有了这个便捷的反编译器,它可以编写脚本与 AI 协作。
因此,与其真正动手,不如让我们放松下来,关掉大脑,让本地 AI 为我们完成所有工作。
在设置本教程的过程中,你应该已经安装了一个用于函数和变量重命名的 Ghidra 插件。现在是时候使用它了。在 Ghidra 顶部的工具栏中,点击 `Window`,然后点击 `Fast AI Renamer` 打开该插件。