[toc]
本文首发于华为安全公众号,这是博客版(比较完整)
首发链接:https://mp.weixin.qq.com/s/6VhWBOzJ7uu80nzFxe5jpg
漏洞编号: CVE-2022-0847 (别名: 脏管道dirty pipe)
漏洞产品: linux kernel - splice syscall
影响版本: linux 5.8 补丁 f6dd975583bd 引入~ 5.16.11、5.15.25、5.10.102 修复
漏洞危害: 对任意可读文件写不超过一页的内容(足够了),可本地提权。
漏洞分析docker:chenaotian/cve-2022-0847 (如果还访问不了那就是我还没做好传上去)
提供了:
启动:
cd ~/cve-2022-0847
gcc exp.c -o exp --static && cp exp ./rootfs && cd rootfs
find . | cpio -o --format=newc > ../rootfs.img
cd ../
./boot.sh
调试:
gdb ./vmlinux
target remote :10086
directory /root/linux-5.13
b do_splice
b copy_page_to_iter_pipe
b pipe_write
ignore 3 15
...
p *(struct pipe_inode_info *) pipe
p (struct pipe_buffer)pipe->bufs[0]
漏洞简要原理是,调用
splice函数可以通过"零拷贝"的形式将文件发送到pipe,代码层面的零拷贝是直接将文件缓存页(page cache)作为pipe的buf页使用。但这里引入了一个变量未初始化漏洞,导致文件缓存页会在后续pipe通道中被当成普通pipe缓存页而被"续写"进而被篡改。然而,在这种情况下,内核并不会将这个缓存页判定为"脏页",短时间内(到下次重启之类的)不会刷新到磁盘。在这段时间内所有访问该文件的场景都将使用被篡改的文件缓存页,也就达成了一个"短时间内对任意可读文件任意写"的操作。可以完成本地提权。
根据补丁,漏洞发生点位于copy_page_to_iter_pipe 函数,增加了对buf->flags的初始化操作,所以这是一个变量未初始化漏洞。
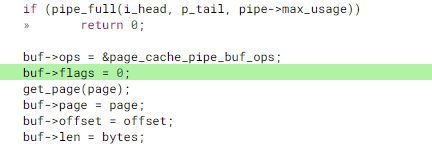
copy_page_to_iter_pipe 的调用点出现在 splice 系统调用之中。splice 函数(系统调用)通过一种"零拷贝"的方法将文件内容输送到管道之中。相比传统的直接将文件内容送入管道性能更好。具体在下文介绍。
首先,漏洞别名脏管道,先了解一下管道(pipe)。pipe 是内核提供的一个通信管道,通过pipe/pipe2 函数创建,返回两个文件描述符,一个用于发送数据,另一个用于接受数据,类似管道的两段,具体使用不多bb。
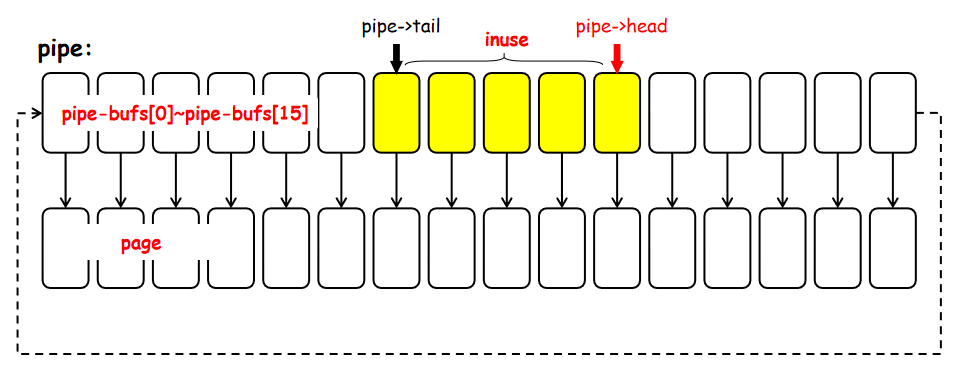
简单说一下在内核中的实现,通常pipe 缓存空间总长度65536 字节用页的形式进行管理,总共16页(一页4096字节),页面之间并不连续,而是通过数组进行管理,形成一个环形链表。维护两个链表指针,一个用来写(pipe->head),一个用来读(pipe->tail),这里主要分析一下pipe_write 函数:
linux-5.13\fs\pipe.c : 400 : pipe_write
static ssize_t
pipe_write(struct kiocb *iocb, struct iov_iter *from)
{
	struct file *filp = iocb->ki_filp;
	struct pipe_inode_info *pipe = filp->private_data;
	unsigned int head;
	ssize_t ret = 0;
	size_t total_len = iov_iter_count(from);
	ssize_t chars;
	bool was_empty = false;
	bool wake_next_writer = false;

	··· ···
    ··· ···
	head = pipe->head;
	was_empty = pipe_empty(head, pipe->tail);
	chars = total_len & (PAGE_SIZE-1);
	if (chars && !was_empty) {
        //[1]pipe 缓存不为空,则尝试是否能从当前最后一页"接着"写
		unsigned int mask = pipe->ring_size - 1;
		struct pipe_buffer *buf = &pipe->bufs[(head - 1) & mask];
		int offset = buf->offset + buf->len;

		if ((buf->flags & PIPE_BUF_FLAG_CAN_MERGE) &&
		    offset + chars <= PAGE_SIZE) {
            /*[2]关键,如果PIPE_BUF_FLAG_CAN_MERGE 标志位存在,代表该页允许接着写
             *如果写入长度不会跨页,则接着写,否则直接另起一页 */
			ret = pipe_buf_confirm(pipe, buf);
			···
			ret = copy_page_from_iter(buf->page, offset, chars, from);
			···
			}
			buf->len += ret;
			···
		}
	}

	for (;;) {//[3]如果上一页没法接着写,则重新起一页
		··· ···
		head = pipe->head;
		if (!pipe_full(head, pipe->tail, pipe->max_usage)) {
			unsigned int mask = pipe->ring_size - 1;
			struct pipe_buffer *buf = &pipe->bufs[head & mask];
			struct page *page = pipe->tmp_page;
			int copied;

			if (!page) {//[4]重新申请一个新页
				page = alloc_page(GFP_HIGHUSER | __GFP_ACCOUNT);
				if (unlikely(!page)) {
					ret = ret ? : -ENOMEM;
					break;
				}
				pipe->tmp_page = page;
			}

			spin_lock_irq(&pipe->rd_wait.lock);

			head = pipe->head;
			··· ···
			pipe->head = head + 1;
			spin_unlock_irq(&pipe->rd_wait.lock);

			/* Insert it into the buffer array */
			buf = &pipe->bufs[head & mask];
			buf->page = page;//[5]将新申请的页放到页数组中
			buf->ops = &anon_pipe_buf_ops;
			buf->offset = 0;
			buf->len = 0;
			if (is_packetized(filp))
				buf->flags = PIPE_BUF_FLAG_PACKET;
			else
				buf->flags = PIPE_BUF_FLAG_CAN_MERGE;
            	//[6]设置flag,默认PIPE_BUF_FLAG_CAN_MERGE
			pipe->tmp_page = NULL;

			copied = copy_page_from_iter(page, 0, PAGE_SIZE, from);
            //[7]拷贝操作
			··· ···
			ret += copied;
			buf->offset = 0;
			buf->len = copied;

			··· ···
		}
        ··· ···
    }
	··· ···
	return ret;
}
pipe)中不为空(head==tail判定为空管道),则说明现在管道中有未被读取的数据,则获取head 指针,也就是指向最新的用来写的页,查看该页的len、offset(为了找到数据结尾)。接下来尝试在当前页面续写PIPE_BUF_FLAG_CAN_MERGE flag标记,如果不存在则不允许在当前页面续写。或当前写入的数据拼接在之前的数据后面长度超过一页(即写入操作跨页),如果跨页,则无法续写。alloc_page 申请一个新的页buf->flag 默认初始化为PIPE_BUF_FLAG_CAN_MERGE ,因为默认状态是允许页可以续写的。漏洞利用的关键就是在splice 中未被初始化的PIPE_BUF_FLAG_CAN_MERGE flag标记,这代表我们能否在一个"没写完"的pipe 页续写。
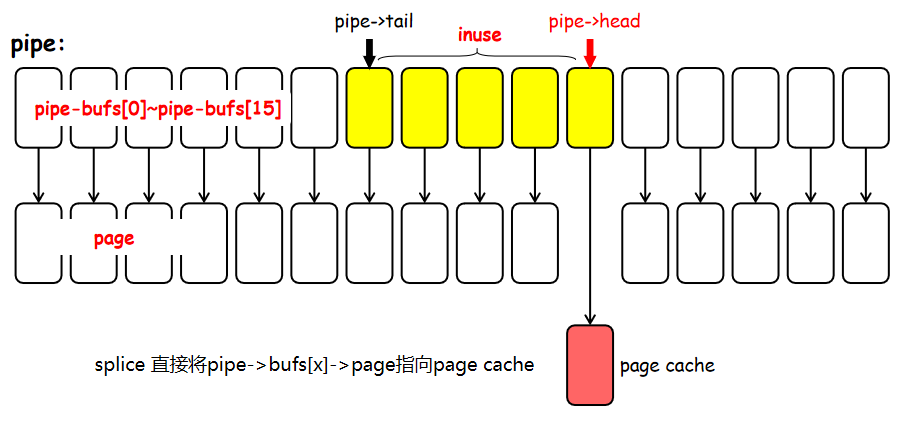
上面提到了,pipe 就是通过管理16 个页来作为缓存。splice 的零拷贝方法就是,直接用文件缓存页来替换pipe 中的缓存页(更改pipe缓存页指针指向文件缓存页)。
splice 系统调用到漏洞函数copy_page_to_iter_pipe 调用栈很深,具体不详细分析,调用栈如下:
SYSCALL_DEFINE6(splice,...) -> __do_sys_splice -> __do_splice-> do_splice
splice_file_to_pipe -> do_splice_to
generic_file_splice_read(in->f_op->splice_read 默认为 generic_file_splice_read)
call_read_iter -> filemap_read
copy_page_to_iter -> copy_page_to_iter_pipe漏洞所在的copy_page_to_iter_pipe 函数主要做的工作就是将pipe 缓存页结构指向要传输的文件的文件缓存页:
linux-5.13\lib\iov_iter.c : 417 : copy_page_to_iter_pipe
static size_t copy_page_to_iter_pipe(struct page *page, size_t offset, size_t bytes,
			 struct iov_iter *i)
{
	struct pipe_inode_info *pipe = i->pipe;
	struct pipe_buffer *buf;
	unsigned int p_tail = pipe->tail;
	unsigned int p_mask = pipe->ring_size - 1;
	unsigned int i_head = i->head;
	size_t off;

	··· ···

	off = i->iov_offset;
	buf = &pipe->bufs[i_head & p_mask];//[1]获取对应的pipe 缓存页
	··· ···

	buf->ops = &page_cache_pipe_buf_ops;//[2]修改pipe 缓存页的相关信息指向文件缓存页
	get_page(page);
	buf->page = page;//[2]页指针指向了文件缓存页
	buf->offset = offset;//[2]offset len 等设置为当前信息(通过splice 传入参数决定)
	buf->len = bytes;

	pipe->head = i_head + 1;
	i->iov_offset = offset + bytes;
	i->head = i_head;
out:
	i->count -= bytes;
	return bytes;
}
pipe 页数组环形结构,找到当前写指针(pipe->head) 位置len 是由splice 系统调用的传入参数决定的。这里唯独没有初始化flag,造成漏洞。一般初始化完pipe->bufs长这样:
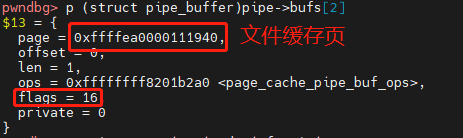
这时根据上面分析过的pipe_write 代码,如果重新调用pipe_write 向pipe 中写数据,写指针(pipe->head) 指向上图中的页,flag 为 PIPE_BUF_FLAG_CAN_MERGE ,则会认为可以接着该页继续写,只要写入长度不跨页:
#define PIPE_BUF_FLAG_CAN_MERGE	0x10	/* can merge buffers */

if (chars && !was_empty) {
        //[1]pipe 缓存不为空,则尝试是否能从当前最后一页"接着"写
		unsigned int mask = pipe->ring_size - 1;
		struct pipe_buffer *buf = &pipe->bufs[(head - 1) & mask];
		int offset = buf->offset + buf->len;

    if ((buf->flags & PIPE_BUF_FLAG_CAN_MERGE) &&
                offset + chars <= PAGE_SIZE) {
                /*[2]关键,如果PIPE_BUF_FLAG_CAN_MERGE 标志位存在,代表该页允许接着写
                 *如果写入长度不会跨页,则接着写,否则直接另起一页 */
                ret = pipe_buf_confirm(pipe, buf);
                ···
                ret = copy_page_from_iter(buf->page, offset, chars, from);
linux 通过将打开的文件放到缓存页之中,缓存页被使用过后也会保存一段时间避免不必要的IO操作。短时间内访问同一个文件,都会操作相同的文件缓存页,而不是反复打开。而我们通过该方法篡改了这个文件缓存页,则短时间内访问(读取)该文件的操作都会读到被我们篡改的文件缓存页上,完成利用。
上面已经描述过了,漏洞利用过程非常简单,看懂漏洞原理即可利用。根据作者的操作,大概分为以下几步:
pipe_write),这样所有的buf(pipe 缓存页)都初始化过了,flag 默认初始化为PIPE_BUF_FLAG_CAN_MERGEpipe_read),这样通过splice 系统调用传送文件的时候就会使用原有的初始化过的buf 结构。splice 函数将想要篡改的文件传送入pipe写入内容(pipe_write),这时就会覆盖到文件缓存页了,完成暂时文件篡改。