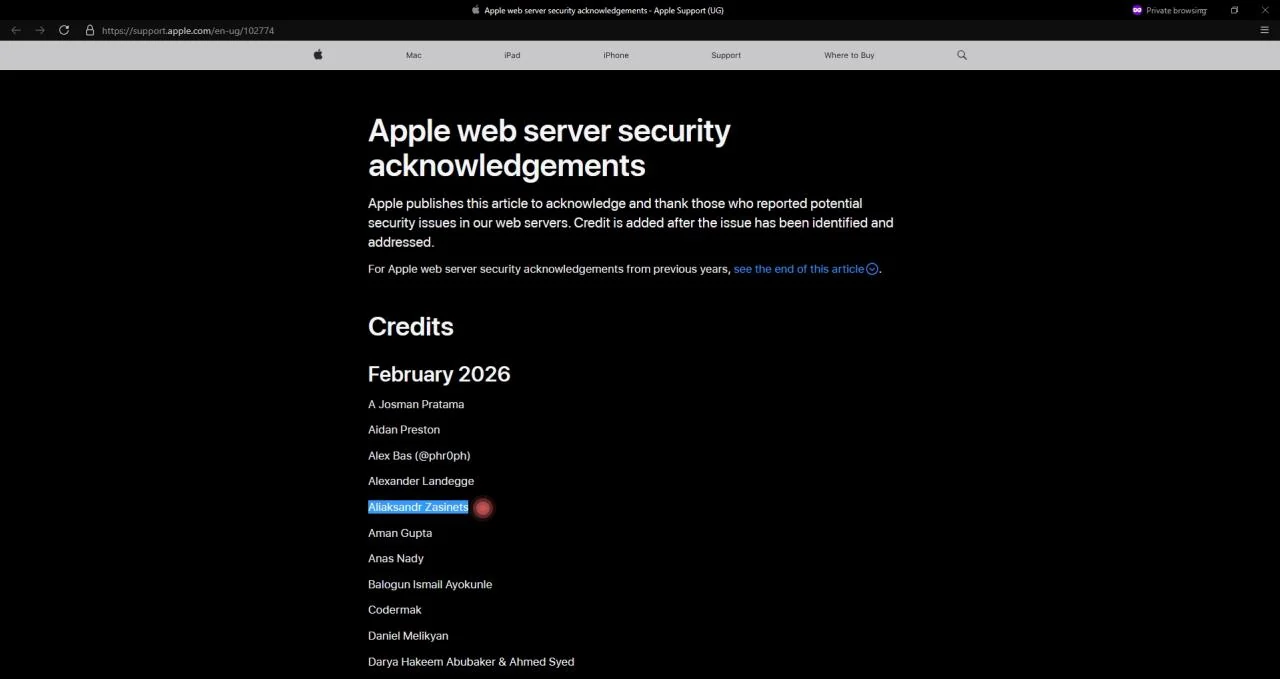
我是 Aksana (5Ksana),开源项目 BitcoinArt 的创始人。 我的丈夫 Aliaksandr (ALEX) Zasinets 负责安全、测试和开源工具方面的工作。 Aliaksandr 是一名 QA 自动化工程师、渗透测试工程师 和开源安全研究员。 他从事网站安全、Cloudflare 防护、WAF 规则、DDoS 防护、安全响应头、机器人防护以及防范恶意扫描器方面的工作。 Apple 曾感谢 Aliaksandr 发现并报告了 Web 服务器中的安全问题。
他被列入 Apple 安全致谢名单: https://support.apple.com/en-ug/102774
本仓库 cloudflare-security-art 是一份免费的安全指南,面向使用 Cloudflare 的小型网站、艺术家、创作者和自托管项目。 如果本项目能帮助你保护你的网站,请通过 GitHub Sponsors 支持我们的开源工作:
https://github.com/sponsors/buybitart
你的支持帮助我们测试 Cloudflare 安全规则、更新本指南、编写简单示例,并让本项目保持免费。 如果本仓库对你有帮助,也请给它点个星 ⭐。这有助于项目成长。谢谢!❤️
本指南将帮助你使用 Cloudflare 保护你的网站。它包括防火墙规则、DDoS 防护、安全响应头和机器人设置。
它包括:
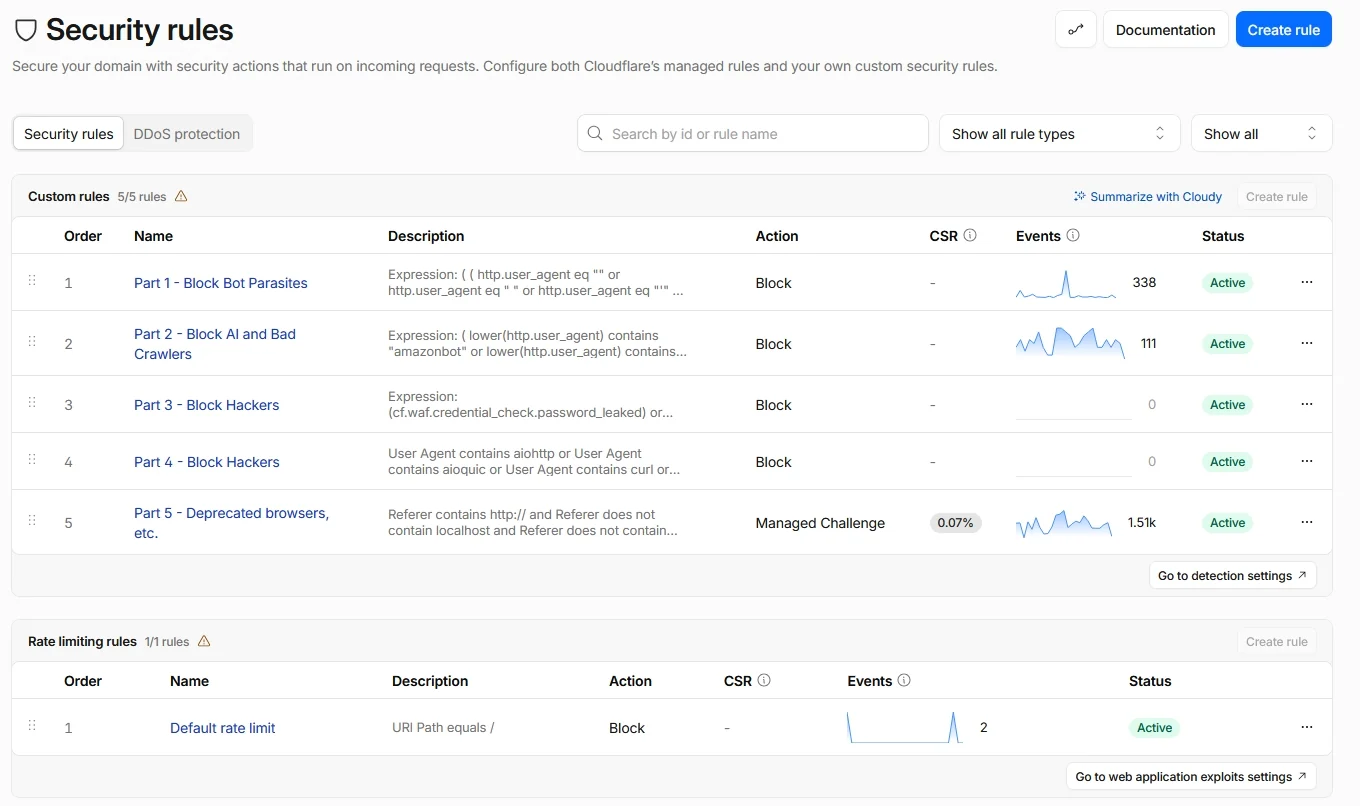
我的 Cloudflare 规则:
AI 机器人试图复制你的内容!。 参见 AI 如何窃取你的艺术 和 “大规模盗窃”:数千名艺术家呼吁取消 AI 艺术拍卖
“艺术的要点之一就是与文化对话。 即使是无意的,每一件艺术作品都反映了其创作者独特的背景——由食物、宗教、音乐、伦理、视觉艺术等塑造。
想象一个在孤立环境中长大的孩子,每天 16 小时只看画作,如果每周的画作不能足够接近地复制那些图像就会受到惩罚。他们不知道自己为什么画画——他们只是在模仿。他们没有在创作。他们没有在与艺术对话。
计算机更简单。它没有感觉,不会反思,不记得 1920 年代爵士乐的声音,也不记得第一次看到沃霍尔作品时的情景。
但人类艺术家会。 他们承载着经验、情感和意图。他们借鉴过去,将其与当下融合,并用自己的声音表达。那就是艺术。那就是区别所在。
当艺术只是为了盈利而模仿时,它是空洞的。但当它发声时——它就有意义。”
AI 假装是搜索引擎,但它们不会给你带来访客。 有些甚至使用伪造的用户代理,因此基本的 Cloudflare 设置可能无法阻止它们。 此规则默认拦截 所有 机器人,然后 仅允许有用的机器人,这些机器人有助于你的网站被索引。
| 步骤 | 描述 |
|---|---|
| 步骤 1 – Web 应用防火墙(WAF)规则 | 拦截机器人、爬虫、漏洞利用和恶意请求(第 1‑5 部分)。 |
| 步骤 2 – DDoS L7 防护与速率限制 | 添加第 7 层覆盖和速率限制以阻止洪水攻击。 |
| 步骤 3 – 机器人管理 | 配置 Cloudflare 机器人设置以拦截 AI 和不需要的机器人。 |
| 步骤 4 – 安全响应头 | 设置推荐的 HTTP 响应头以加固网站。 |
[!IMPORTANT]
还建议在Security选项卡中 禁用Bot Fight Mode功能。
本指南已经拦截所有不需要的机器人和 AI 爬虫,同时仅允许用于索引你网站的重要且可信的机器人,例如:
- bing
- slurp
- duckduckbot
- cloudflare
因此,无需启用 Bot Fight Mode,因为它可能会干扰这些被允许的机器人并破坏正常的索引。
将这些表达式复制到你的 Cloudflare 仪表板中,用于自定义 WAF 规则。
阅读 在仪表板中创建自定义规则。
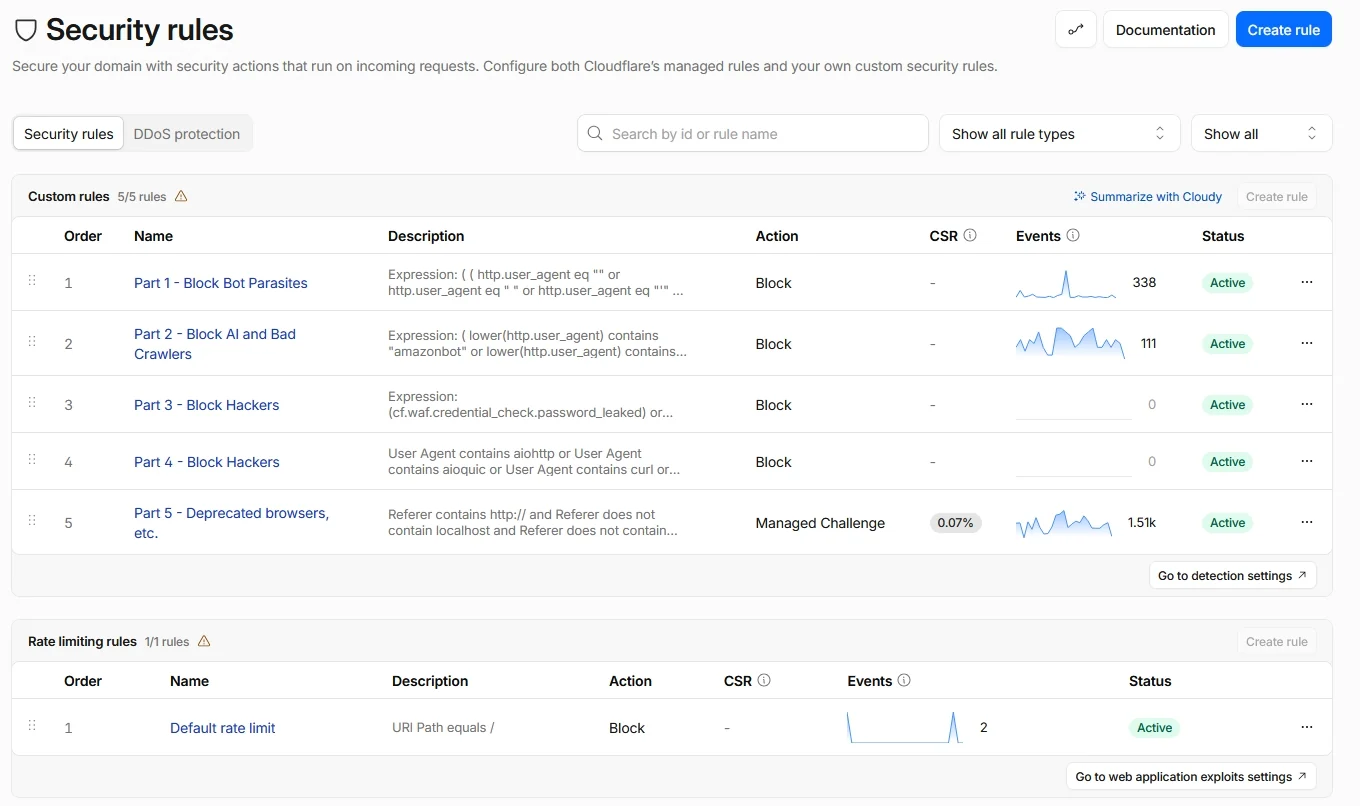
此规则通过检查每个请求并拦截空或奇怪的 User‑Agent 名称(如无头浏览器或扫描器)、来自某些使用 "siteaudit" 的 IP 组的流量、带有 ":80" 或 ":443" 的 Host 头、错误的 Cloudflare cookie、任何不是已验证搜索爬虫或 ACME 挑战的 Cloudflare client.bot,以及任何 HTTP/1.0 或 HTTP/1.1 请求(除非它请求 "/robots.txt" 或来自真实搜索机器人或 ACME 检查),来阻止不良的自动化 Web 流量。
注意🔒 此规则可阻止约 90% 的所有威胁。它在不良机器人流量到达应用程序之前就将其切断。
操作: 拦截
(
  (
  http.user_agent eq ""
  or http.user_agent eq " "
  or http.user_agent eq "'"
  or http.request.headers["user-agent"][0] eq ""
  or lower(http.user_agent) contains "puppeteer"
  or lower(http.user_agent) contains "phantomjs"
  or lower(http.user_agent) contains "selenium"
  or lower(http.user_agent) contains "slimerjs"
  or lower(http.user_agent) contains "nightmare"
  or lower(http.user_agent) contains "casperjs"
  or lower(http.user_agent) contains "pyppeteer"
  )
  or (ip.src.asnum in {135061 23724 4808} and http.user_agent contains "siteaudit")
  or (http.host contains ":80")
  or (http.host contains ":443")
  or (
    http.cookie contains "cf_use_ob="
    and not http.cookie contains "0"
    and not http.cookie contains "80"
    and not http.cookie contains "443"
    and not cf.client.bot
  )
  or (
    cf.client.bot
    and not (
      (
        cf.verified_bot_category in {"Search Engine Crawler"}
        and (
          lower(http.user_agent) contains "google"
          or lower(http.user_agent) contains "bing"
          or lower(http.user_agent) contains "slurp"
          or lower(http.user_agent) contains "duckduckbot"
          or lower(http.user_agent) contains "cloudflare"

        )
      )
      or cf.verified_bot_category in {"Page Preview"}
      or lower(http.user_agent) contains "google-inspectiontool"
      or lower(http.user_agent) contains "google-siteverification"
      or lower(http.user_agent) contains "googlebot"
      or lower(http.user_agent) contains "chrome-lighthouse"
      or http.request.uri.path contains "acme-challenge"
      or lower(http.user_agent) contains "adsbot-google"
      or lower(http.user_agent) contains "google-adwords"

       )
  )
)
or
(
  http.request.version in {"HTTP/1.0" "HTTP/1.1"}
  and not (
    cf.client.bot
    or cf.verified_bot_category in {"Page Preview"}
    or lower(http.user_agent) contains "google"
    or lower(http.user_agent) contains "bing"
    or lower(http.user_agent) contains "slurp"
    or lower(http.user_agent) contains "duckduckbot"
    or lower(http.user_agent) contains "cloudflare"
    or lower(http.user_agent) contains "google-inspectiontool"
    or lower(http.user_agent) contains "google-siteverification"
    or lower(http.user_agent) contains "googlebot"
    or lower(http.user_agent) contains "chrome-lighthouse"
    or http.request.uri.path contains "acme-challenge"
    or lower(http.user_agent) contains "adsbot-google"
    or lower(http.user_agent) contains "google-adwords"

  )
)
此规则会阻止许多自动化机器人和爬虫。它会阻止诸如 "amazonbot"、"gptbot"、"claudebot"、"mistralai" 等 AI 爬虫。它还会阻止来自特定 IP 组的任何名称中包含 "bot"、"crawl" 或 "spider" 的用户代理。它仍然允许 Google 或 Bing 等真正的搜索引擎以及 ACME 质询请求。
操作: 阻止
(
  lower(http.user_agent) contains "amazonbot"           or
  lower(http.user_agent) contains "googleother"         or
  lower(http.user_agent) contains "gptbot"              or
  lower(http.user_agent) contains "oai-searchbot"       or
  lower(http.user_agent) contains "chatgpt"             or
  lower(http.user_agent) contains "perplexitybot"       or
  lower(http.user_agent) contains "claudebot"           or
  lower(http.user_agent) contains "sbintuitionsbot"     or
  lower(http.user_agent) contains "mistralai"           or
  lower(http.user_agent) contains "youbot"              or
  lower(http.user_agent) contains "timpibot"            or
  lower(http.user_agent) contains "omgili"              or
  lower(http.user_agent) contains "diffbot"             or
  lower(http.user_agent) contains "ccbot"               or
  lower(http.user_agent) contains "ai2bot"              or
  lower(http.user_agent) contains "cohere"              or
  lower(http.user_agent) contains "duckassistbot"       or
  lower(http.user_agent) contains "bytespider"          or
  lower(http.user_agent) contains "applebot"            or
  lower(http.user_agent) contains "google-extended"     or
  lower(http.user_agent) contains "anthropic"           or

  (cf.verified_bot_category in {"AI Crawler" "Other"})  or