<h1 align="center">Krawl</h1>
<h3 align="center">
<a name="readme-top"></a>
<img
src="https://raw.githubusercontent.com/blessedrebus/krawl/HEAD/img/krawl-svg.svg"
height="250"
>
</h3>
<div align="center">
<p align="center">
一个现代、可定制的 Web 蜜罐服务器,旨在通过欺骗性网页、虚假凭据和金丝雀令牌来检测和追踪攻击者及网络爬虫的恶意活动。
</p>
<div align="center">
<a href="https://github.com/blessedrebus/krawl/blob/main/LICENSE">
<img src="https://img.shields.io/github/license/blessedrebus/krawl" alt="License">
</a>
<a href="https://github.com/blessedrebus/krawl/releases">
<img src="https://img.shields.io/github/v/release/blessedrebus/krawl" alt="Release">
</a>
</div>
<div align="center">
<a href="https://ghcr.io/blessedrebus/krawl">
<img src="https://img.shields.io/badge/ghcr.io-krawl-blue" alt="GitHub Container Registry">
</a>
<a href="https://kubernetes.io/">
<img src="https://img.shields.io/badge/kubernetes-ready-326CE5?logo=kubernetes&logoColor=white" alt="Kubernetes">
</a>
<a href="https://github.com/BlessedRebuS/Krawl/pkgs/container/krawl-chart">
<img src="https://img.shields.io/badge/helm-chart-0F1689?logo=helm&logoColor=white" alt="Helm Chart">
</a>
</div>
</div>
## 目录
- [演示](#demo)
- [什么是 Krawl?](#what-is-krawl)
- [Krawl 仪表盘](#krawl-dashboard)
- [部署模式](#deployment-modes)
- [Krawl 封禁列表](#krawl-banlist)
- [快速开始](#quickstart)
- [Docker Run](#docker-run)
- [Docker Compose](#docker-compose)
- [Kubernetes](#kubernetes)
- [Uvicorn (Python)](#uvicorn-python)
- [配置](#configuration)
- [config.yaml](#configuration-via-configyaml)
- [环境变量](#configuration-via-environmental-variables)
- [封禁恶意 IP](#use-krawl-to-ban-malicious-ips)
- [IP 信誉](#ip-reputation)
- [在反向代理或 CDN 后运行](#running-behind-a-reverse-proxy-or-cdn)
- [指标与监控](#metrics--monitoring)
- [附加文档](#additional-documentation)
- [使用 AI 进行欺骗](#ai-generated-deception-pages)
- [贡献](#contributing)
## 演示
提示:爬取 `robots.txt` 中的路径可获得额外乐趣
### Krawl URL: [http://demo.krawlme.com](http://demo.krawlme.com)
### 查看仪表盘 [http://demo.krawlme.com/das_dashboard](http://demo.krawlme.com/das_dashboard)
## 什么是 Krawl?
**Krawl** 是一个云原生欺骗服务器,旨在检测、延迟和分析恶意攻击者、网络爬虫和自动化扫描器。
它创建逼真的虚假 Web 应用程序,其中充满了易于得手的目标,如管理面板、配置文件和暴露的虚假凭据,以吸引和识别可疑活动。
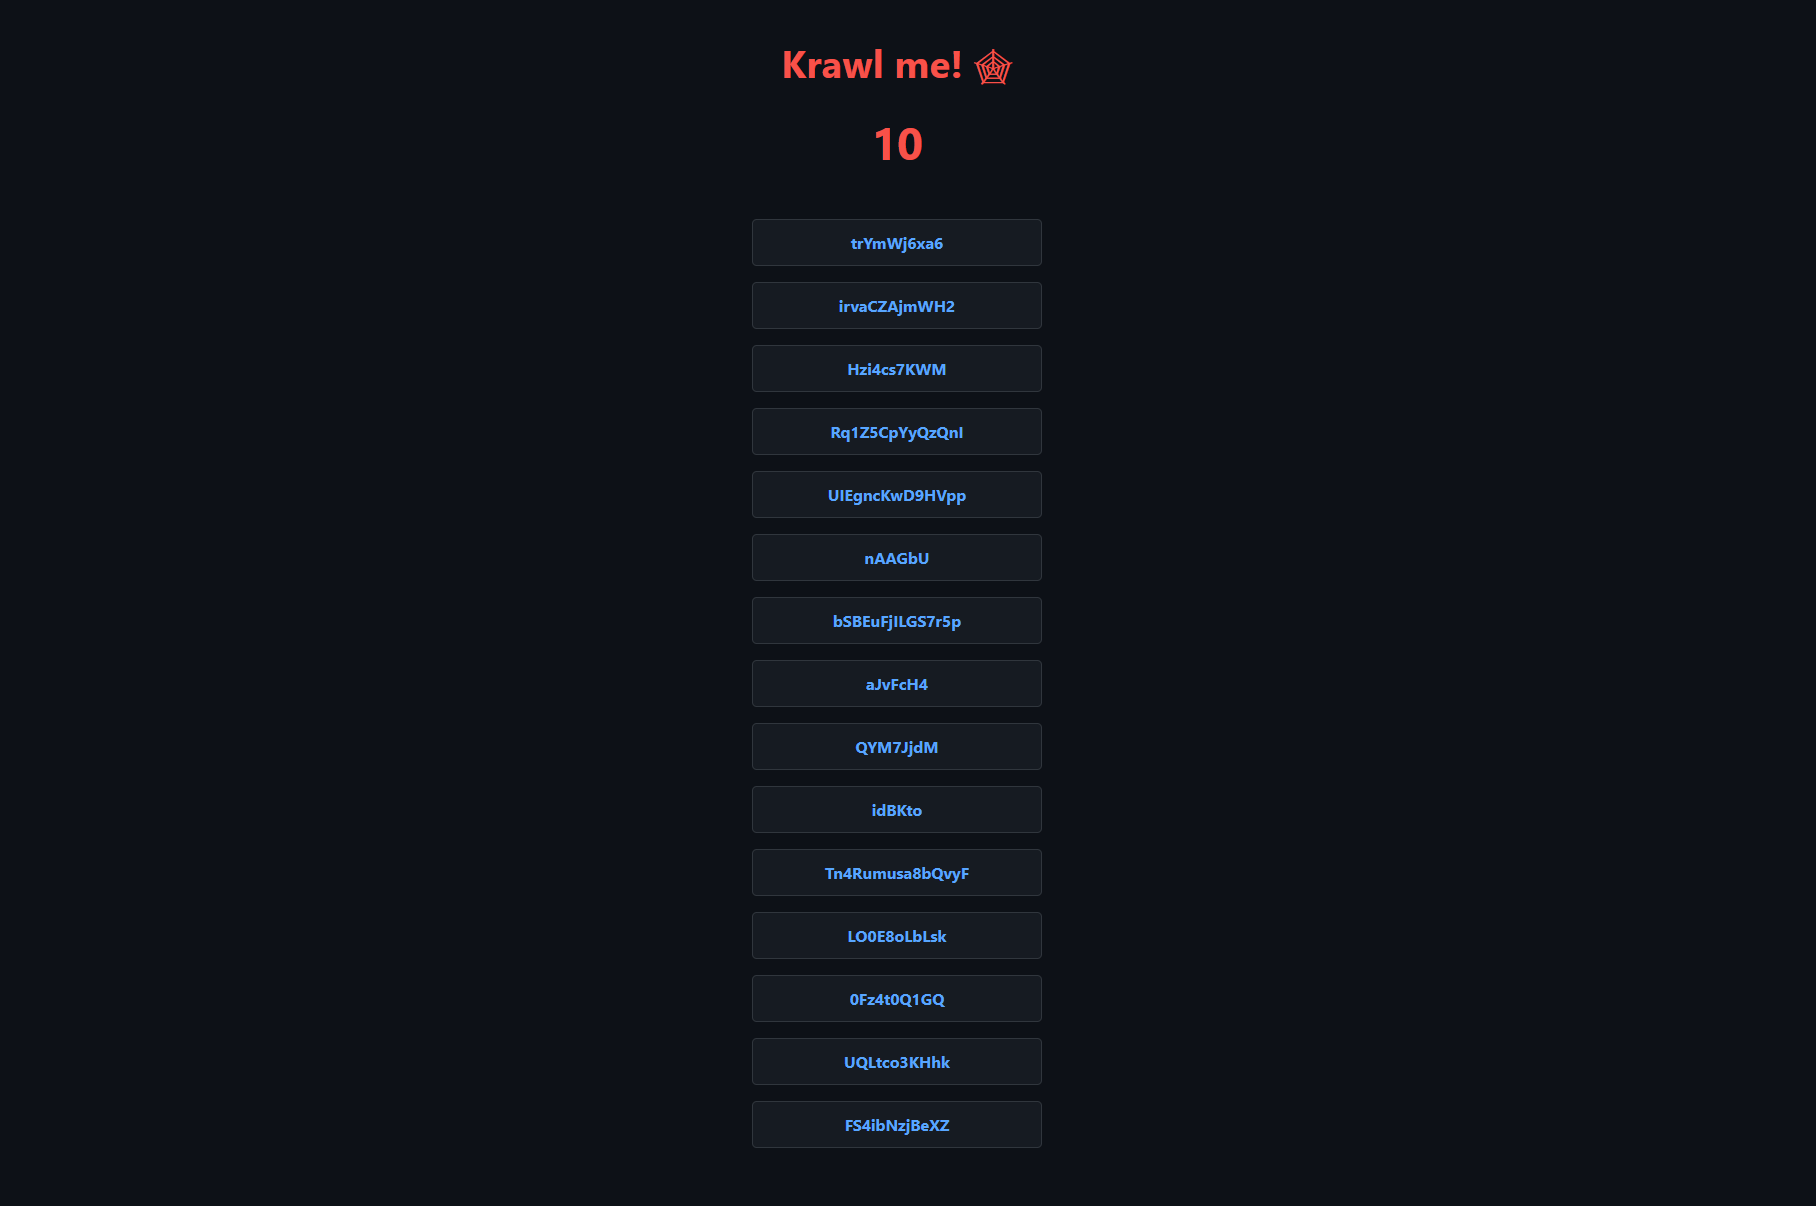
通过消耗攻击者的资源,Krawl 有助于清晰地区分恶意行为和合法爬虫。
其特点包括:
- **[AI 生成的欺骗页面](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)**:**让攻击者帮助生成你的虚假易受攻击的攻击面**
- **蜘蛛陷阱页面**:基于 [spidertrap 项目](https://github.com/adhdproject/spidertrap) 的无限随机链接,以消耗爬虫资源
- **虚假登录页面**:WordPress、phpMyAdmin、管理面板
- **蜜罐路径**:在 robots.txt 中公布以捕获扫描器
- **虚假凭据**:看起来逼真的用户名、密码、API 密钥
- **[金丝雀令牌](https://github.com/blessedrebus/krawl/blob/main/docs/canary-token.md)集成**:触发外部警报
- **随机服务器标头**:基于服务器标头和版本混淆攻击
- **实时仪表盘**:监控可疑活动
- **可定制词表**:基于 JSON 的简易配置
- **随机错误注入**:模拟真实服务器行为
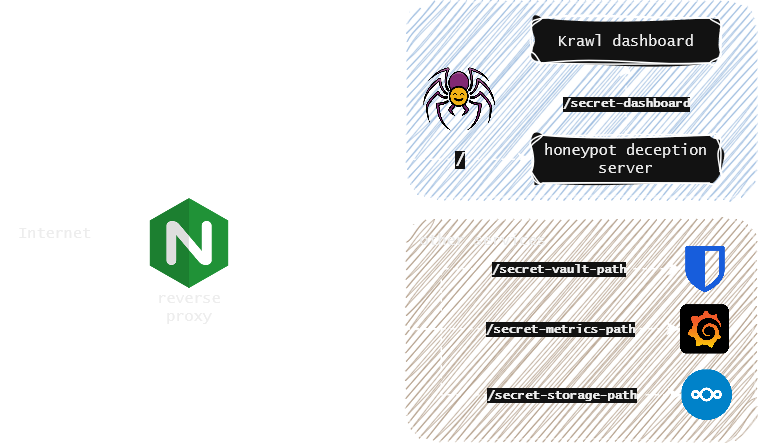
你可以轻松地将 Krawl 与其他服务一起暴露,使用反向代理保护它们免受网络爬虫和恶意用户的侵害。更多详情,请参阅[反向代理文档](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md)。
## Krawl 仪表盘
Krawl 提供了一个全面的仪表盘,可通过启动时生成的**随机秘密路径**或通过 `KRAWL_DASHBOARD_SECRET_PATH` 配置的**自定义路径**访问。这使仪表盘对扫描你蜜罐的攻击者保持隐藏。
仪表盘分为六个标签页:
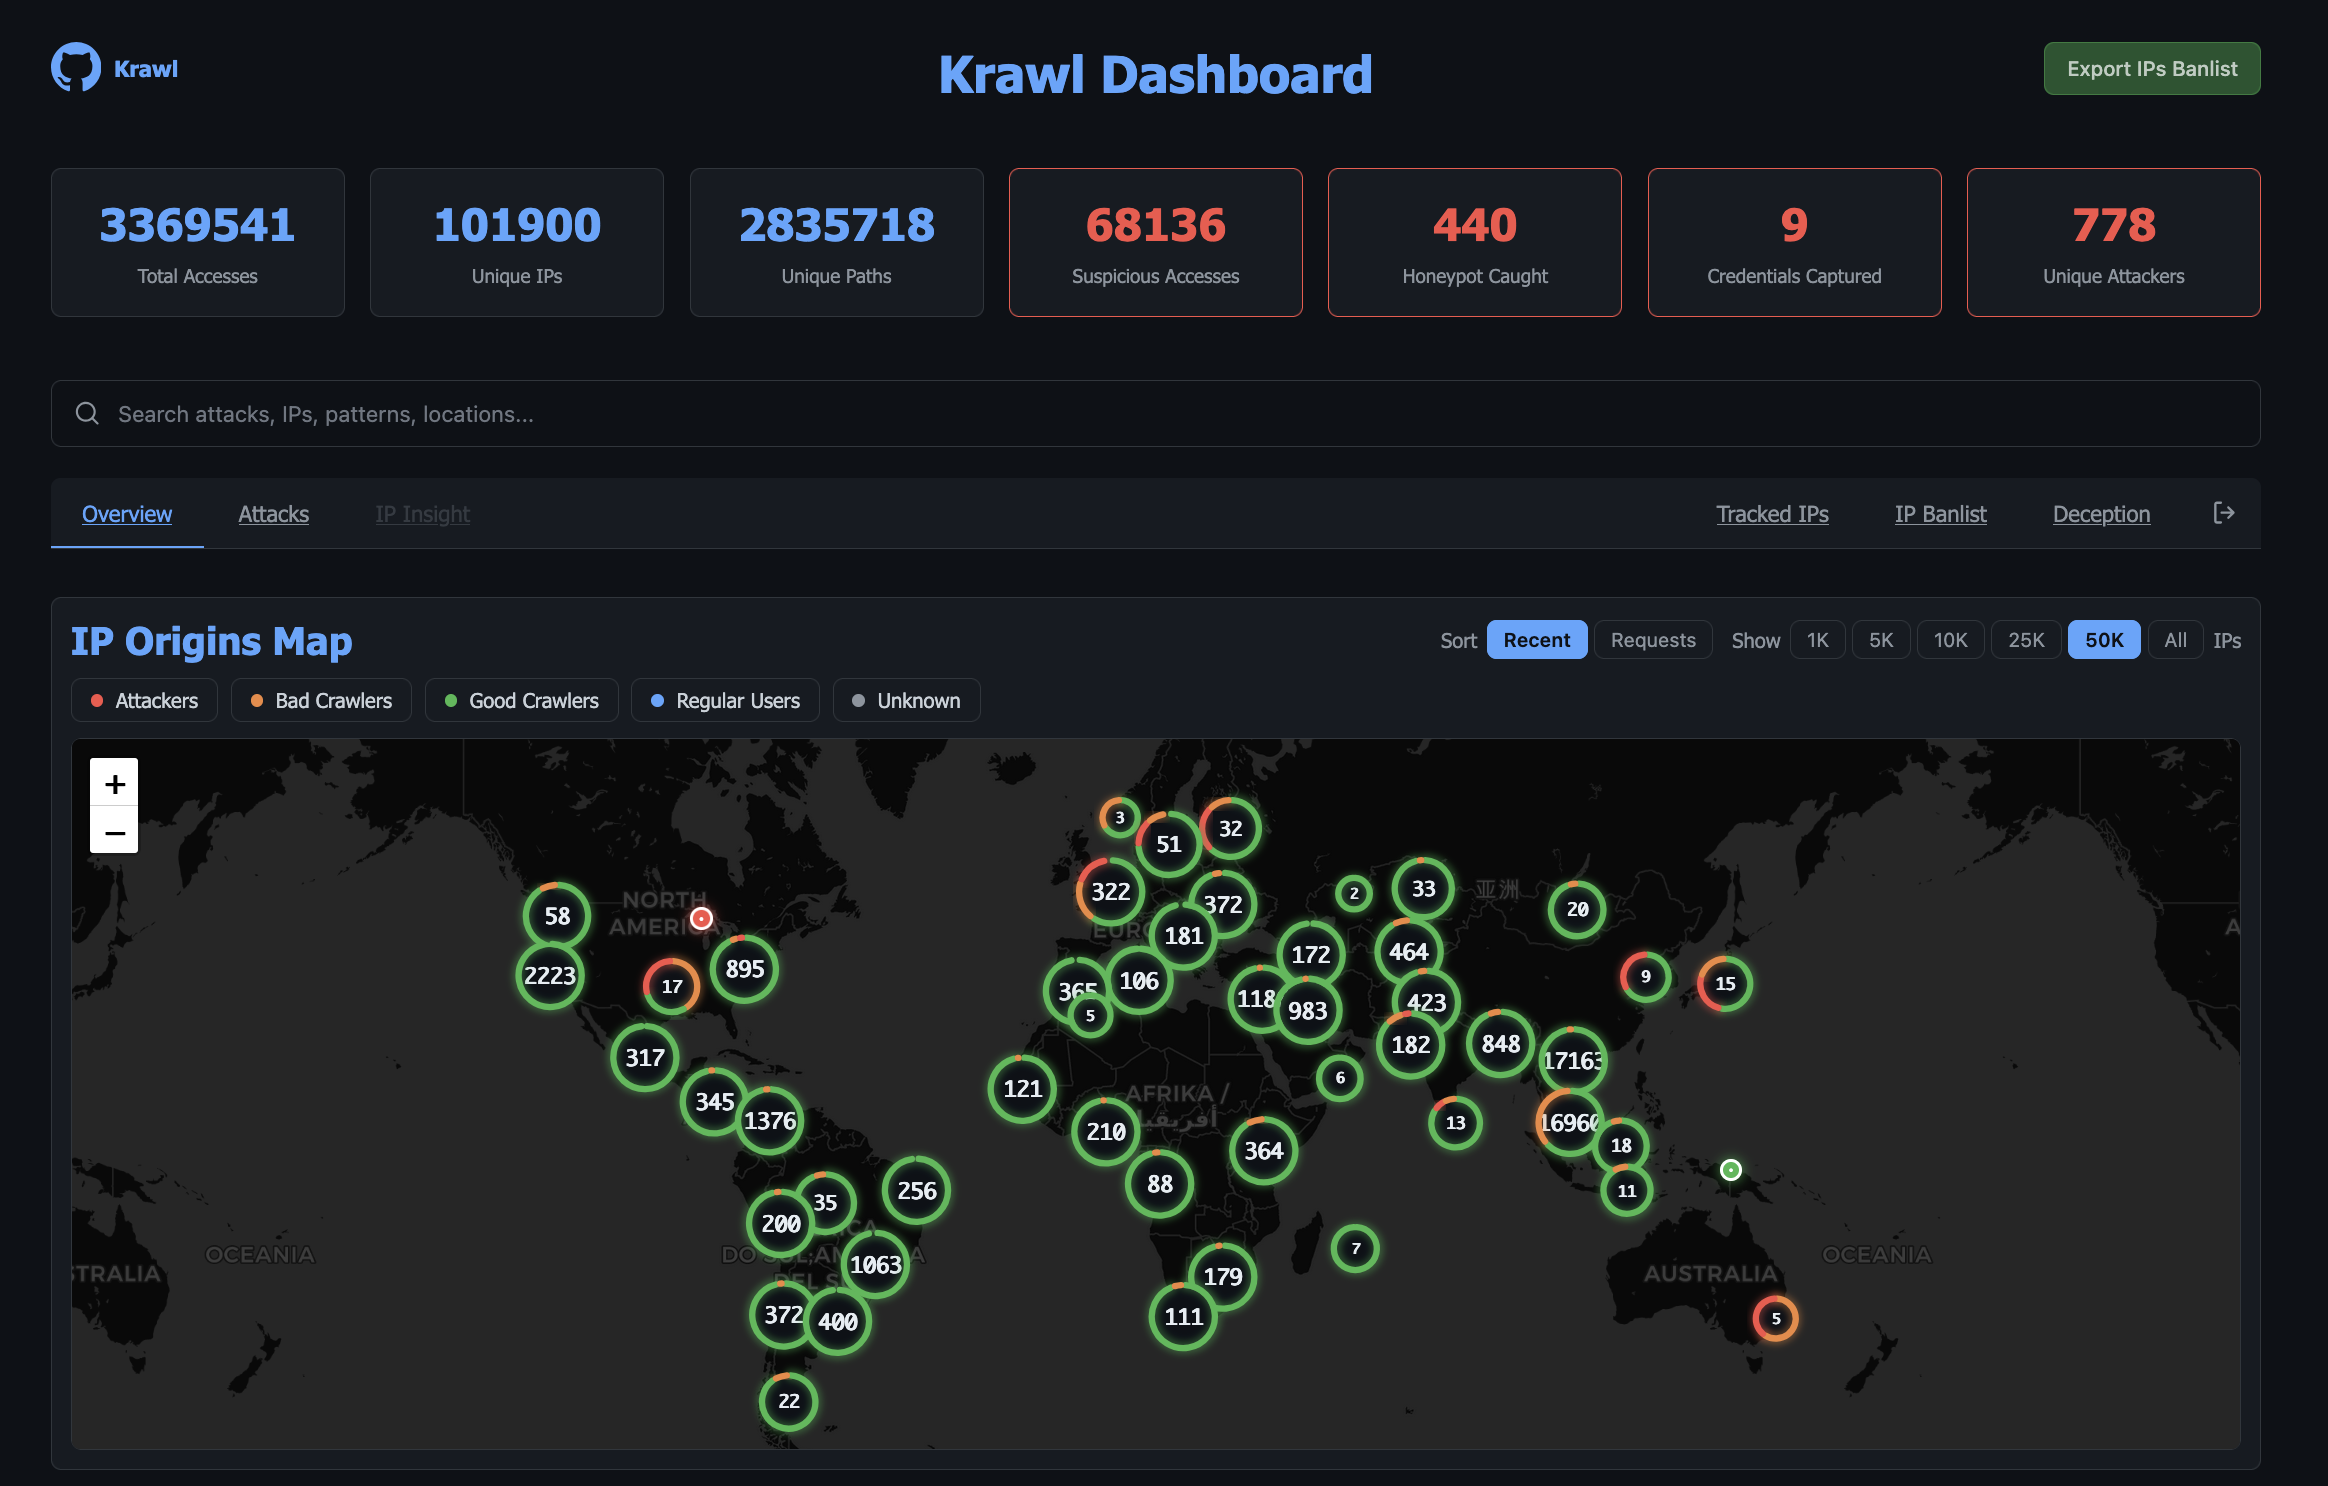
- **概览**:攻击活动的高级视图:IP 来源的交互式地图、最近的可疑请求,以及顶级 IP、User-Agent 和路径。
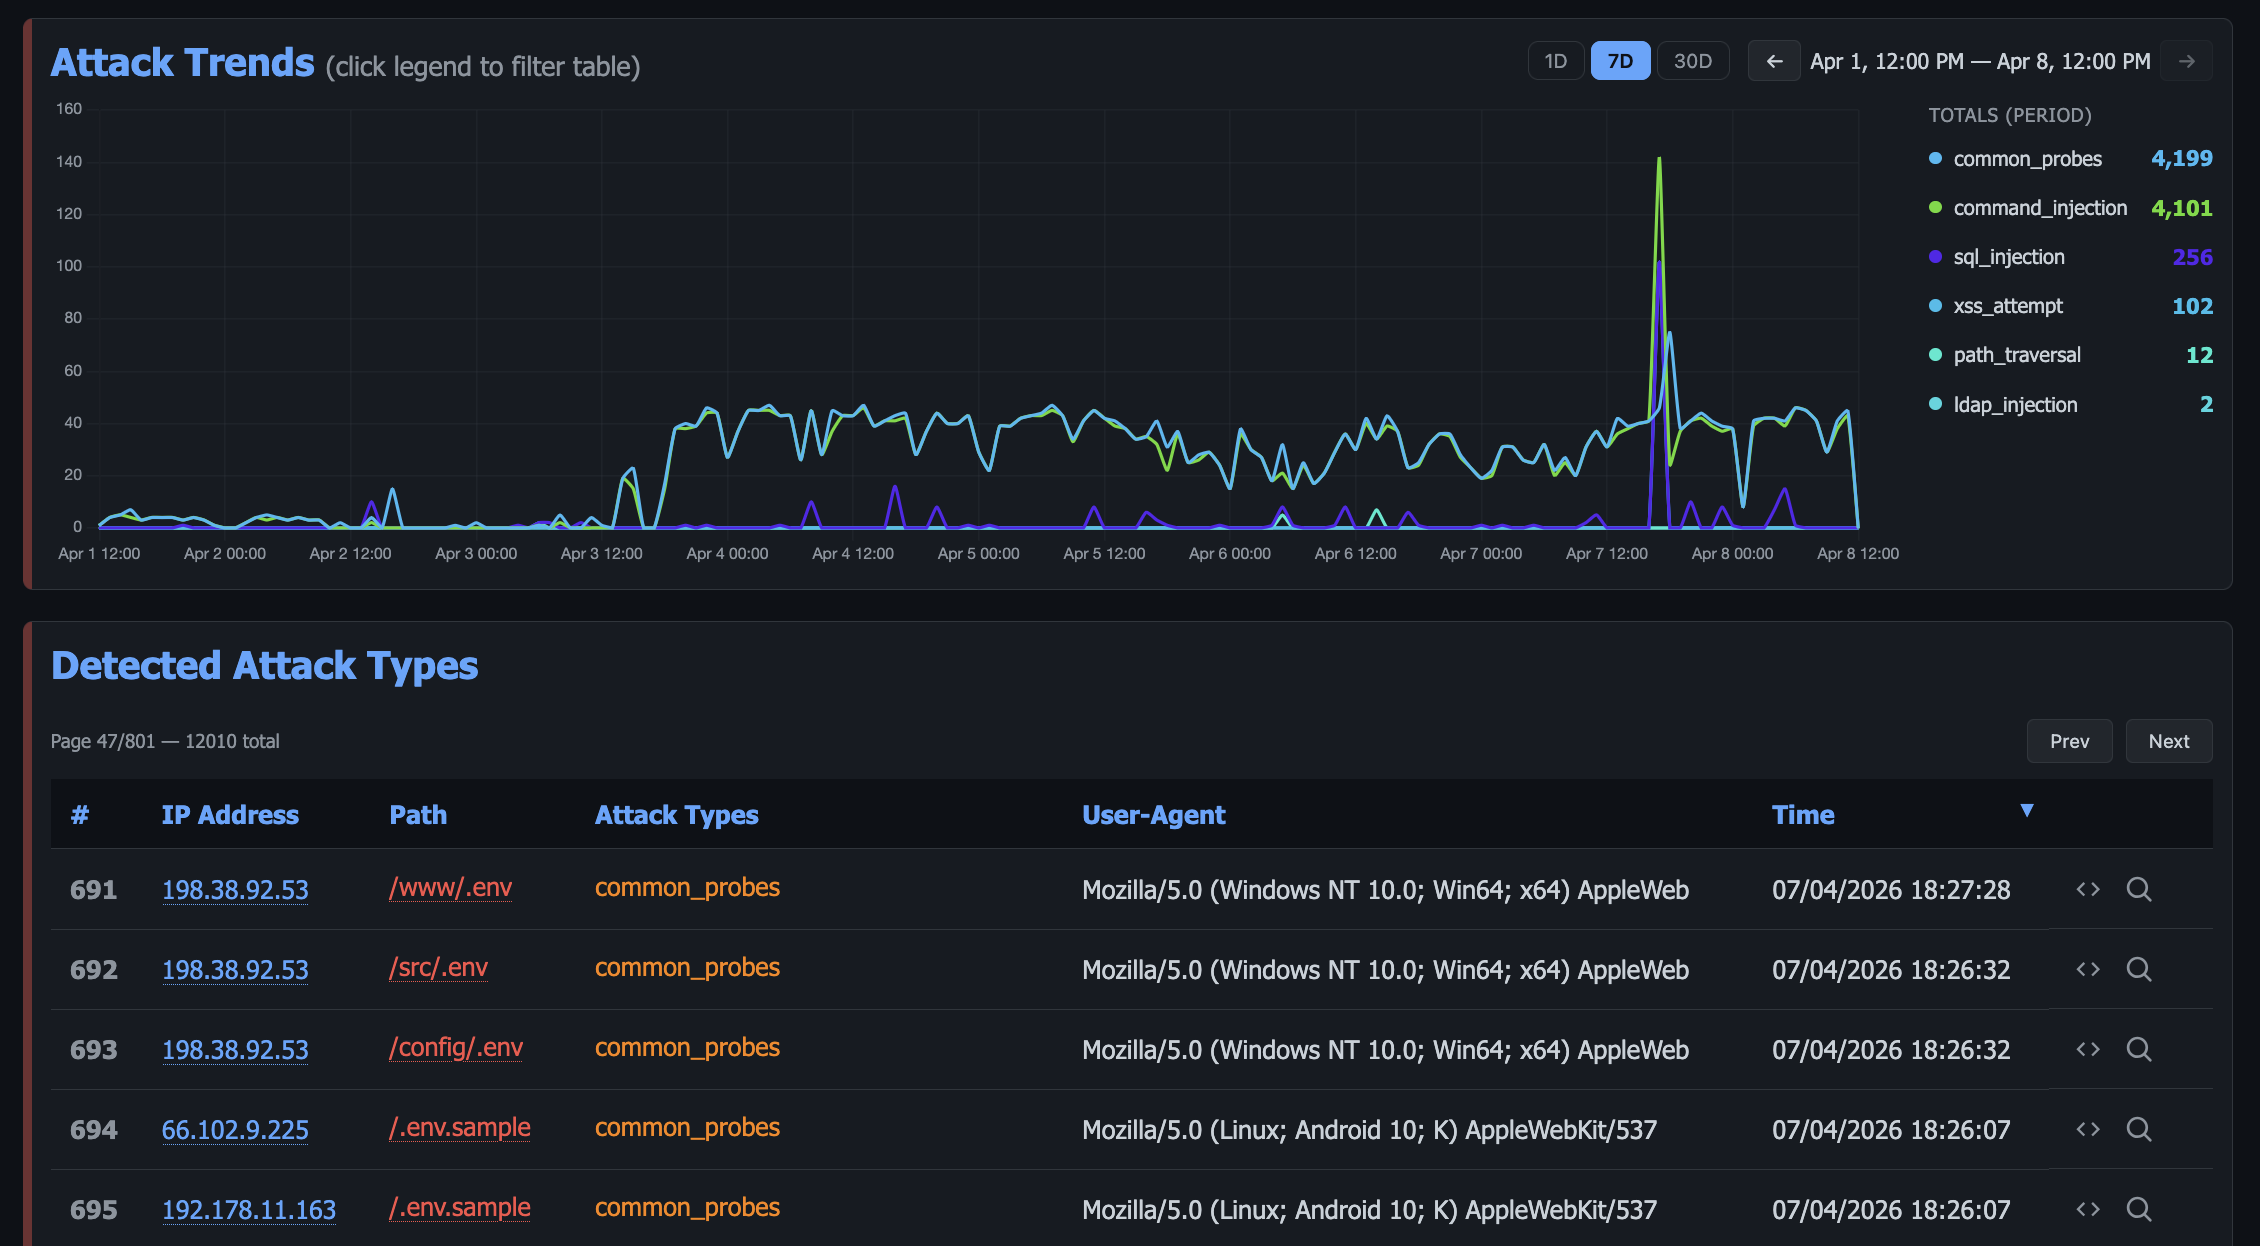
- **攻击**:捕获的凭据、蜜罐触发器和检测到的攻击类型(SQLi、XSS、路径遍历等)的详细分类,配有图表和表格。
- **威胁**:将有效载荷按 TLSH 模糊哈希分组为战役,因此一个 webshell 及其编辑变体会被识别为同一战役,而非不相关的命中,并附有所有捕获文件的索引。
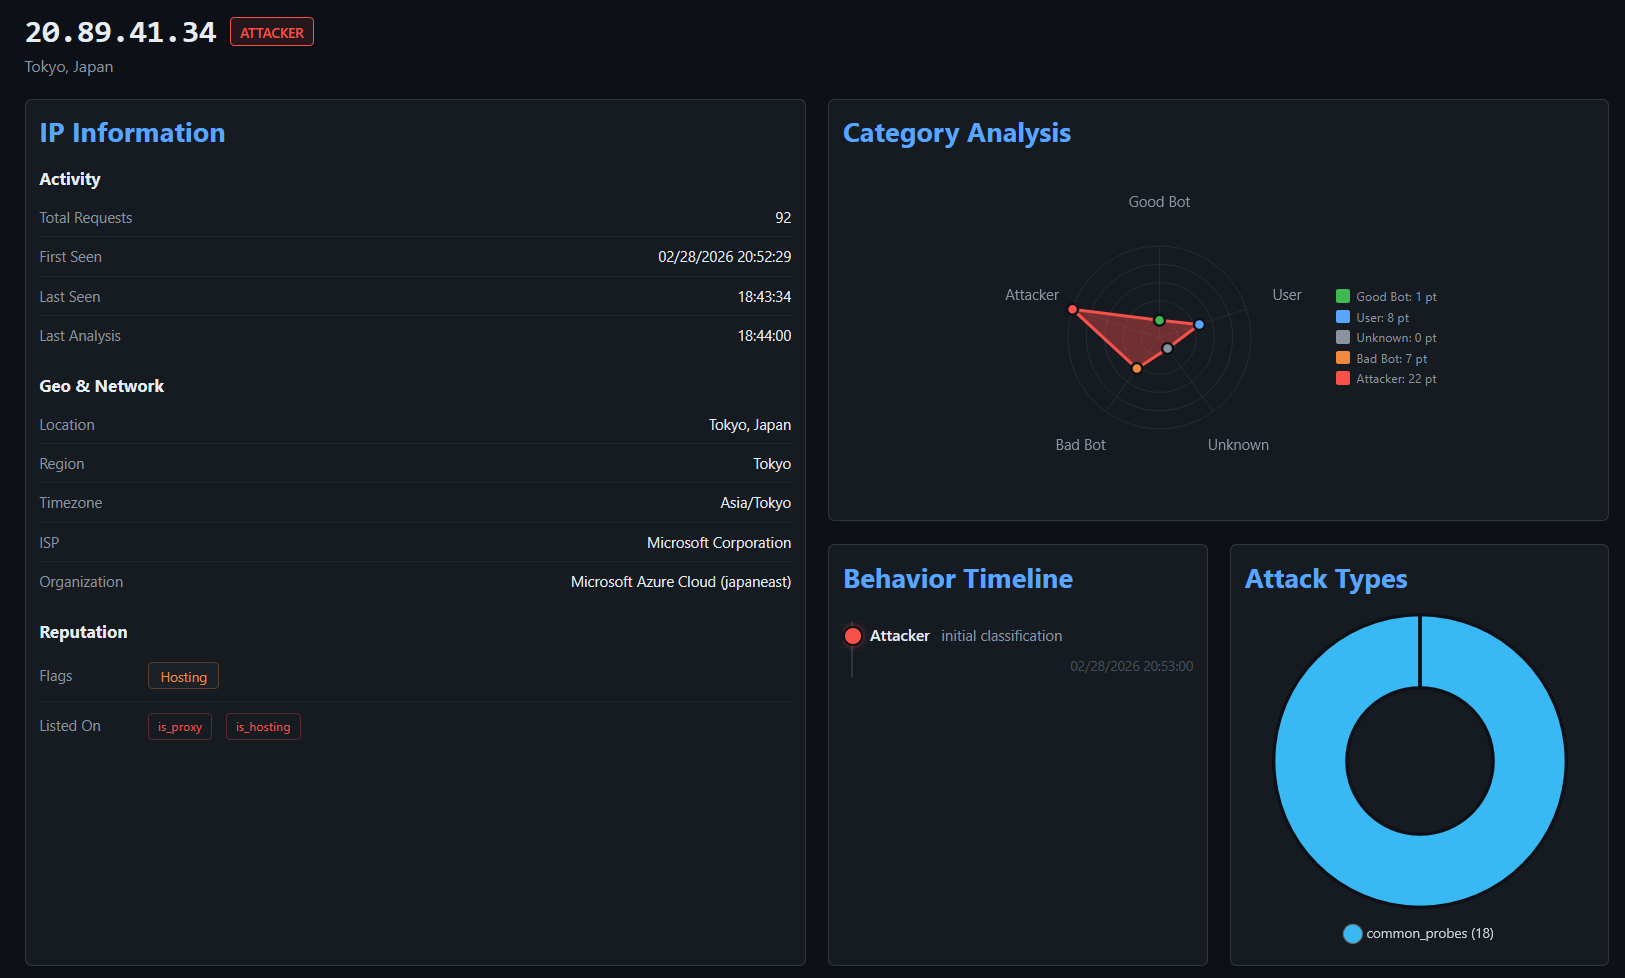
- **IP 洞察**:对所选 IP 的深入取证视图:地理位置、ISP/ASN 信息、信誉标记、行为时间线、攻击类型分布、引用来源历史、捕获的文件和凭据,以及完整的访问历史。
此外,使用仪表盘密码进行身份验证后,受保护的标签页将变为可用:
- **追踪的 IP**:维护你想要长期监控的 IP 地址观察列表。
- **IP 封禁列表**:管理 IP 封禁、查看检测到的攻击者,并以原始或 IPTables 格式导出封禁列表。
- **超时 IP**:查看当前被扣留在 tarpit 中的 IP,并豁免任何不应被扣留的 IP。
- **欺骗**:管理 AI 生成的页面,导出它们或导入新页面。
- **Webhook**:将封禁转发到 CloudFlare 和其他防火墙。
标题栏图标可打开 API 文档、封禁列表导出,以及一个显示运行配置的设置面板和一个用于按需运行计划任务的维护页面。
更多详情,请参阅[仪表盘文档](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard.md)。
## 部署模式
Krawl 支持两种部署模式,由 `config.yaml` 中的 `mode` 设置或 `KRAWL_MODE` 环境变量控制。
| | 独立模式 | 可扩展模式 |
|---|---|---|
| **数据库** | SQLite (WAL 模式) | PostgreSQL |
| **缓存** | 内存中的 Python 字典 | Redis(多级 TTL) |
| **副本数** | 1(单实例) | 1+(水平扩展) |
| **外部依赖** | 无 | PostgreSQL + Redis |
| **适用场景** | 开发、家庭实验室、<50 万请求 | 生产、高可用、>50 万请求 |
**独立模式**:适用于开发环境或请求量较低的家庭实验室。无需额外配置,只需运行 Krawl 即可工作。
- 单容器部署,无外部依赖
- 更低的 RAM 和资源占用
**可扩展模式**:专为生产环境或高流量蜜罐设计。Helm chart 默认使用此模式。
- 得益于 Redis 多级缓存,仪表盘更快、响应更灵敏
- Redis 作为 PostgreSQL 前面的热路径缓存,降低磁盘 I/O
- 水平扩展,在负载均衡器后增加 Krawl 副本数量
有关详细配置、Docker Compose 示例、Kubernetes/Helm 设置以及分步迁移说明,请参阅[部署模式文档](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md)。
## Krawl 封禁列表
Krawl 维护一份定期更新的 [`banlist.txt`](https://github.com/blessedrebus/krawl/blob/main/banlist.txt),其中包含**触发了其蜜罐陷阱的攻击者**的 IP 地址。该封禁列表每周发布并可下载,帮助社区即使不使用 Krawl 也能预先阻止已知的恶意行为者。
封禁列表也可直接从以下地址获取:
[https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw](https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw)。
### 在实例之间共享封禁列表
Krawl 实例可以联合其封禁列表:每个实例都可以在未认证路径上发布自己的列表,并拉取其他实例(或任何纯文本 IP 列表)的列表。获取的 IP 会合并到本地封禁决策中,并显示在仪表盘上。```yaml
banlist:
# Public, unauthenticated download path for this instance's banlist.
# Supports the same ?categories= and ?fwtype= parameters as the main API.
# Empty = disabled.
export_path: "/public_banlist.txt"
# Upstream banlists to fetch and merge. Plain ".txt" lists work too.
sources:
- "https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw"
- "https://krawl.example.com/public_banlist.txt"
refresh_interval: 3600 # seconds between fetches
```
## 快速开始
### Docker 运行
使用最新镜像以独立模式运行 Krawl:```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard" \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-v krawl-data:/app/data \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
访问服务器地址 `http://localhost:5000`
### Docker Compose
创建一个 `docker-compose.yaml` 文件,选择以下两种部署模式之一。
**独立模式**:仅包含使用 Sqlite 存储的 Krawl 服务器:```yaml
services:
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
- krawl-data:/app/data
restart: unless-stopped
volumes:
krawl-data:
```
**可扩展**:使用 PostgreSQL 和 Redis:
> [!CAUTION]
> 以下示例使用**默认密码**(`krawl`/`krawl`)。**在生产环境部署前请务必修改。**```yaml
services:
postgres:
image: postgres:16-alpine
environment:
POSTGRES_DB: krawl
POSTGRES_USER: krawl
POSTGRES_PASSWORD: krawl
volumes:
- postgres_data:/var/lib/postgresql/data
restart: unless-stopped
healthcheck:
test: ["CMD-SHELL", "pg_isready -U krawl -d krawl"]
interval: 10s
timeout: 5s
retries: 5
redis:
image: redis:7-alpine
volumes:
- redis_data:/data
restart: unless-stopped
healthcheck:
test: ["CMD", "redis-cli", "ping"]
interval: 10s
timeout: 5s
retries: 5
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
- KRAWL_MODE=scalable
- KRAWL_POSTGRES_HOST=postgres
- KRAWL_POSTGRES_PORT=5432
- KRAWL_POSTGRES_USER=krawl
- KRAWL_POSTGRES_PASSWORD=krawl
- KRAWL_POSTGRES_DATABASE=krawl
- KRAWL_REDIS_HOST=redis
- KRAWL_REDIS_PORT=6379
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
restart: unless-stopped
depends_on:
postgres:
condition: service_healthy
redis:
condition: service_healthy
volumes:
postgres_data:
redis_data:
```
要部署,只需运行```bash
docker compose up -d
```
生产就绪的 compose 文件也可在 [`docker/`](https://github.com/blessedrebus/krawl/blob/main/docker) 目录中找到。对于**开发**(从源码构建并支持热重载),请使用 [`docker/dev/`](https://github.com/blessedrebus/krawl/blob/main/docker/dev) 中的 compose 文件。
有关两种模式的更多详细信息,请参阅 [部署模式](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md)。
### Kubernetes
**Krawl 也可原生运行在 Kubernetes 上**。安装可通过 [manifest](https://github.com/blessedrebus/krawl/blob/main/kubernetes/README.md) 或 [使用 Helm chart](https://github.com/blessedrebus/krawl/blob/main/helm/README.md) 完成。
Helm chart **默认使用可扩展模式**,并捆绑 PostgreSQL 和 Redis:```bash
helm install krawl oci://ghcr.io/blessedrebus/krawl-chart --version 2.4.0 \
-n krawl-system --create-namespace \
--set postgres.password=your-password \
--set redis.password=your-redis-password \
--set dashboardPassword=your-dashboard-password \
--set config.dashboard.secret_path=/my-secret-dashboard
```
两种模式均提供了最小示例 values 文件:
- [`values-minimal.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-minimal.yaml) ---> 可扩展(默认)
- [`values-standalone.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-standalone.yaml) ---> 独立
有关完整配置和迁移说明,请参阅[部署模式](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md)和[Chart 文档](https://github.com/blessedrebus/krawl/blob/main/helm/README.md)。
### Uvicorn (Python)
使用 Python 3.13+ 和 uvicorn 直接运行 Krawl,用于本地开发或测试:```bash
pip install -r requirements.txt
uvicorn app:app --host 0.0.0.0 --port 5000 --app-dir src --no-server-header
```
访问服务器地址 `http://localhost:5000`
## 配置
Krawl 使用**配置层级**,其中**环境变量优先于配置文件**。此方法推荐用于 Docker 部署和快速开箱即用定制。
### 通过 config.yaml 配置
您可以使用 [config.yaml](https://github.com/blessedrebus/krawl/blob/main/config.yaml) 文件进行高级配置,例如 Docker Compose 或 Helm chart 部署。
### 通过环境变量配置
所有设置均可作为环境变量提供,并覆盖 `config.yaml`。
变量名为 `KRAWL_` 加上大写形式的设置路径,因此 `dashboard.password`
变为 `KRAWL_DASHBOARD_PASSWORD`。
<details>
<summary><b>服务器与链接生成</b>(11 个变量)</summary>
Krawl 如何呈现自身并塑造生成页面的迷宫。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `CONFIG_LOCATION` | yaml 配置文件路径 | `config.yaml` |
| `KRAWL_PORT` | 服务器监听端口 | `5000` |
| `KRAWL_DELAY` | 响应延迟(毫秒) | `100` |
| `KRAWL_SERVER_HEADER` | 用于欺骗的 HTTP Server 头 | `""` |
| `KRAWL_LINKS_LENGTH_RANGE` | 链接长度范围,格式为 `min,max` | `5,15` |
| `KRAWL_LINKS_PER_PAGE_RANGE` | 每页链接数,格式为 `min,max` | `10,15` |
| `KRAWL_CHAR_SPACE` | 用于链接生成的字符 | `abcdefgh...` |
| `KRAWL_MAX_COUNTER` | 初始计数器值 | `10` |
| `KRAWL_PROBABILITY_ERROR_CODES` | 错误响应概率(0-100%) | `0` |
| `KRAWL_INFINITE_PAGES_FOR_MALICIOUS` | 向恶意 IP 提供无限页面 | `true` |
| `KRAWL_MAX_PAGES_LIMIT` | 爬虫的最大页面限制 | `250` |
| `KRAWL_BAN_DURATION_SECONDS` | 被限速 IP 的封禁时长(秒) | `600` |
</details>
<details>
<summary><b>仪表盘、指标与日志</b>(13 个变量)</summary>
仪表盘访问、缓存预热、Prometheus 和日志级别。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_DASHBOARD_SECRET_PATH` | 自定义仪表盘路径 | 自动生成 |
| `KRAWL_DASHBOARD_PASSWORD` | 受保护仪表盘面板的密码 | 自动生成 |
| `KRAWL_DASHBOARD_CACHE_WARMUP` | 每 5 分钟预计算仪表盘数据以实现即时页面加载 | `true` |
| `KRAWL_DASHBOARD_WARMUP_PAGES` | 每个表格面板预热的页面数 | `10` |
| `KRAWL_DASHBOARD_WARMUP_AGGREGATION` | 预计算完整的 top_paths/top_ua 聚合以实现零查询服务 | `false` |
| `KRAWL_DASHBOARD_TOP_N_MIN_COUNT` | top paths/user agents 面板的最小访问计数(设为 1 以禁用) | `5` |
| `KRAWL_DASHBOARD_BRAND_NAME` | 仪表盘字标和标题中的名称 | `Krawl` |
| `KRAWL_DASHBOARD_BRAND_URL` | 字标链接的位置(为空则渲染为纯文本) | Krawl 的仓库 |
| `KRAWL_DASHBOARD_BRAND_LOGO` | 替代 GitHub 标记显示的图片 URL | 未设置 |
| `KRAWL_DASHBOARD_BRAND_SHOW_VERSION` | 在名称旁显示版本 | `true` |
| `KRAWL_DASHBOARD_BRAND_CONTACT` | 字标下方显示的联系方式(地址、URL 或纯文本) | 未设置 |
| `KRAWL_METRICS_ENABLED` | 在 `/<dashboard_path>/metrics` 暴露 Prometheus 指标 | `true` |
| `KRAWL_LOG_LEVEL` | 应用程序日志级别(`DEBUG`、`INFO`、`WARNING`、`ERROR`) | `INFO` |
</details>
<details>
<summary><b>数据库、保留与备份</b>(12 个变量)</summary>
存储位置、数据保留时长以及转储任务。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_DATABASE_PATH` | 数据库文件位置 | `data/krawl.db` |
| `KRAWL_DATABASE_PERSIST_SUSPICIOUS_ONLY` | 仅将可疑请求持久化到访问日志 | `false` |
| `KRAWL_MAP_TILE_URL` | 仪表盘地图的瓦片 URL 模板(`{z}/{x}/{y}`,可选 `{s}`/`{r}`) | Esri dark canvas |
| `KRAWL_MAP_TILE_ATTRIBUTION` | 地图上显示的归属信息 | Esri/OSM |
| `KRAWL_MAP_API_KEY` | 作为查询参数附加到每个瓦片请求——CARTO 要求 | _(空)_ |
| `KRAWL_MAP_API_KEY_PARAM` | 该查询参数的名称(`api_key`、`apikey`、`key`) | `api_key` |
| `KRAWL_IPV6_IGNORE` | 完全丢弃 IPv6 请求:仍记录到 stdout,但从不持久化、封禁检查或导出 | `false` |
| `KRAWL_IPV6_PURGE_EXISTING` | 在下次启动时同时删除现有 IPv6 行(不可逆;需要 `KRAWL_IPV6_IGNORE`) | `false` |
| `KRAWL_DATABASE_RETENTION_DAYS` | 数据库中数据保留天数 | `30` |
| `KRAWL_BACKUPS_PATH` | 数据库转储保存路径 | `backups` |
| `KRAWL_BACKUPS_CRON` | 控制备份任务计划的 cron 表达式 | `*/30 * * * *` |
| `KRAWL_BACKUPS_ENABLED` | 启用数据库转储任务的布尔值 | `true` |
</details>
<details>
<summary><b>陷阱:tarpit、欺骗页面与金丝雀</b>(6 个变量)</summary>
可选的陷阱以及向攻击者提供的页面。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_TARPIT_ENABLED` | 用缓慢响应和随机文本诱捕 AI 代理 | `false` |
| `KRAWL_TARPIT_DELAY_SECONDS` | tarpit 激活时每次响应额外增加的延迟秒数 | `5` |
| `KRAWL_DECEPTION_IMPORT_PAGES` | 启动时从 `src/templates/deception/` 自动导入欺骗页面 | `true` |
| `KRAWL_CUSTOM_TEMPLATE_PATH` | 容器内自定义 HTML 模板的路径。模板必须包含 `{counter}` 和 `{content}` 占位符。 | `/templates/custom_page.html` |
| `KRAWL_CANARY_TOKEN_URL` | 外部金丝雀令牌 URL | 无 |
| `KRAWL_CANARY_TOKEN_TRIES` | 显示金丝雀令牌前的请求次数 | `10` |
</details>
<details>
<summary><b>IP 信誉分析器</b>(6 个变量)</summary>
决定 IP 如何被分类的阈值。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_HTTP_RISKY_METHODS_THRESHOLD` | 风险 HTTP 方法检测阈值 | `0.1` |
| `KRAWL_VIOLATED_ROBOTS_THRESHOLD` | robots.txt 违规阈值 | `0.1` |
| `KRAWL_UNEVEN_REQUEST_TIMING_THRESHOLD` | 时序变异系数阈值 | `0.5` |
| `KRAWL_UNEVEN_REQUEST_TIMING_TIME_WINDOW_SECONDS` | 请求时序分析的时间窗口(秒) | `300` |
| `KRAWL_USER_AGENTS_USED_THRESHOLD` | 检测多个用户代理的阈值 | `2` |
| `KRAWL_ATTACK_URLS_THRESHOLD` | 攻击 URL 检测阈值 | `1` |
</details>
<details>
<summary><b>威胁情报捕获</b>(4 个变量)</summary>
对捕获的载荷(文件和标记的请求体)进行模糊哈希,并将
近似重复的变体分组为活动集群。需要 `py-tlsh`。
哈希作为计划的 `hash-payloads` 后台任务运行(参见
`src/tasks/hash_payloads.py`),该任务对每个捕获的攻击哈希一次——新
命中在摄取时进行,以及对现有历史的一次性向后扫描
(由 `payload_hash_watermark` 高水位标记跟踪)——然后将
摘要聚类为重复模式活动。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_TLSH_ENABLED` | 使用 TLSH 对上传文件和标记的请求体进行哈希以实现近似重复聚类 | `true` |
| `KRAWL_TLSH_CLUSTER_THRESHOLD` | 载荷加入现有活动的 TLSH 距离阈值(0 = 字节完全相同;webshell 的变体通常差异 < 100) | `150` |
| `KRAWL_TLSH_CAMPAIGN_MIN_EVENTS` | 载荷必须被看到多少次其活动才会出现在 Threats 标签页中 | `10` |
| `KRAWL_REFERER_ENABLED` | 在访问日志中记录入站 HTTP Referer,用于诱饵链跟踪 | `true` |
</details>
<details>
<summary><b>封禁列表与被忽略的 IP</b>(4 个变量)</summary>
与其他实例共享封禁列表,以及永不跟踪的流量。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_IGNORED_IPS` | 逗号分隔的 IP/CIDR,永不跟踪、封禁或导出 | 回环、RFC1918、链路本地、CGNAT |
| `KRAWL_BANLIST_EXPORT_PATH` | 公共封禁列表下载路径,例如 `/public_banlist.txt`(为空 = 禁用) | `""` |
| `KRAWL_BANLIST_SOURCES` | 逗号分隔的上游封禁列表 URL,用于获取并合并 | Krawl 社区封禁列表 |
| `KRAWL_BANLIST_REFRESH_INTERVAL` | 上游封禁列表获取间隔秒数 | `3600` |
</details>
<details>
<summary><b>AI 生成的欺骗页面</b>(10 个变量)</summary>
参见 [AI 生成文档](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_AI_ENABLED` | 启用 AI 生成的欺骗页面 | `false` |
| `KRAWL_AI_PROVIDER` | AI 提供商(`"openrouter"` 或 `"openai"`) | `"openrouter"` |
| `KRAWL_AI_OPENAI_BASE_URL` | 用于自定义 API 端点的可选 OpenAI Base URL | `"https://api.openai.com/v1"` |
| `KRAWL_AI_API_KEY` | AI 提供商的 API 密钥 | `None` |
| `KRAWL_AI_MODEL` | 用于页面生成的 AI 模型 | `"nvidia/nemotron-3-super-120b-a12b:free"` |
| `KRAWL_AI_TIMEOUT` | AI API 调用的请求超时秒数 | `60` |
| `KRAWL_AI_MAX_DAILY_REQUESTS` | 每天 AI 生成页面的最大数量(0 = 无限制) | `0` |
| `KRAWL_AI_PROMPT` | 用于 AI 页面生成的自定义提示模板 | 默认提示 |
| `KRAWL_AI_REASONING_ENABLED` | 启用推理令牌(仅 OpenRouter 推理模型) | `false` |
| `KRAWL_AI_REASONING_EFFORT` | 推理力度(`none`、`minimal`、`low`、`medium`、`high`、`xhigh`) | `"medium"` |
</details>
<details>
<summary><b>可扩展模式:PostgreSQL 与 Redis</b>(13 个变量)</summary>
仅在 `KRAWL_MODE=scalable` 时使用。参见 [部署模式](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md)。
| 环境变量 | 描述 | 默认值 |
|----------------------|-------------|---------|
| `KRAWL_MODE` | 部署模式(`standalone` 或 `scalable`) | `standalone` |
| `KRAWL_POSTGRES_HOST` | PostgreSQL 主机名 | `localhost` |
| `KRAWL_POSTGRES_PORT` | PostgreSQL 端口 | `5432` |
| `KRAWL_POSTGRES_USER` | PostgreSQL 用户名 | `krawl` |
| `KRAWL_POSTGRES_PASSWORD` | PostgreSQL 密码 | `krawl` |
| `KRAWL_POSTGRES_DATABASE` | PostgreSQL 数据库名 | `krawl` |
| `KRAWL_REDIS_HOST` | Redis 主机名 | `localhost` |
| `KRAWL_REDIS_PORT` | Redis 端口 | `6379` |
| `KRAWL_REDIS_DB` | Redis 数据库编号 | `0` |
| `KRAWL_REDIS_PASSWORD` | Redis 密码 | 无 |
| `KRAWL_REDIS_CACHE_TTL` | 仪表盘预热数据的 TTL(秒) | `600` |
| `KRAWL_REDIS_HOT_TTL` | 热路径数据(封禁信息、IP 类别)的 TTL(秒) | `30` |
| `KRAWL_REDIS_TABLE_TTL` | 分页仪表盘表格的 TTL(秒) | `120` |
</details>
例如```bash
# Set canary token
export CONFIG_LOCATION="config.yaml"
export KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url"
# Set number of pages range (min,max format)
export KRAWL_LINKS_PER_PAGE_RANGE="5,25"
# Set analyzer thresholds
export KRAWL_HTTP_RISKY_METHODS_THRESHOLD="0.2"
export KRAWL_VIOLATED_ROBOTS_THRESHOLD="0.15"
# Set custom dashboard path and password
export KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard"
export KRAWL_DASHBOARD_PASSWORD="my-secret-password"
```
使用环境变量运行 Docker 的示例(独立模式):```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_MODE=standalone \
-e KRAWL_PORT=5000 \
-e KRAWL_DELAY=100 \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-e KRAWL_CUSTOM_TEMPLATE_PATH="/templates/custom_page.html" \
-e KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url" \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
## 使用 Krawl 封禁恶意 IP
Krawl 使用基于信誉的系统对攻击者 IP 地址进行分类,并提供两种导出 IP 列表的方式,以便与防火墙集成。
`/api/export-ips` 端点直接查询数据库,并支持按 IP 类别(`attacker`、`bad_crawler`、`regular_user`、`good_crawler`)和输出格式(`raw`、`iptables`、`nftables`)进行过滤:```bash
curl "https://your-krawl-instance/<DASHBOARD-PATH>/api/export-ips?categories=attacker&fwtype=raw"
```
这实现了跨多种平台自动阻止恶意流量:
* [OPNsense 和 pfSense](https://ipv64.net/v64_blocklist_integration_guide)
* [RouterOS](https://rentry.co/krawl-routeros)
* [IPtables](https://github.com/blessedrebus/krawl/blob/main/plugins/iptables/README.md) 和 [Nftables](https://github.com/blessedrebus/krawl/blob/main/plugins/nftables/README.md)
* [Fail2Ban](https://github.com/blessedrebus/krawl/blob/main/plugins/fail2ban/README.md)
有关完整的 API 参数、示例以及添加自定义防火墙格式,请参阅[防火墙导出器文档](https://github.com/blessedrebus/krawl/blob/main/docs/firewall-exporters.md)。
Krawl 还可以将封禁的 IP 直接推送到 Cloudflare 账户 IP 列表,用于 WAF 规则。同步作为后台任务运行,并按可配置的时间间隔通过完全替换来更新列表。请参阅 [Cloudflare 封禁列表同步](https://github.com/blessedrebus/krawl/blob/main/docs/cloudflare_banlist.md)文档。
## IP 信誉
Krawl [使用分析近期流量的任务来构建并持续更新 IP 信誉](https://github.com/blessedrebus/krawl/blob/main/src/tasks/analyze_ips.py)评分。它定期运行,并根据多个行为指标评估每个活跃 IP 地址,将其分类为攻击者、爬虫或普通用户。阈值完全可自定义。
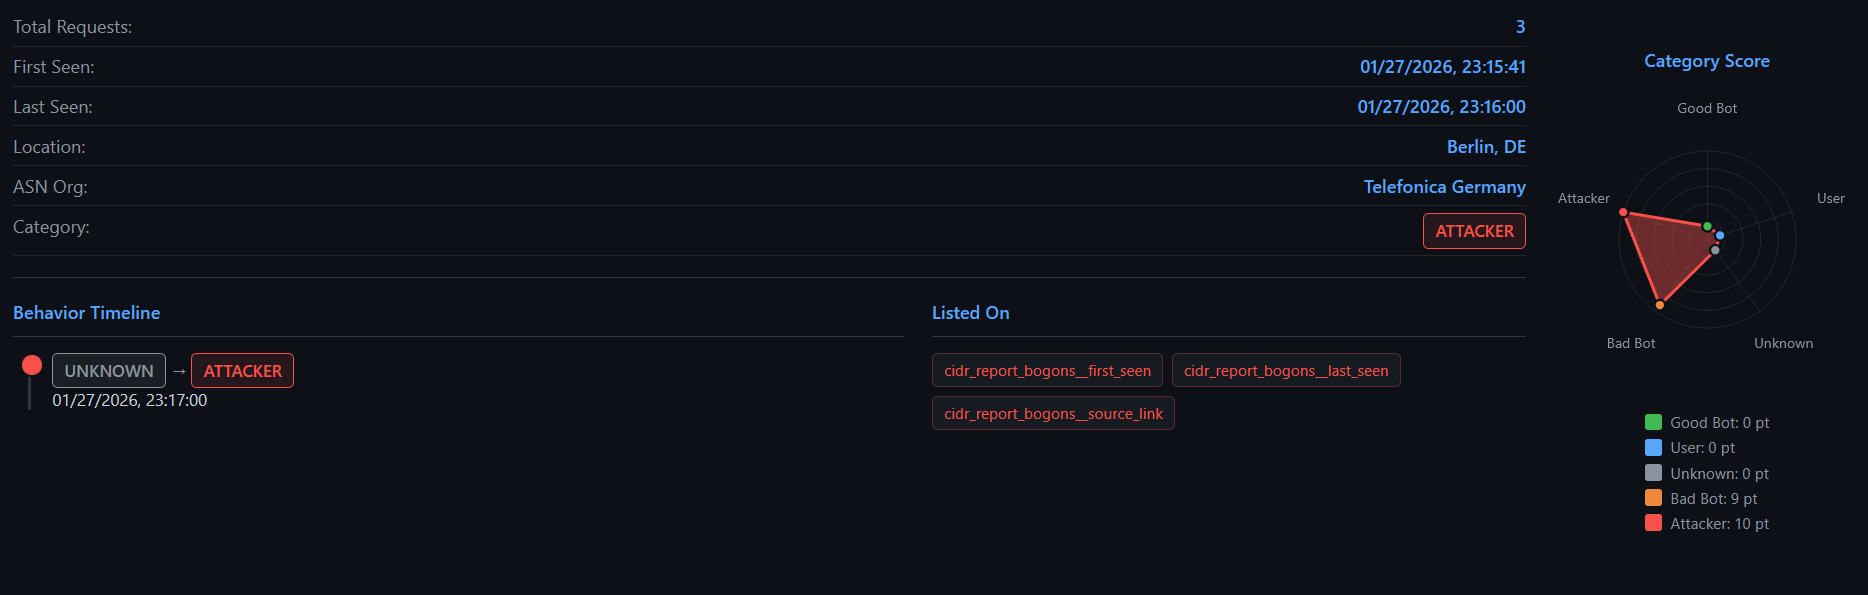
分析包括:
- **高风险 HTTP 方法使用情况**(例如 POST、PUT、DELETE 比例)
- **Robots.txt 违规**
- **请求时间异常**(突发或不规则模式)
- **User-Agent 一致性**
- **攻击 URL 检测**(例如 SQL 注入、XSS 模式)
每个信号都会贡献到一个加权评分模型,该模型会分配一个信誉类别:
- `attacker`
- `bad_crawler`
- `good_crawler`
- `regular_user`
- `unknown`(数据不足时)
生成的评分和指标存储在数据库中,并由 Krawl 用于驱动仪表板、信誉跟踪以及自动缓解操作,例如 IP 封禁或防火墙集成。
## AI 生成的欺骗页面
Krawl 可以使用来自 **OpenRouter** 或 **OpenAI** API 的 AI 模型自动生成逼真的欺骗页面。此功能可即时创建独特且看似合理的蜜罐页面,以欺骗攻击者,而无需手动创建页面。
**主要功能:**
- **动态生成**:为任意请求路径创建独特的 HTML 页面
- **智能缓存**:缓存生成的页面,以避免冗余的 API 调用
- **每日速率限制**:通过可配置的请求限制控制 API 成本
- **多个提供商**:支持 OpenRouter(免费选项)和 OpenAI
- **优雅降级**:在禁用或达到限制时回退到标准蜜罐
- **缓存提供**:即使 AI 被禁用,也会提供之前生成的页面
**快速设置:**```yaml
ai:
enabled: true
provider: "openrouter"
openai_base_url: "your-custom-base-url"
api_key: "your-api-key"
model: "nvidia/nemotron-3-super-120b-a12b:free"
timeout: 60
max_daily_requests: 10
```
有关详细配置和使用方法,请参阅 [AI 生成文档](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)。
你也可以通过提交 PR 来**贡献欺骗模板**,请参阅[贡献欺骗模板](https://github.com/blessedrebus/krawl/blob/main/docs/deception_pages.md#contributing-deception-templates-via-pr)。
## 在反向代理或 CDN 后运行
**NGINX、Traefik 以及 CloudFlare 等其他代理**需要转发请求头,以便 Krawl 能够看到真实 IP。有关配置示例和完整的请求头列表,请参阅[反向代理文档](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md)。
## 指标与监控
Krawl 在 `/<dashboard_secret_path>/metrics` 暴露 [Prometheus](https://prometheus.io/) 指标(默认启用),并附带一个可直接导入的 [Grafana](https://grafana.com/) 仪表盘:[`grafana-dashboard.json`](https://github.com/blessedrebus/krawl/blob/main/grafana-dashboard.json)。
有关完整的指标列表、Grafana 导入步骤以及 Prometheus / Kubernetes(`ServiceMonitor`)抓取配置,请参阅[监控文档](https://github.com/blessedrebus/krawl/blob/main/docs/monitoring.md)。
## 其他文档
| 主题 | 描述 |
|-------|-------------|
| [AI 生成](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md) | 使用 OpenRouter 或 OpenAI 配置 AI 生成的欺骗页面 |
| [欺骗页面](https://github.com/blessedrebus/krawl/blob/main/docs/deception_pages.md) | 管理、导入和导出欺骗页面;批量操作和基于日期的过滤 |
| [部署模式](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md) | 独立(SQLite)与可扩展(PostgreSQL + Redis)模式、配置和数据迁移 |
| [蜜罐](https://github.com/blessedrebus/krawl/blob/main/docs/honeypot.md) | 蜜罐页面的完整概述:虚假登录、目录列表、凭据文件、SQLi/XSS/XXE/命令注入陷阱等 |
| [仪表盘](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard.md) | 访问和浏览实时监控仪表盘 |
| [仪表盘 API](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard-api.md) | Krawl 自有的 JSON API:端点参考、身份验证、交互式 OpenAPI 文档和附件下载 |
| [外部 API](https://github.com/blessedrebus/krawl/blob/main/docs/api.md) | Krawl 调用的第三方 API,用于获取 IP 数据、信誉和地理位置信息 |
| [反向代理](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md) | 如何在 NGINX 后部署 Krawl 或使用诱饵子域名 |
| [数据库备份](https://github.com/blessedrebus/krawl/blob/main/docs/backups.md) | 启用和配置自动数据库转储任务 |
| [金丝雀令牌](https://github.com/blessedrebus/krawl/blob/main/docs/canary-token.md) | 通过 canarytokens.org 设置外部警报触发器 |
| [词表](https://github.com/blessedrebus/krawl/blob/main/docs/wordlist.md) | 自定义虚假用户名、密码和目录列表 |
| [架构](https://github.com/blessedrebus/krawl/blob/main/docs/architecture.md) | 代码库、请求管道、数据库模式和后台任务的技术概述 |
| [Cloudflare 封禁列表同步](https://github.com/blessedrebus/krawl/blob/main/docs/cloudflare_banlist.md) | 将 Krawl 中封禁的 IP 推送到 Cloudflare 账户 IP 列表,以便在 WAF 规则中使用。同步作为后台任务运行,并通过完全替换来更新列表。 |
| [防火墙导出器](https://github.com/blessedrebus/krawl/blob/main/docs/firewall-exporters.md) | 通过 REST API 以 raw、iptables 或 nftables 格式导出 IP 封禁列表 |
| [Tarpit](https://github.com/blessedrebus/krawl/blob/main/docs/tarpit.md) | 通过延迟和噪声填充的响应来拖慢并污染 AI 爬虫 |
| [指标与监控](https://github.com/blessedrebus/krawl/blob/main/docs/monitoring.md) | Prometheus 指标端点、暴露的指标参考、Grafana 仪表盘和 ServiceMonitor 抓取 |
## 贡献
欢迎贡献!请:
1. Fork 仓库
2. 创建功能分支
3. 进行修改
4. 提交拉取请求(请说明所做的更改!)
## 免责声明
> [!CAUTION]
> 这是一个欺骗/蜜罐系统。请在隔离环境中部署,并仔细监控安全事件。请负责任地使用,并遵守适用的法律法规。
## Star 历史
<img src="https://star-history.dera.page/svg?repos=BlessedRebuS/Krawl&type=Date" width="600" alt="Star History Chart" />


