 pvharmo2/gha-lab-e8902eccd3
Лаборатория исследований безопасности: воспроизведение CVE-2025-52467 (выполнение кода в workflow pull_request_target pgai / эксфильтрация GITHUB_TOKEN) — снимок timescale/pgai

Автоматизированный исследовательский артефакт — не вышестоящий проект.
Этот репозиторий — одноразовая лаборатория, созданная автоматизированным конвейером для магистерской диссертации в Université Laval по воспроизведению опубликованных уязвимостей в рабочих процессах GitHub Actions. Это точный снимок
timescale/pgaiна коммите2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14), перераспределённый под собственной лицензией этого проекта, файл которой включён без изменений в этот снимок.Вышестоящий проект не участвует, никогда не является целью, а изучаемая здесь уязвимость уже публична. Каждый секрет и переменная в этом репозитории — случайно сгенерированное фиктивное значение — никаких реальных учётных данных здесь нет. Ссылки на действия и образы раннеров закреплены на те значения, которым они соответствовали на 2025-05-14; см.
pinning.mdв выводе конвейера для каждого изменения, внесённого в снимок.Вопросы или возражения: [email protected]
Библиотека на Python, которая превращает PostgreSQL в надёжный, готовый к продакшену механизм поиска для RAG и агентных приложений.
🔄 Автоматическое создание и синхронизация векторных эмбеддингов из данных PostgreSQL и документов S3. Эмбеддинги обновляются автоматически по мере изменения данных.
🔍 Мощный векторный и семантический поиск с помощью pgvector и pgvectorscale.
🛡️ Готовность к продакшену из коробки: поддержка пакетной обработки для эффективной генерации эмбеддингов со встроенной обработкой сбоев моделей, ограничений скорости и скачков задержки.
🐘 Работает с любой базой данных PostgreSQL, включая Timescale Cloud, Amazon RDS, Supabase и другие.
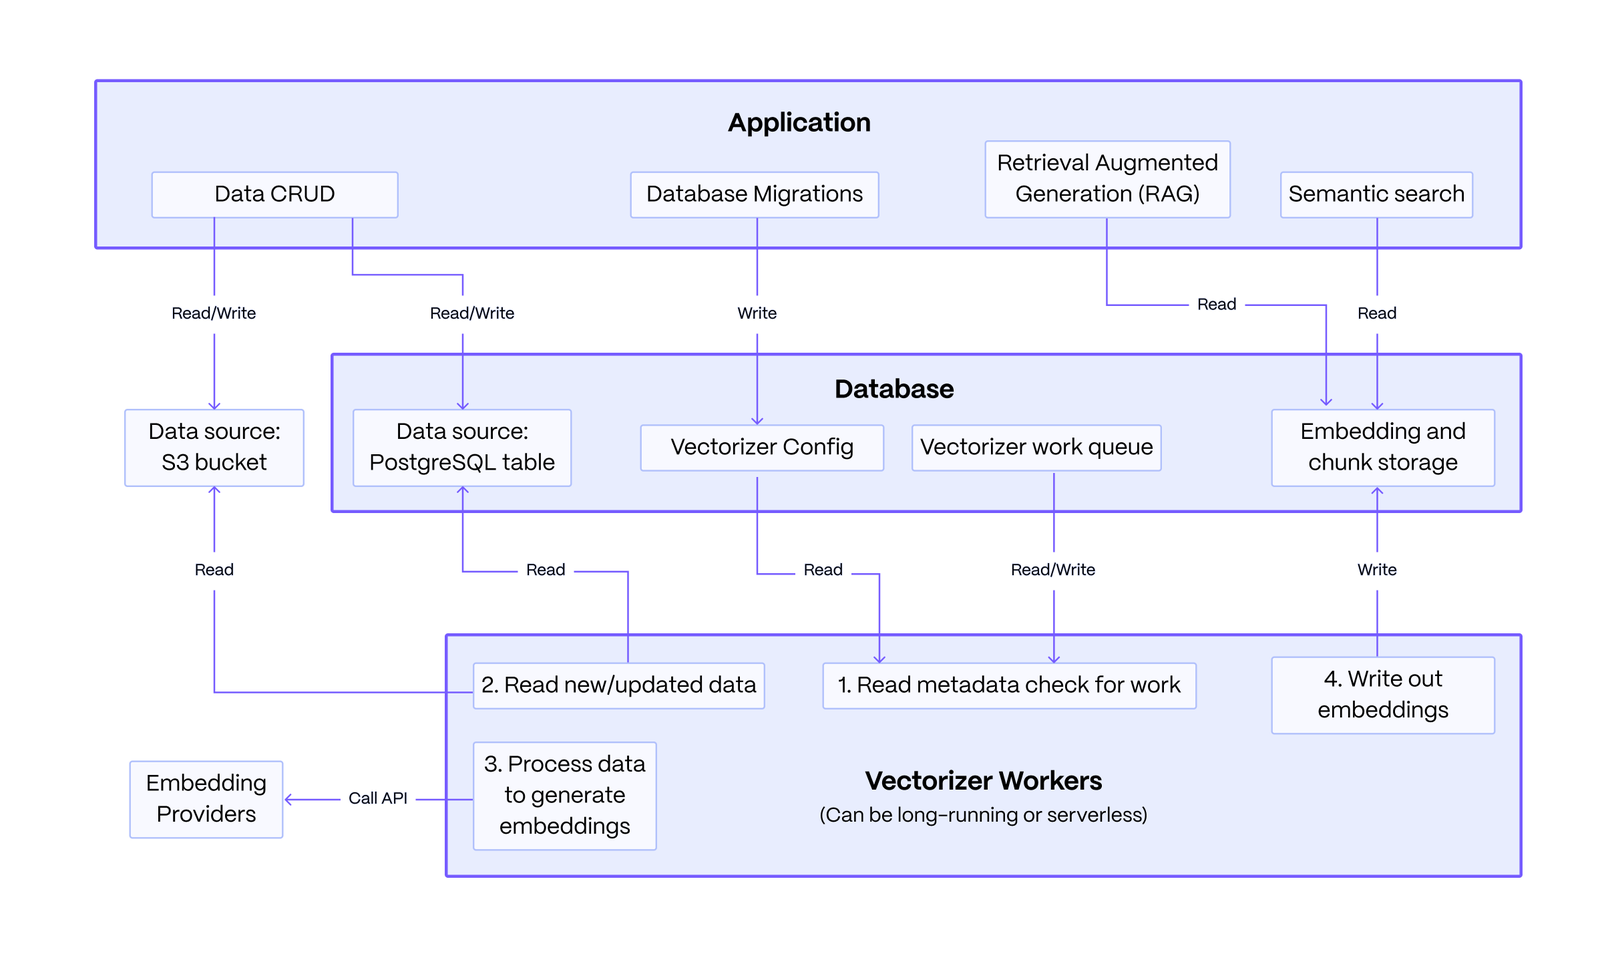
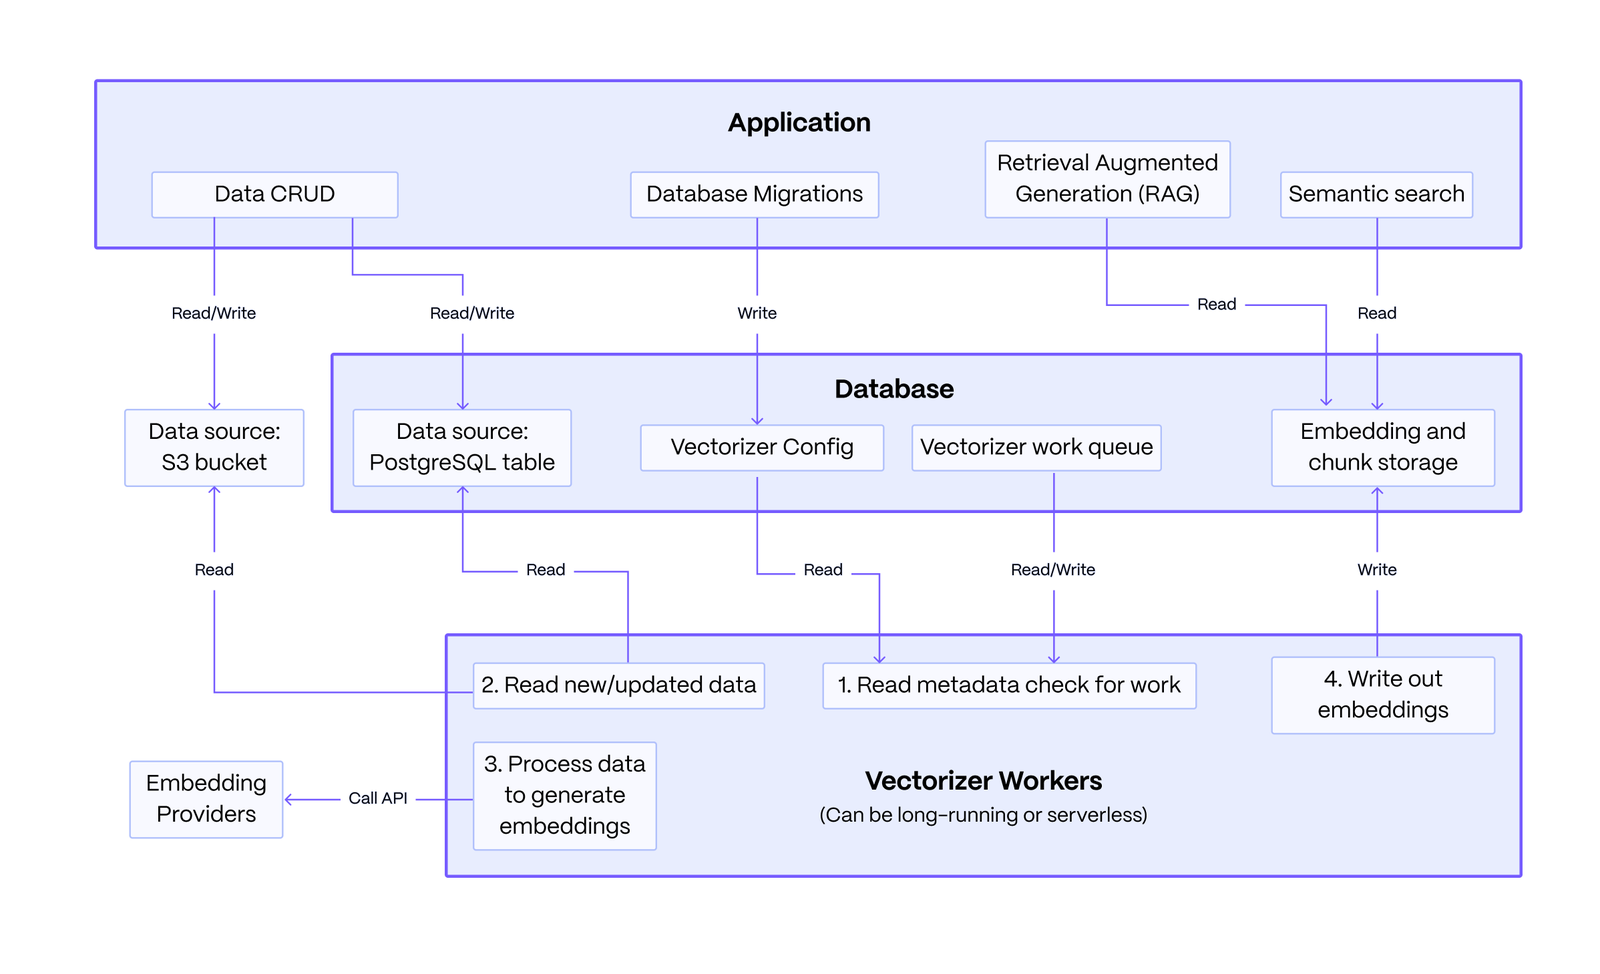
Базовая архитектура: Система состоит из приложения, которое вы пишете, базы данных PostgreSQL и векторных рабочих процессов (vectorizer workers) без сохранения состояния. Приложение определяет конфигурацию векторизатора для встраивания данных из таких источников, как PostgreSQL или S3. Рабочие процессы читают эту конфигурацию, обрабатывают очередь данных в эмбеддинги и разбитый на фрагменты текст, а затем записывают результаты обратно. После этого приложение запрашивает эти данные для обеспечения работы RAG и семантического поиска.
Ключевая сила этой архитектуры — в её устойчивости: изменения данных, вносимые приложением, отделены от процесса создания эмбеддингов, что гарантирует, что сбои в сервисе эмбеддингов не повлияют на основные операции с данными.
Сначала установите пакет pgai.``` pip install pgai
Затем установите компоненты базы данных pgai. Это можно сделать из терминала с помощью CLI или в коде вашего Python-приложения, используя Python-пакет pgai.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
Этот краткий обзор демонстрирует, как pgai Vectorizer обеспечивает семантический поиск и RAG по данным PostgreSQL, автоматически создавая и синхронизируя эмбеддинги по мере изменения данных.
Ключевой «секретный ингредиент» pgai Vectorizer — это декларативный подход к генерации эмбеддингов. Просто определите свой конвейер, и Vectorizer возьмёт на себя операционную сложность поддержания эмбеддингов в синхронизированном состоянии, даже когда эндпоинты эмбеддингов ненадёжны. Простую версию конвейера можно определить следующим образом:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
Векторизатор автоматически создаст эмбеддинги для всех строк в таблице
`wiki` и, что более важно, будет поддерживать эмбеддинги синхронизированными с
базовыми данными по мере их изменения. **Думайте об этом почти как об объявлении индекса** для
таблицы `wiki`, но вместо того, чтобы база данных управляла структурой данных индекса
за вас, эмбеддингами управляет Vectorizer.

## Запуск краткого руководства

**Предварительные требования:**
- База данных PostgreSQL ([инструкции по Docker](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- Ключ API OpenAI (в кратком руководстве мы используем openai для эмбеддинга, но вы можете использовать [несколько провайдеров](#supported-embedding-models)).

Создайте файл `.env` со следующим содержимым:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
Вы можете скачать полный python-код и requirements.txt из примера быстрого старта и запустить его в той же директории, где находится файл .env.
