 noahware/binprotect
Обфускатор x64 PE bin2bin, который не добавляет секцию в бинарный файл

См. 4. Сборка для получения инструкций по сборке.
Этот обфускатор является bin2bin-обфускатором, то есть он принимает уже скомпилированный исполняемый двоичный файл и воспроизводит его с применёнными проходами обфускации. Это можно использовать для защиты приложения без доступа к исходному коду. На данный момент поддерживаются только файлы x64 PE (portable executable), но в будущем планируется добавить поддержку других двоичных форматов (например, ELF).
В настоящее время все известные bin2bin-обфускаторы добавляют раздел в конец двоичного файла, чтобы разместить внутри него обфусцированный код или данные. Это делается для того, чтобы исходная структура двоичного файла сохранялась без необходимости изменять содержимое существующих разделов. Такой подход гораздо проще в управлении, поскольку он сохраняет действительными большинство RVA (относительных адресов).
Данный проект использует уникальный подход к bin2bin, при котором любой обфусцированный код или данные вставляются внутрь исходных разделов двоичного файла. Это требует отслеживания каждого отдельного RVA в приложении. Преимущества такого подхода:
В этом документе описаны как перезапись исполняемого двоичного файла, так и реализованные методы обфускации. Были реализованы следующие методы обфускации:
Кроме того, этот проект поддерживает исключения (исключения C++ и SEH) и может обфусцировать функции, которые содержат обработку исключений.
Для помощи в дизассемблировании и обнаружении кода в двоичном файле опционально принимаются файлы символов (как PDB, так и MAP). Предоставление файлов символов не обязательно, но помогает при дизассемблировании сложных двоичных файлов. Некоторые функции, такие как поддержка исключений и выравнивание потока управления, требуют предоставления файла символов.
Бинарный рерайтер принимает исполняемый двоичный файл и изменяет код или данные внутри него, создавая выходной двоичный файл с применёнными изменениями.
Поскольку обфусцированный код вставляется непосредственно в исходные разделы двоичного файла, необходимо отслеживать относительные адреса в программе, чтобы можно было скорректировать все ссылки на них. Это делается для того, чтобы ссылки по-прежнему указывали на те же места после вставки кода и данных. В противном случае данные или код будут считываться по неправильному адресу, что изменит поведение выходного двоичного файла и вызовет серьёзную нестабильность.
При обнаружении любой ссылки на относительный адрес (например, инструкции с rip-относительными операндами или каталоги данных PE) она добавляется в список отслеживания для обновления в конце перезаписи. Отслеживается RVA, по которому находится ссылка (чтобы знать, где обновить ссылку), а также RVA, на который она ссылается (чтобы знать, каким RVA обновить ссылку).
Когда дизассемблер находит инструкцию с rip-относительной адресацией, он добавляет её в список ссылок, которые будут обновлены в конце обфускации. Это гарантирует, что все такие инструкции по-прежнему указывают на место, которое они имели изначально. Другие случаи относительных инструкций, например таблицы переходов, также добавляются в список ссылок для обновления.
Все отслеживаемые RVA должны корректироваться при вставке или удалении любых байтов из двоичного файла. Например, вот обработчик вставки байтов:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
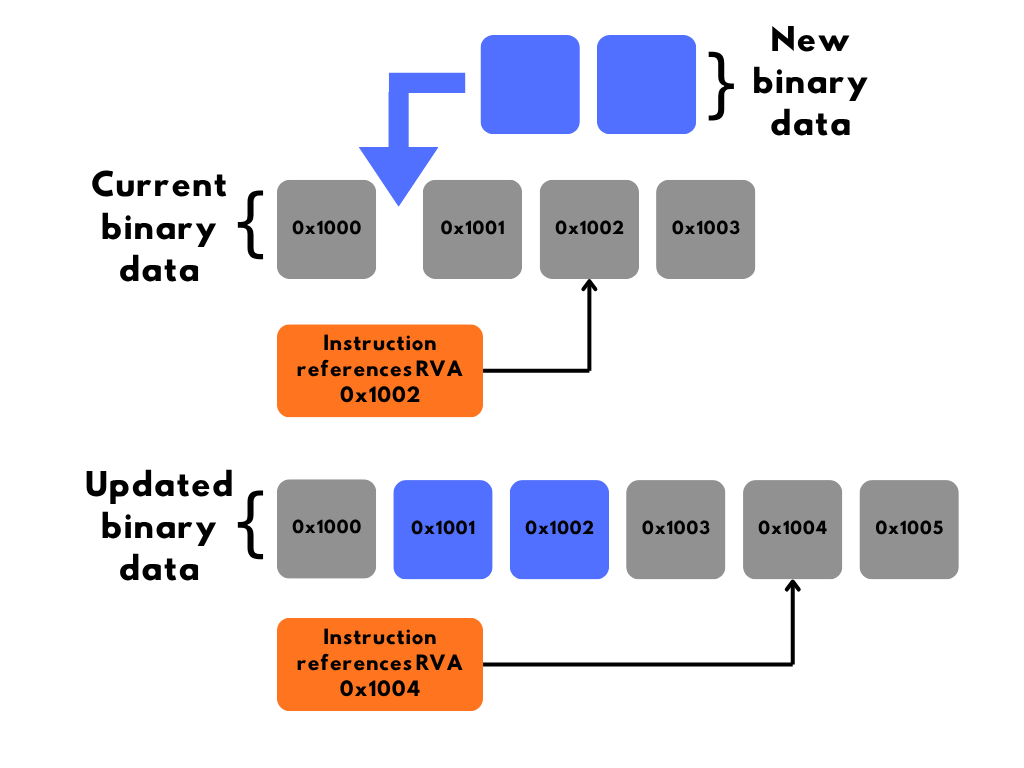
`update_rvas` — это место, где каждый отслеживаемый RVA обновляется с учётом изменений, произошедших в бинарном файле. Ниже приведена диаграмма этого процесса:
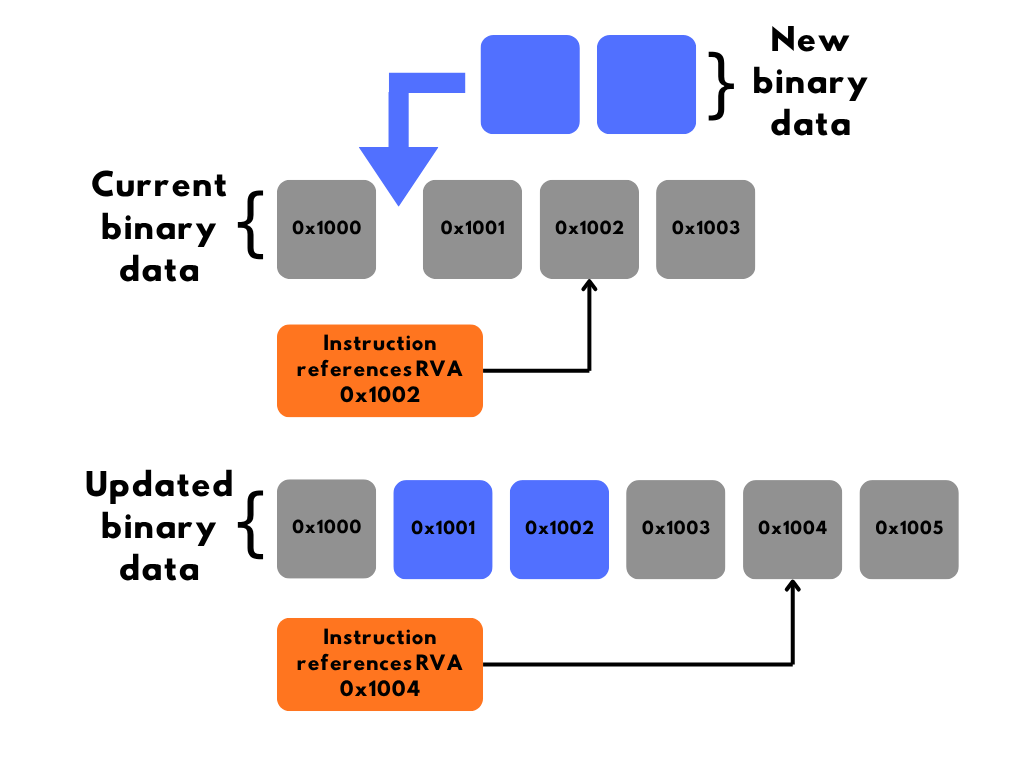
Рисунок 1. Отслеживание относительных адресов.
Вставленные данные (синие) сдвигают текущие данные (серые). Ссылочный RVA инструкции (оранжевый) обновляется так, чтобы указывать на ту же область памяти с учётом вставленных данных (синие).
## 2.2. Дизассемблирование
Все потенциальные точки входа в код (экспортируемые функции, точка входа, релокации, указывающие на сегмент кода, и т.д.) добавляются в очередь дизассемблирования. Если присутствует файл символов, все функции, описанные в нём, также добавляются в очередь дизассемблирования. Каждая запись очереди рассматривается как отдельный базовый блок.
Базовый блок — это группа инструкций без ветвлений; это означает, что он завершается на инструкциях управления потоком (например, jump, ret, int). Базовые блоки не завершаются на вызовах, так как в большинстве случаев ожидается возврат из них. Некоторые функции не возвращают управление (например, _CxxThrowException) и далее будут называться 'noreturn'-вызовами.
Когда обрабатывается базовый блок из очереди дизассемблирования, каждая инструкция дизассемблируется начиная с начала, пока не произойдёт одно из следующих событий:
- Достигнут другой уже проанализированный базовый блок, что приводит к перекрытию. См. «Разбиение базовых блоков».
- Найдена завершающая инструкция (jump, return, int).
- Дизассемблирование инструкции завершилось ошибкой.
- Обнаружено заполнение кода.
Ниже приведена диаграмма процесса дизассемблирования и постановки в очередь дизассемблирования (проверка заполнения кода на диаграмме опущена). Этот процесс повторяется до тех пор, пока очередь дизассемблирования не опустеет.
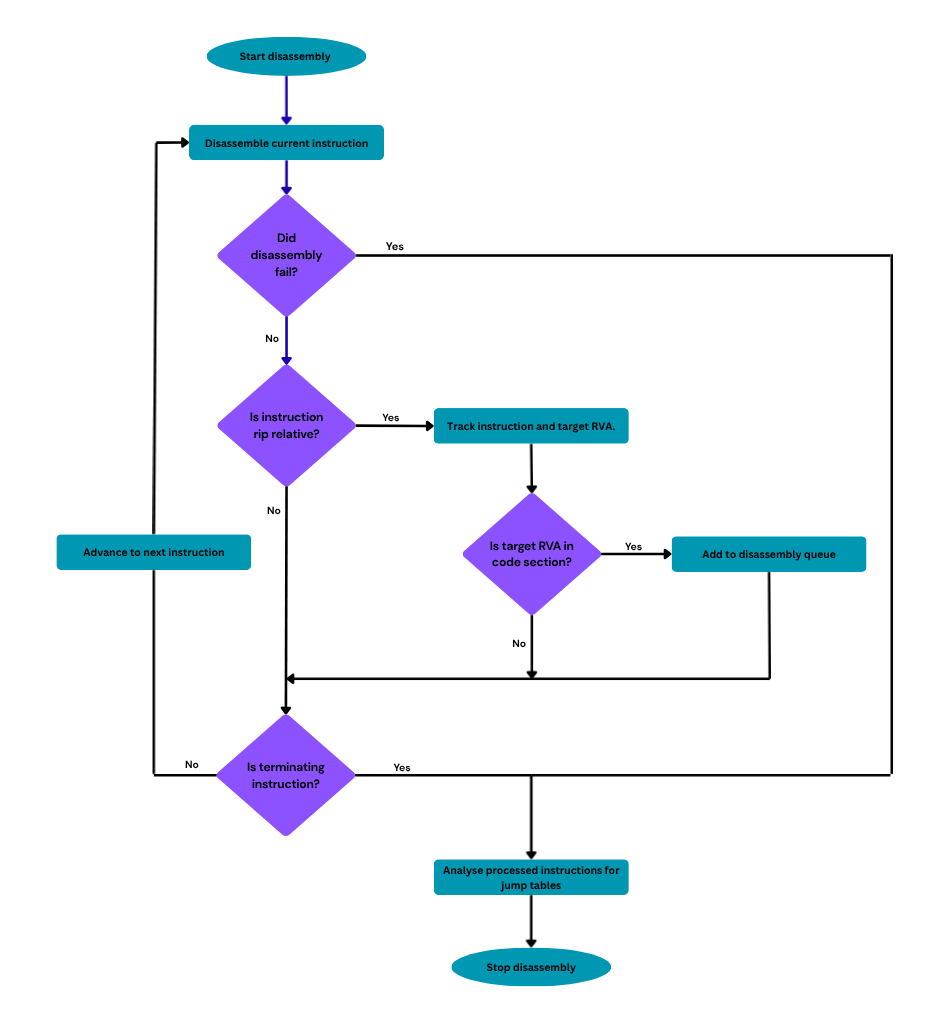
Рисунок 2. Обработка дизассемблирования.
### 2.2.1 Разбиение базовых блоков
