 comerc/cve-2025-68664
Подробное раскрытие CVE-2025-68664, критической уязвимости десериализации в ядре LangChain, позволяющей осуществлять эксфильтрацию секретов и потенциальное RCE через специально созданные промпты и потоки сериализации.

Автор: Ярден Порат
Исследование Cyata: Уязвимость LangGrinch в LangChain
Опубликовано: https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
Вчера LangChain опубликовал критическое предупреждение об уязвимости, которую я обнаружил в langchain-core: CVE-2025-68664 / GHSA-c67j-w6g6-q2cm.
Ранее в этом году мои исследования были сосредоточены на взломе менеджеров секретов в нашей работе "Vault Fault" – систем, которые специально разработаны как граница безопасности вокруг ваших наиболее чувствительных учетных данных. Один вывод повторялся снова и снова: когда платформа случайно обрабатывает данные, сформированные атакующим, как доверенную структуру, эта граница рушится быстро. На этот раз система, которая "ломается", – это не ваш менеджер секретов. Это фреймворк агентов, который может их использовать.
Почему эта уязвимость заслуживает особого внимания:
Она в ядре. Это не ошибка конкретного инструмента, не крайний случай интеграции и не "какой-то пакет сообщества сделал что-то странное." Уязвимые API (dumps() / dumpd()) находятся в самом langchain-core.
Радиус поражения огромен. По объему загрузок langchain является одним из наиболее широко развернутых компонентов фреймворка ИИ во всем мире сегодня. По состоянию на конец декабря 2025 года, публичная телеметрия пакетов показывает сотни миллионов установок, с pepy.tech сообщающим о ~847 млн общих загрузок и pypistats показывающим ~98 млн загрузок за последний месяц.
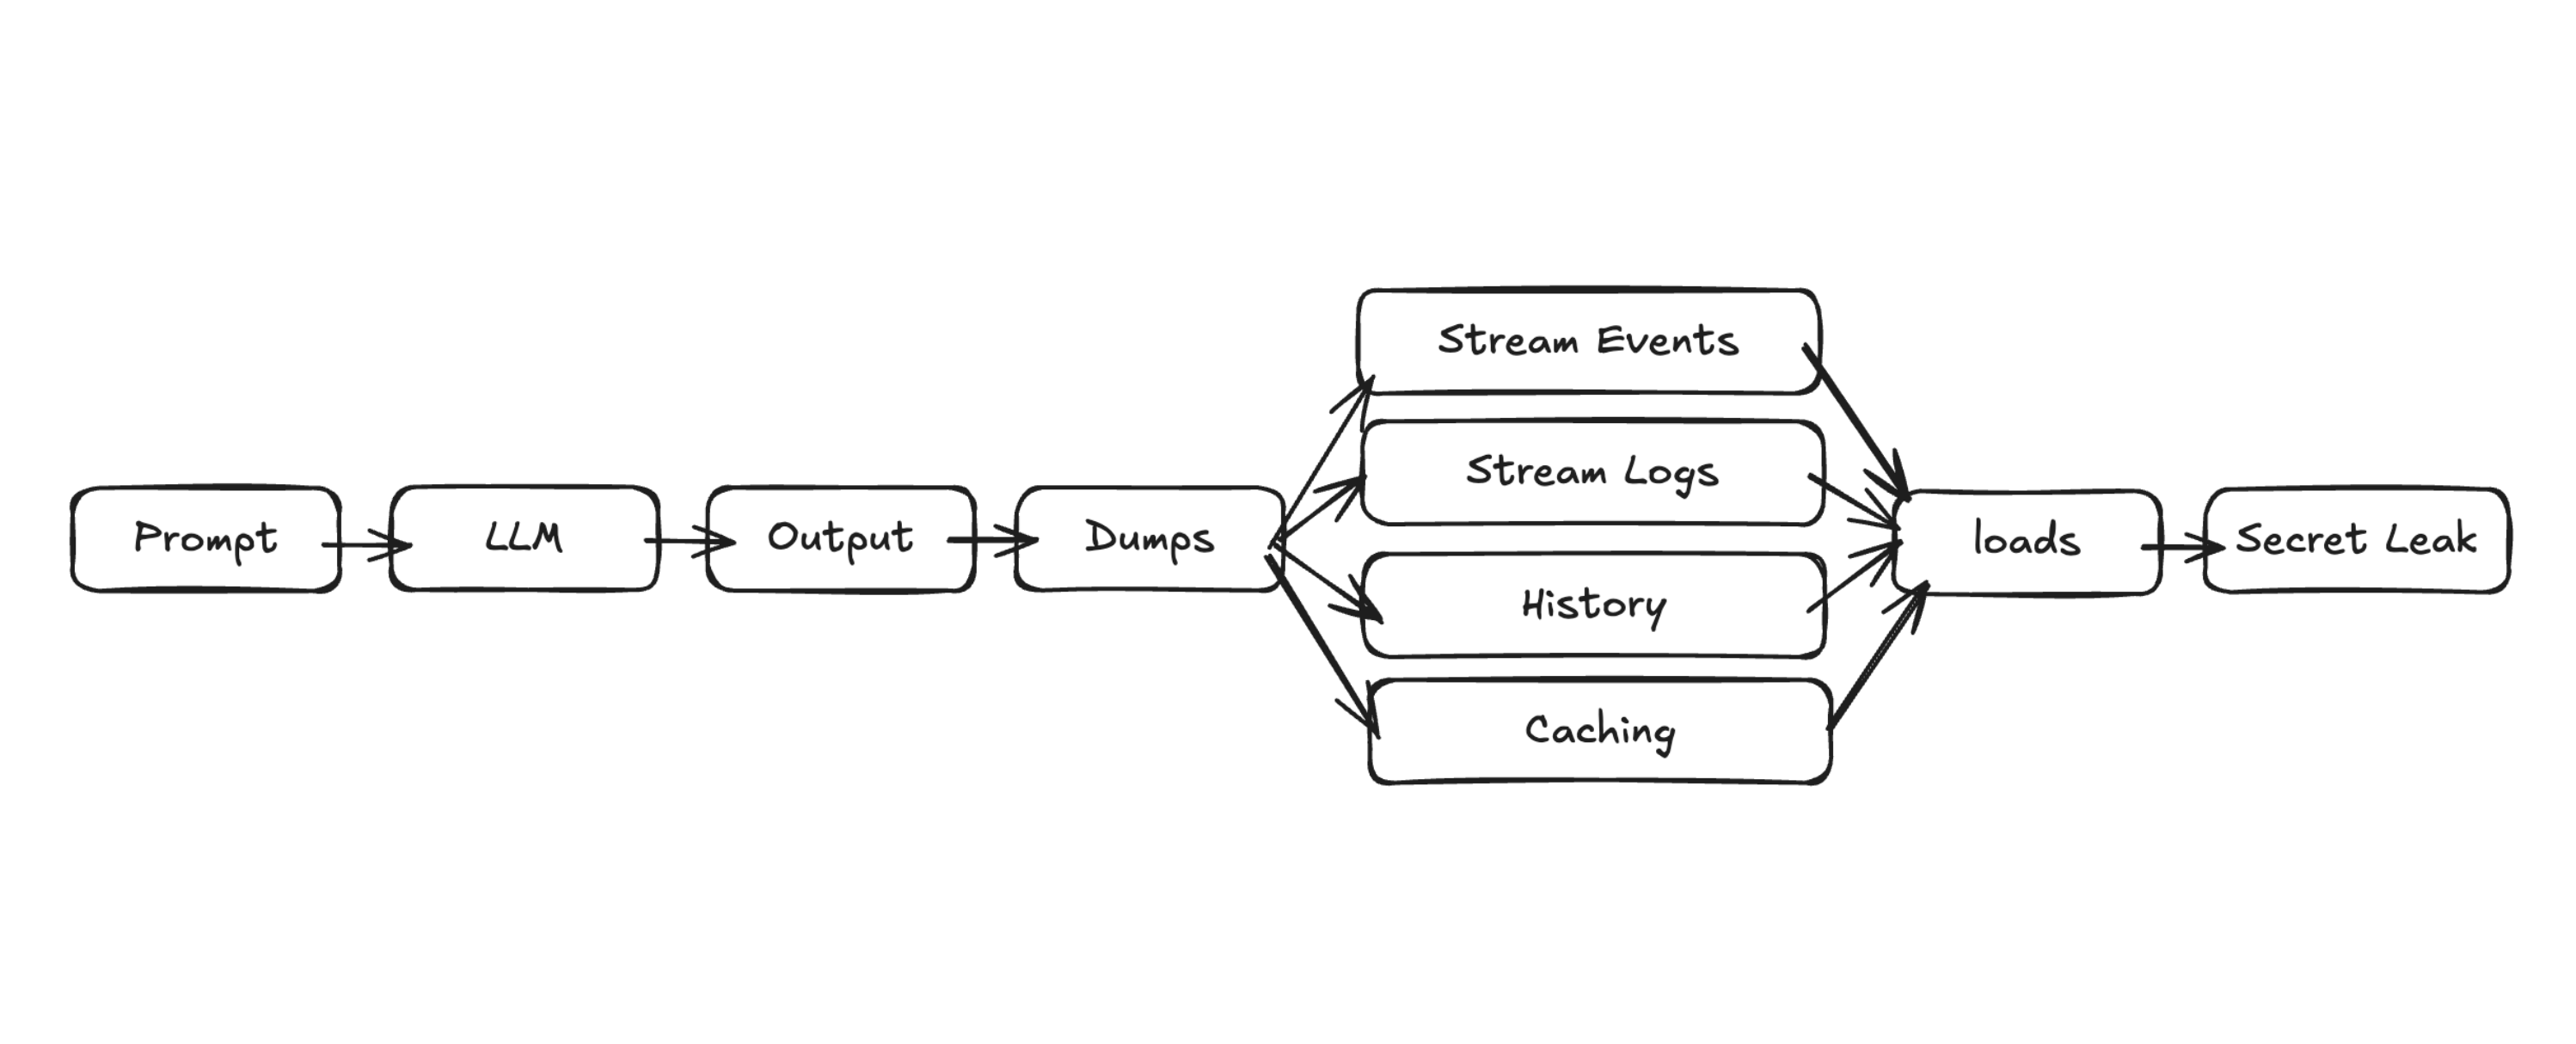
Один промпт может запустить много механизмов. Самый распространенный реальный путь здесь – это не "атакующий отправляет вам сериализованный блоб и вы вызываете load()." Это тоньше: выходы LLM могут влиять на поля вроде additional_kwargs или response_metadata, и эти поля могут быть сериализованы и позже десериализованы через обычные функции фреймворка, такие как потоковые логи/события. Простыми словами, это означает, что эксплойт может быть запущен одним текстовым промптом, который каскадируется в неожиданно сложный внутренний конвейер.
Прежде чем вы продолжите читать, патчи уже выпущены в версиях 1.2.5 и 0.3.81. Если вы используете LangChain в продакшене, это сложнее, чем может показаться; пожалуйста, обновитесь как можно скорее.
LangChain использует специальный внутренний формат сериализации, где словари, содержащие маркер 'lc', представляют объекты LangChain. Уязвимость заключалась в том, что dumps() и dumpd() не правильно экранировали контролируемые пользователем словари, которые случайно включали зарезервированный ключ 'lc'.
Таким образом, как только атакующий сможет заставить цикл оркестрации LangChain сериализовать и позже десериализовать контент, включая ключ 'lc', он сможет инстанцировать небезопасный произвольный объект, потенциально запуская множество путей, дружественных атакующим.
Предупреждение перечисляет 12 различных уязвимых потоков, которые крайне распространены в реальных случаях использования, таких как стандартная потоковая передача событий, логирование, история сообщений/память или кэши:
Самые разрушительные последствия включают:
Извлечение секретов из переменных окружения. Предупреждение отмечает, что это происходит при десериализации с secrets_from_env=True. Примечательно, что это было по умолчанию до вчерашнего дня. 🙂
Инстанциацию объектов в предварительно одобренных пространствах имен (включая langchain_core, langchain_openai, langchain_aws, langchain_anthropic…), потенциально вызывающую побочные эффекты в конструкторах (сетевые вызовы, операции с файлами и т.д.).
При определенных условиях инстанциация объектов LangChain может привести к произвольному выполнению кода.
Это классифицируется под CWE-502: Десериализация недоверенных данных, с оценкой CVSS CNA 9.3 (Критическая).
Накануне Рождества я занимался самой не праздничной работой: смотрел на код сериализации и спрашивал "подождите… почему это считается доверенным?"
Исследования безопасности часто выглядят драматично снаружи. В реальности это обычно тщательное чтение, небольшие гипотезы и медленное накопление моментов "это странно".
Это началось так, как многие в Cyata: с простого вопроса, который мы постоянно задаем при оценке стеков ИИ на реальный риск:
Где находятся границы доверия в приложениях ИИ, и действительно ли разработчики знают, где эти границы находятся?
LangChain – это мощный фреймворк, и как большинство современных фреймворков, он должен перемещать сложные структурированные данные: сообщения, вызовы инструментов, потоковые события, трассировки, кэши и "запускаемые".
Просматривая предыдущие исследования, там уже было обширное исследование инструментов LangChain и интеграций, но очень мало находок в основной библиотеке.
Я начал исследование с работы в обратном направлении. Нахождение интересных мест (приемников), затем выяснение, как атакующий может их достичь. Десериализация была очевидной целью.
Мне потребовалось довольно много времени, чтобы найти что-то значимое. Но через некоторое время я нашел, что, предполагая контролируемый атакующим примитив десериализации, я мог запустить слепой SSRF, который мог быть использован для эксфильтрации переменных окружения (будет подробно описано скоро). Поскольку результат был ограничен эксфильтрацией секретов, а не моей основной целью RCE, я продолжал аудитировать десериализацию и взял свое время.
Баг не был кусочком плохого кода, это было отсутствие кода. dumps() просто не экранировал контролируемые пользователем словари, содержащие ключи 'lc'. Отсутствующее экранирование в пути сериализации, не десериализации.
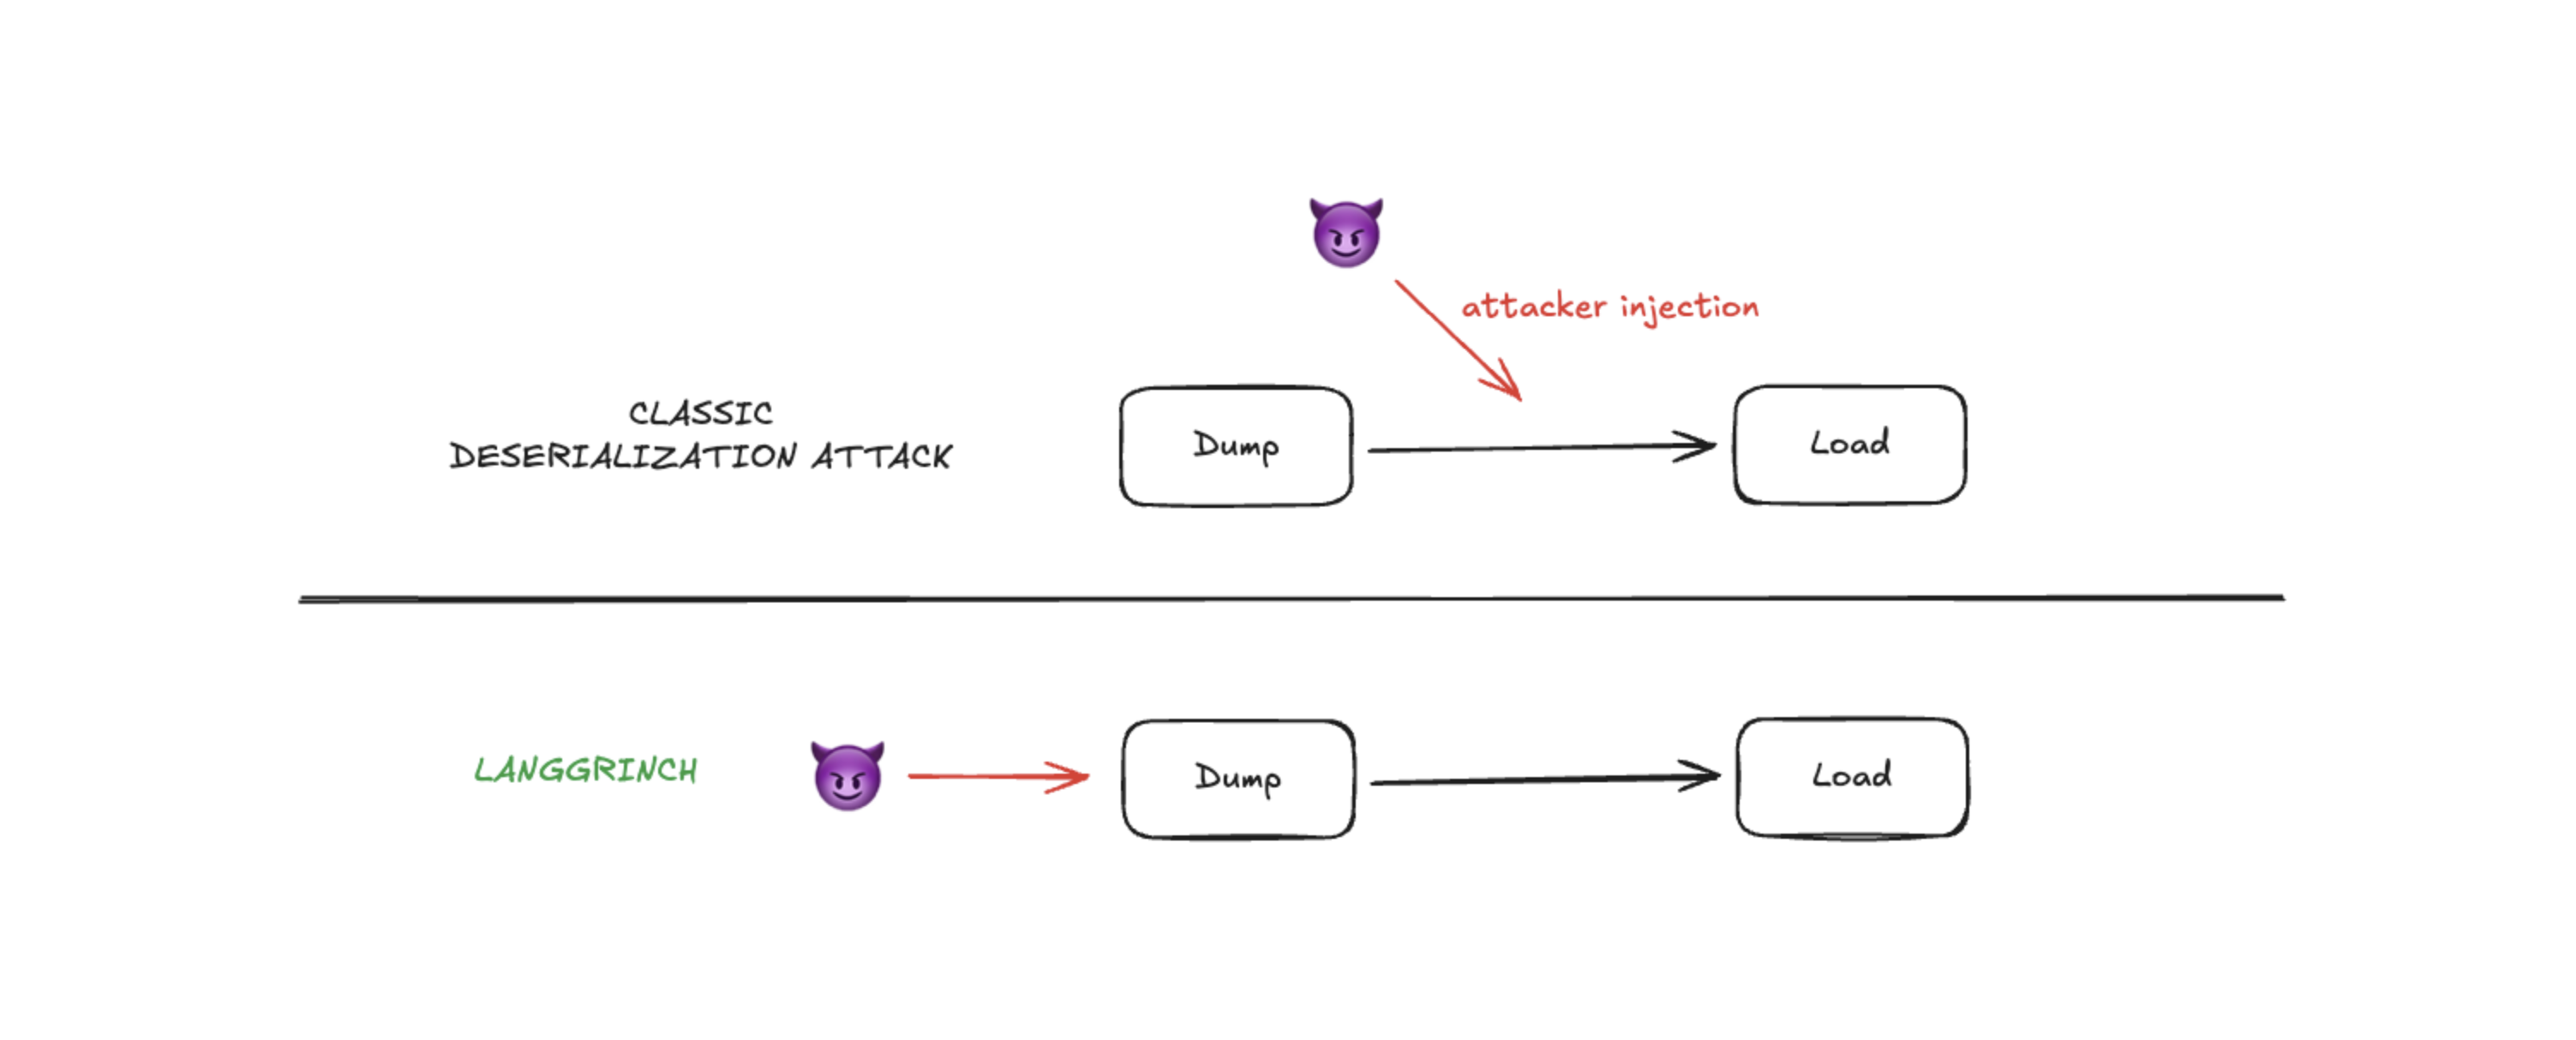
Гораздо легче заметить что-то неправильное, чем заметить отсутствие чего-то, особенно когда вы аудитируете load(), а не dumps(). В одном из наиболее тщательно проверяемых фреймворков ИИ. Два с половиной года.
Оттуда исследование стало структурированным упражнением:
Определить, где недоверенный контент (в основном произвольные словари) попадает в сериализацию (выходы LLM, инъекция промптов, ввод пользователя, внешние инструменты, извлеченные документы).
Определить, когда эти сериализованные данные десериализуются.
Определить, чего атакующий может достичь от произвольной инстанциации объектов.
На тот момент основная находка была достаточно ясной и действенной для ответственного отчета: был разрыв экранирования в dumps() / dumpd() вокруг словарей с ключом 'lc'.
Предупреждение позже захватило то, что мы часто видим на практике: поля вроде additional_kwargs и response_metadata могут быть влияемы выходом LLM и инъекцией промптов, и эти поля могут сериализоваться-десериализоваться во многих потоках.
В заслугу команде LangChain: ответ и последующие действия были решительными, не просто патчинг бага, но и ужесточение дефолтов, которые были слишком permissive для мира, в котором мы живем сейчас.
Проект LangChain решил присудить $4,000 USD вознаграждение за эту находку. Согласно huntr, платформе, где LangChain проводил свою программу вознаграждений, это была бы максимальная сумма, когда-либо присужденная в проекте, с вознаграждениями до сих пор до $125.
LangChain сериализует определенные объекты с использованием структурированного формата словаря. Ключ 'lc' используется внутренне для указания "это сериализованная структура LangChain," не просто произвольные пользовательские данные.
