Обратная разработка: декомпиляция бинарного кода с помощью больших языковых моделей
Обновления
[2025-10-04]: Выпуск SK²Decompile: двухфазная декомпиляция бинарного кода на основе LLM — от каркаса к оболочке (Skeleton to Skin). Фаза 1. Восстановление структуры (каркас/Skeleton): преобразование бинарного кода/псевдокода в обфусцированные промежуточные представления 🤗 Ссылка HF. Фаза 2. Присвоение имён идентификаторам (оболочка/Skin): генерация читаемого исходного кода с осмысленными идентификаторами 🤗 Ссылка HF.
[2025-05-20]: Выпущен набор decompile-bench, содержащий два миллиона пар «бинарный код — исходный код» функций для обучения и 70 тысяч пар функций для оценки. Подробности см. в папке decompile-bench.
[2024-10-17]: Выпущен набор decompile-ghidra-100k — подмножество из 100 тысяч обучающих примеров (по 25 тысяч на каждый уровень оптимизации). Мы предоставляем скрипт обучения, который выполняется примерно за 3.5 часа на одном GPU A100 40G. Он достигает показателя повторной выполняемости 0.26 при общей стоимости менее $20 — для быстрого воспроизведения LLM4Decompile.
[2024-09-26]: Обновлена записная книжка Colab, демонстрирующая использование модели LLM4Decompile, включая примеры для моделей LLM4Decompile-End и LLM4Decompile-Ref.
[2024-09-23]: Выпущена модель LLM4Decompile-9B-v2, дообученная на основе Yi-Coder-9B; на бенчмарке Decompile она достигла показателя повторной выполняемости 0.6494.
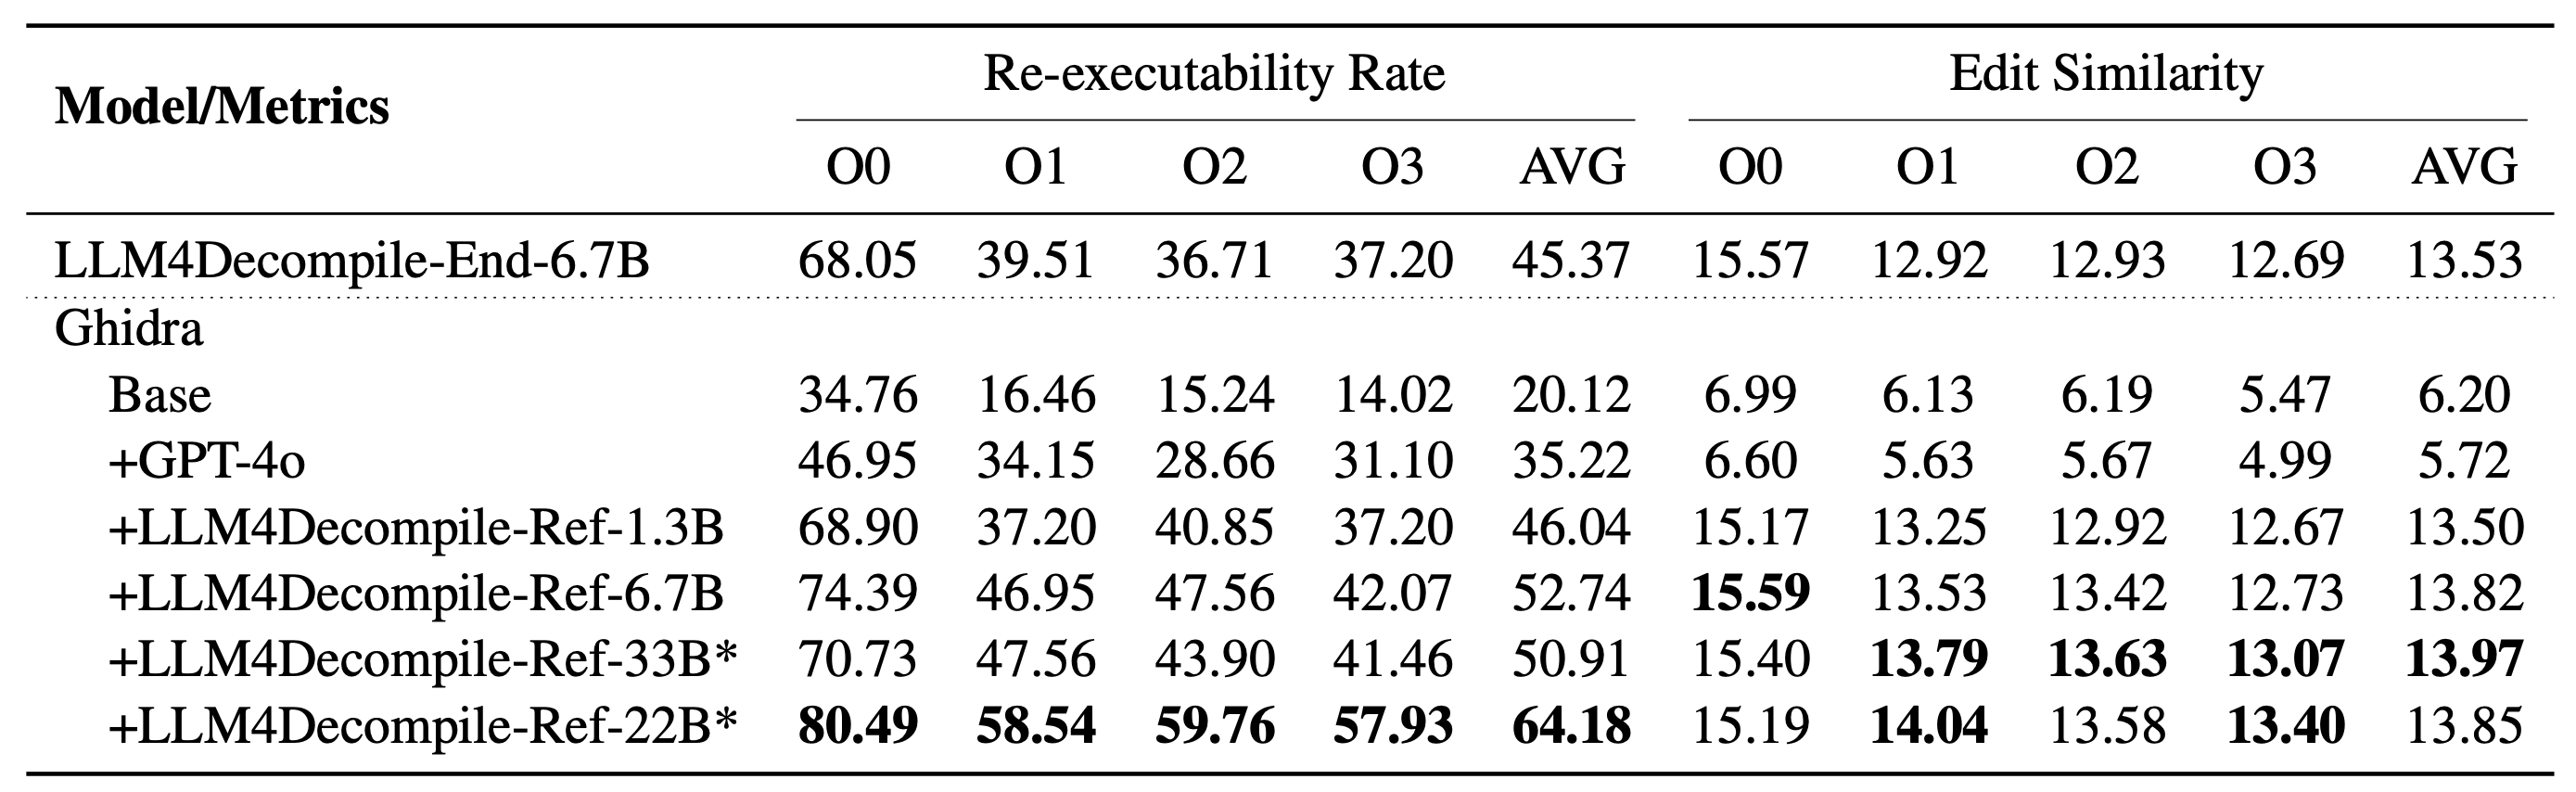
[2024-06-19]: Выпущена серия V2 (LLM4Decompile-Ref). Модели V2 (1.3B–22B), построенные на основе Ghidra, обучены на 2 миллиардах токенов для улучшения псевдокода, декомпилированного Ghidra. Версия 22B-V2 превосходит 6.7B-V1.5 ещё на 40.1%. Подробности см. в папке ghidra.
[2024-05-13]: Выпущена серия V1.5 (LLM4Decompile-End — прямое декомпилирование бинарного кода с помощью LLM). Модели V1.5 обучены на более крупном наборе данных (15B токенов) с максимальной длиной последовательности 4096 токенов и демонстрируют выдающуюся производительность (улучшение более чем на 100%) по сравнению с предыдущей моделью.
[2024-03-16]: Добавлена модель llm4decompile-6.7b-uo, обученная без предварительного знания уровней оптимизации (O0~O3); её средняя повторная выполняемость составляет около 0.219 — это лучший показатель среди наших моделей.
О проекте
LLM4Decompile — новаторская большая языковая модель с открытым исходным кодом, предназначенная для декомпиляции. Её текущая версия поддерживает декомпиляцию бинарных файлов Linux x86_64, от уровня оптимизации O0 до O3 компилятора GCC, в читаемый исходный код на C. Наша команда стремится расширять возможности этого инструмента, продолжая работу по поддержке более широкого спектра архитектур и конфигураций.
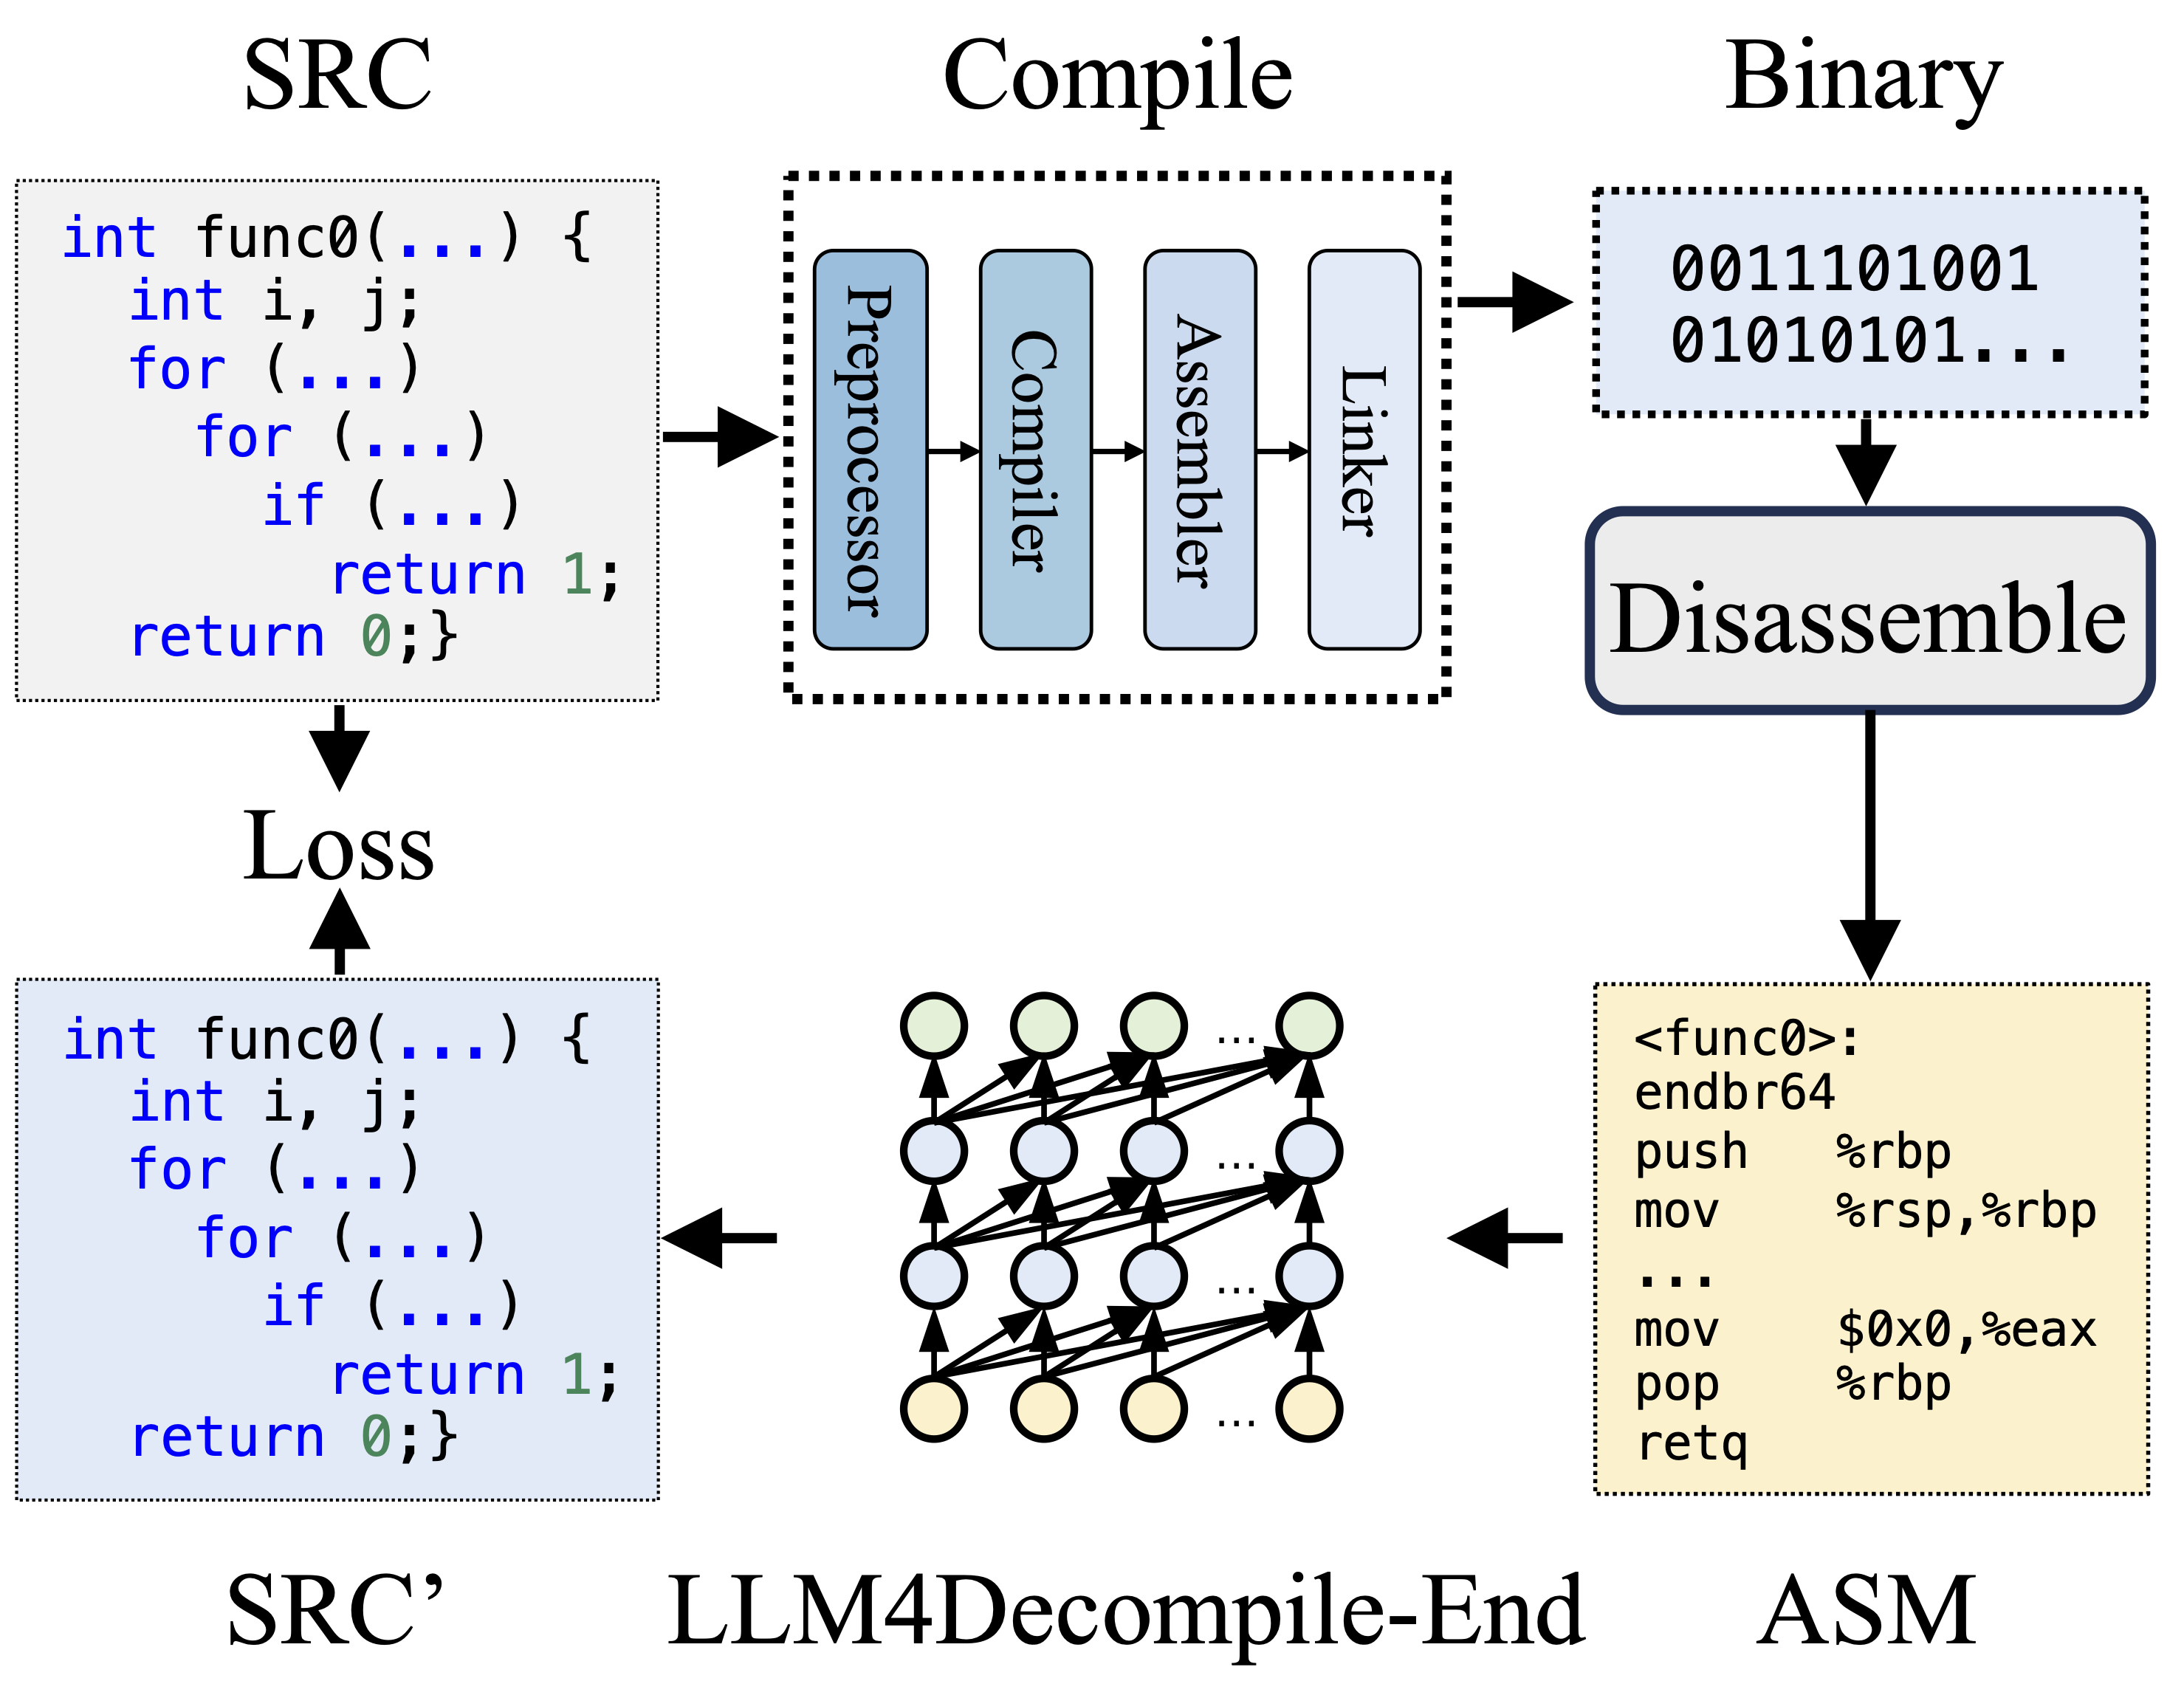
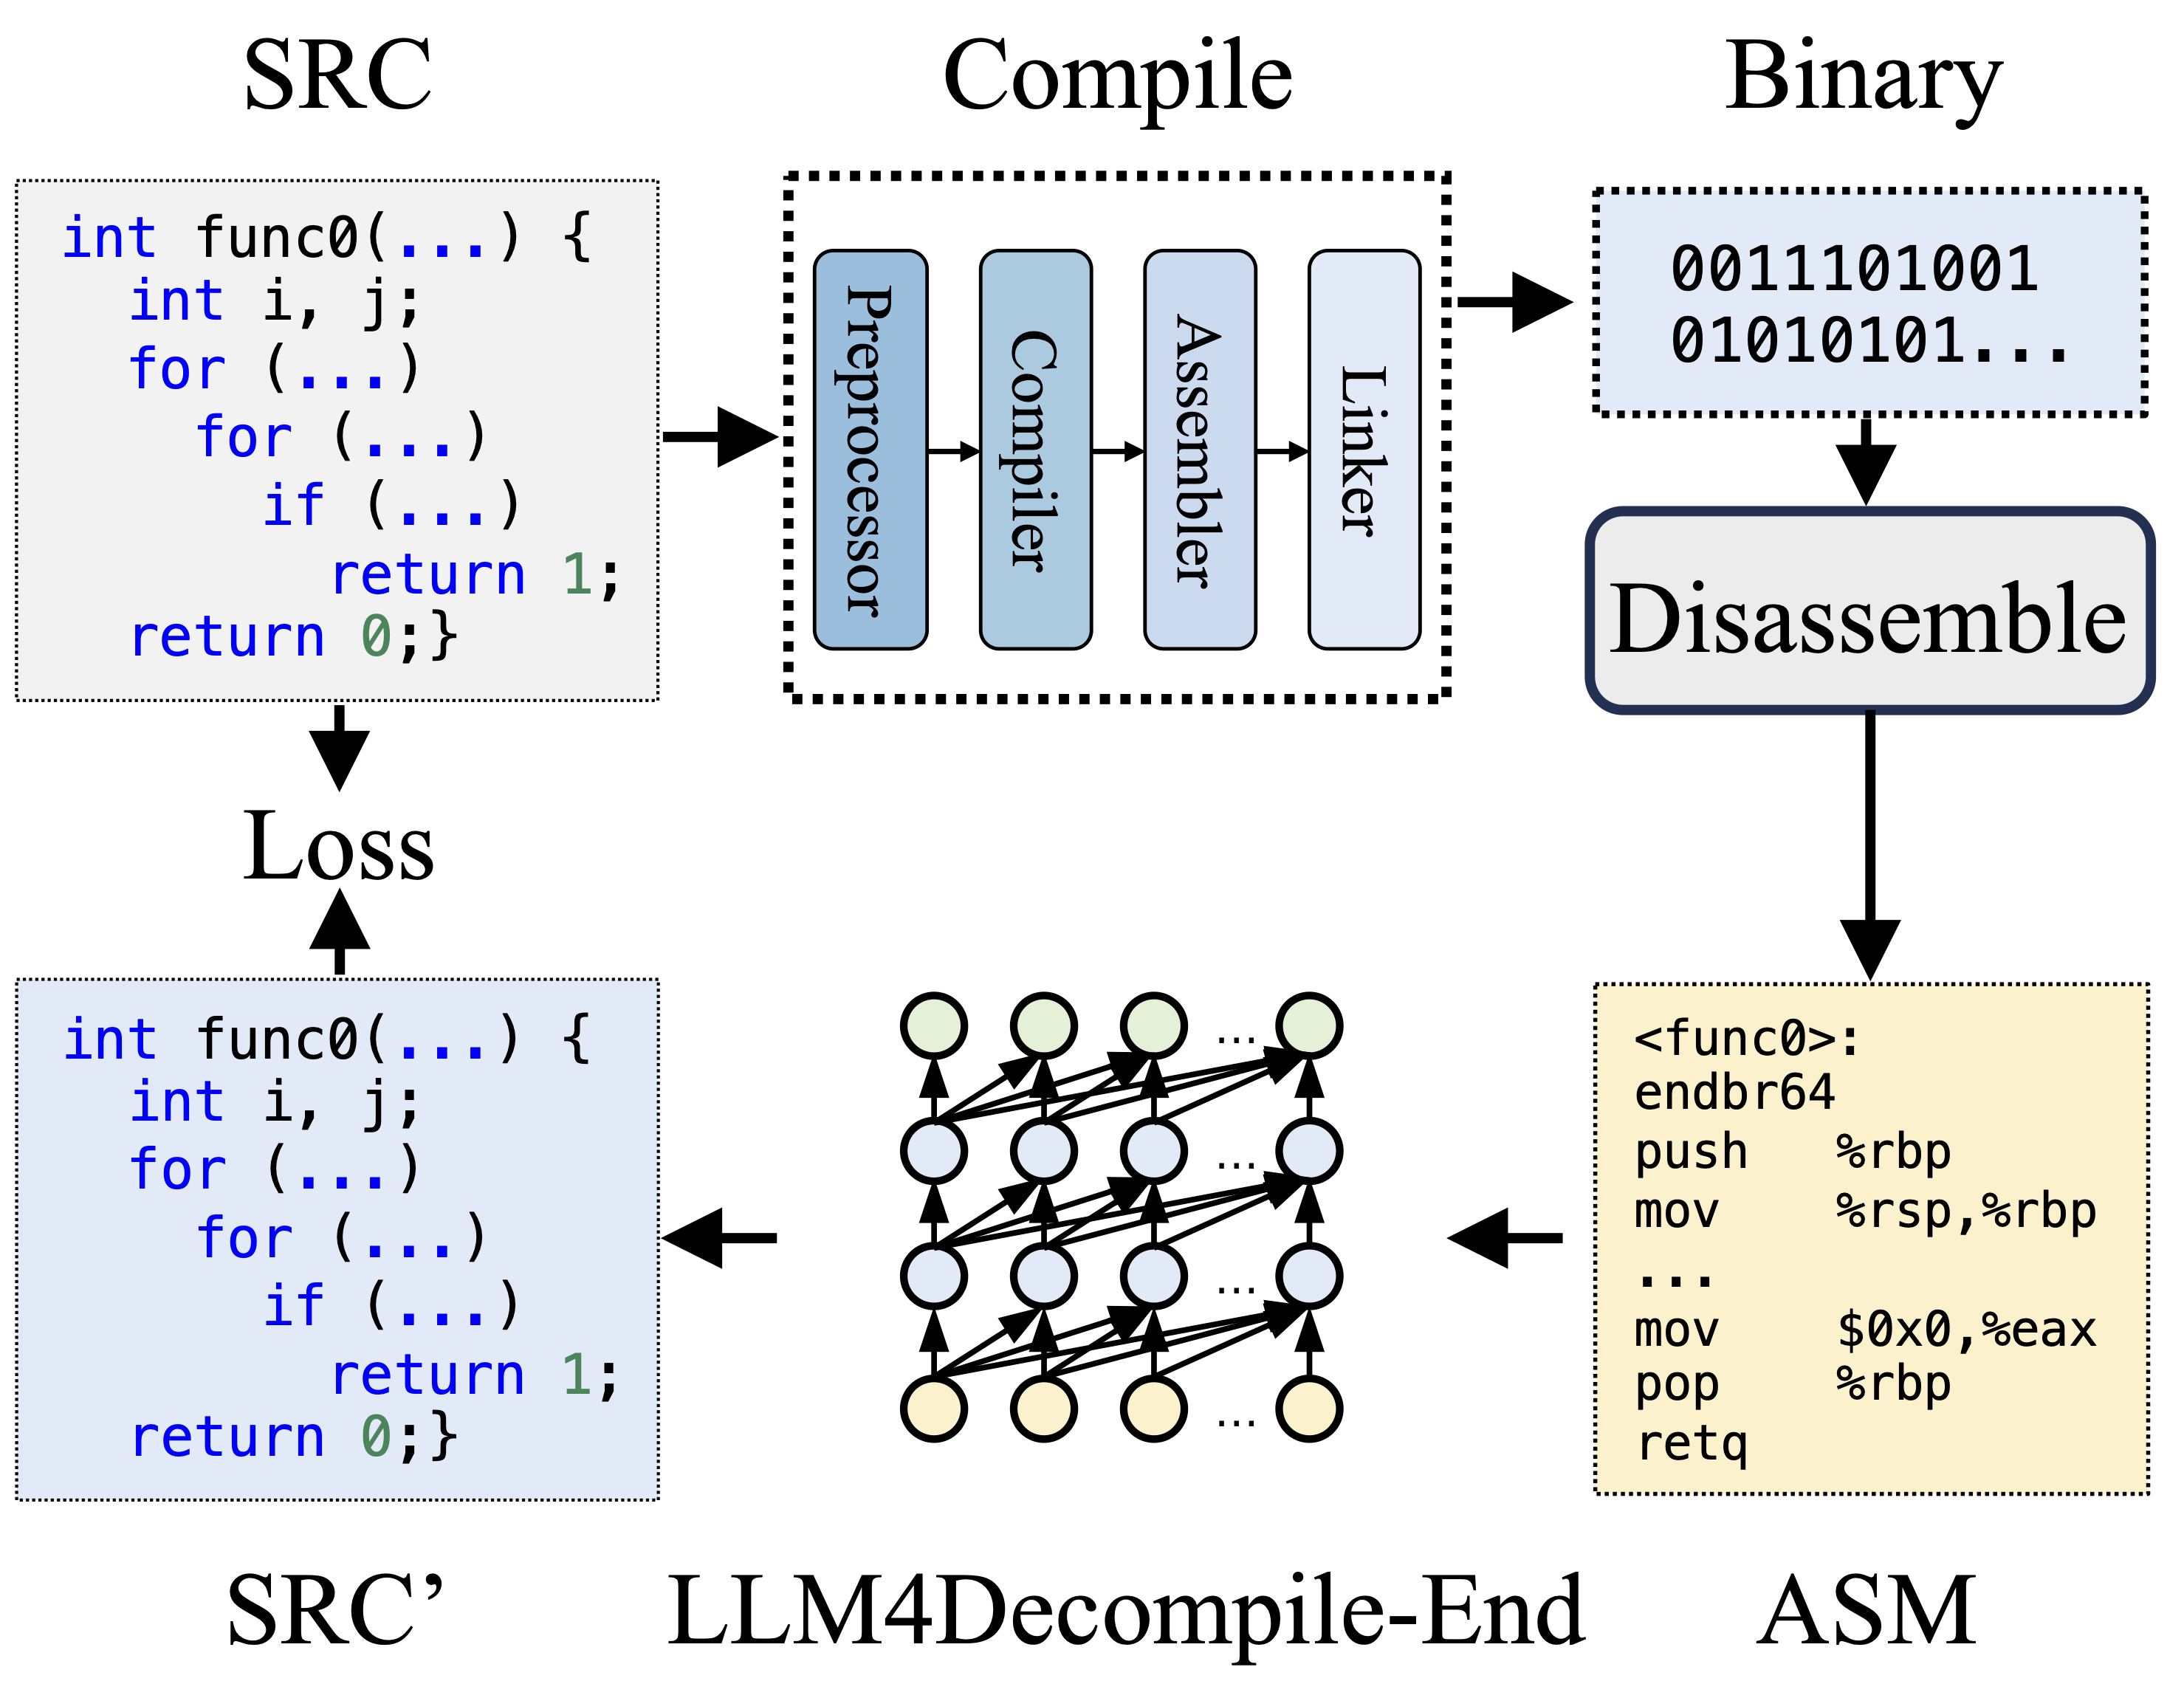
В процессе компиляции препроцессор обрабатывает исходный код (SRC), удаляя комментарии и раскрывая макросы и включаемые файлы (includes). Затем очищенный код передаётся компилятору, который преобразует его в ассемблерный код (ASM). Ассемблер превращает этот ASM в бинарный код (0 и 1). Компоновщик завершает процесс, связывая вызовы функций для создания исполняемого файла. Декомпиляция же заключается в преобразовании бинарного кода обратно в исходный файл. Поскольку LLM обучаются на тексте, они не могут напрямую обрабатывать бинарные данные. Поэтому бинарные файлы сначала должны быть дизассемблированы утилитой Objdump в ассемблерный язык (ASM). Следует отметить, что бинарный код и дизассемблированный ASM эквивалентны и могут быть преобразованы друг в друга, поэтому мы используем эти термины как взаимозаменяемые. Наконец, между декомпилированным кодом и исходным кодом вычисляется loss (функция потерь) для управления обучением. Чтобы оценить качество декомпилированного кода (SRC'), его функциональность проверяется с помощью тестовых утверждений (повторная выполняемость).
Метрики
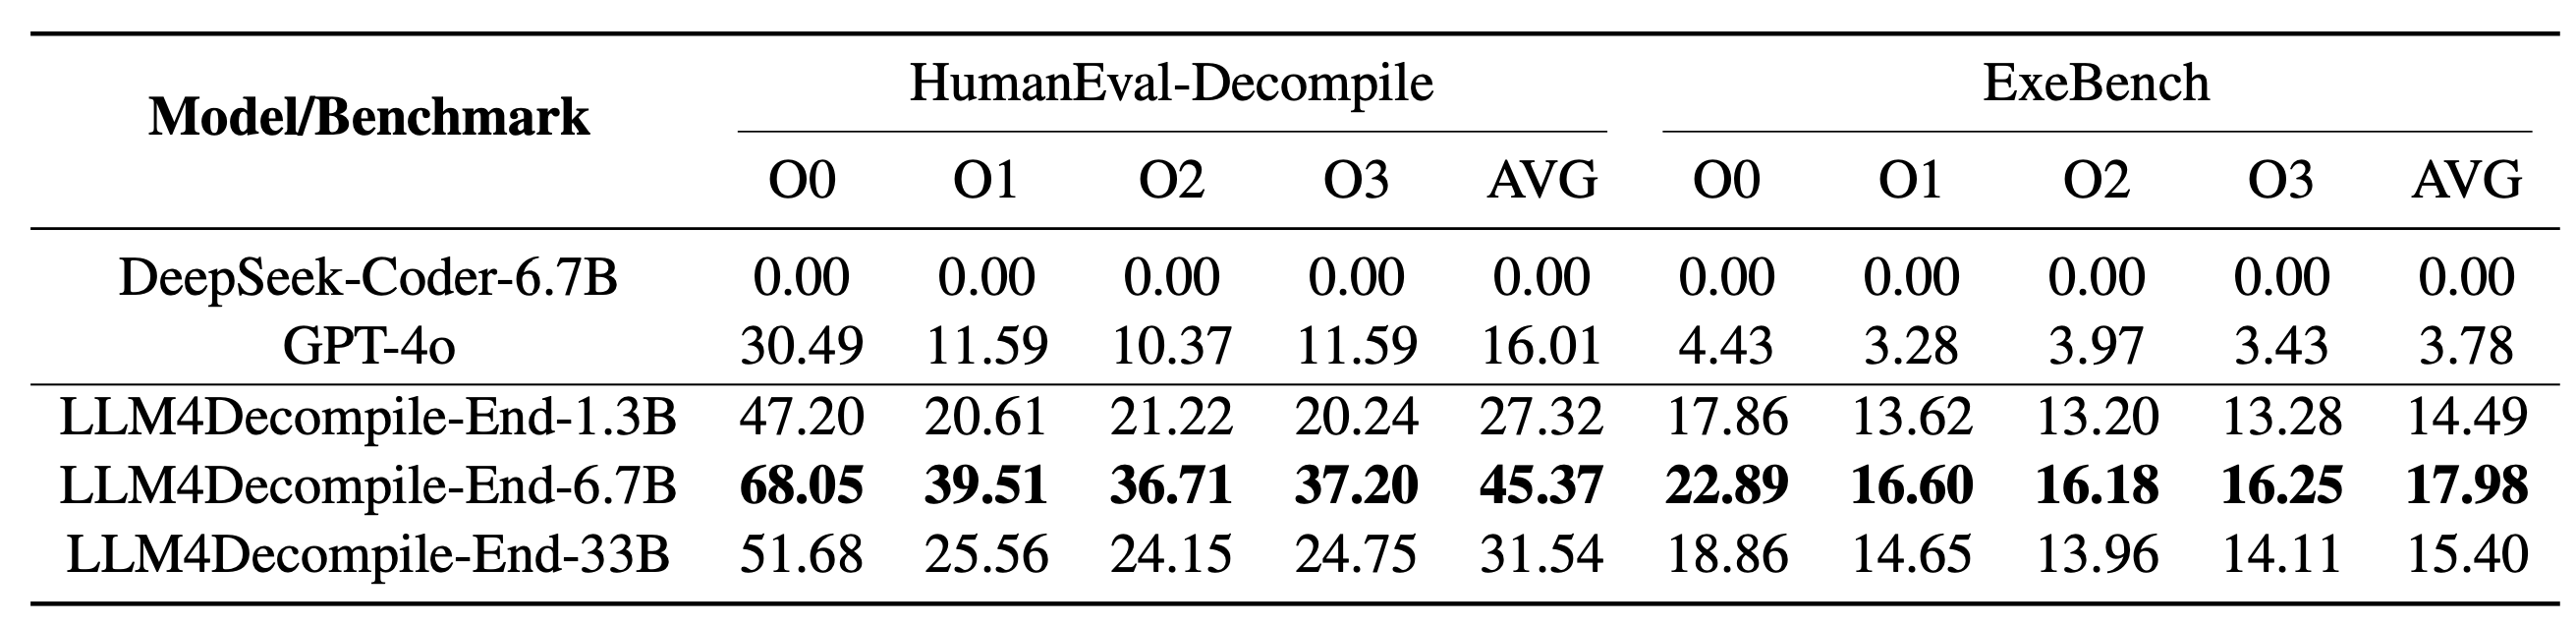
Повторная выполняемость оценивает, может ли декомпилированный код корректно выполняться и проходить все заранее заданные тестовые случаи.
Бенчмарки
HumanEval-Decompile — набор из 164 функций на C, которые используют исключительно стандартные библиотеки C.
ExeBench — набор из 2621 функций, взятых из реальных проектов, каждая из которых использует пользовательские функции, структуры и макросы.
Результаты
Модели
Наши модели LLM4Decompile представлены в размерах от 1.3 до 33 миллиардов параметров, и мы опубликовали их на Hugging Face.
 albertan017/llm4decompile