
New releaseSep 19, 2026
urx v0.11.0
Извлекает URL-адреса из архивов OSINT для аналитики безопасности
Извлекает URL-адреса из OSINT-архивов для задач безопасности.


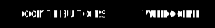

Urx — это инструмент командной строки, предназначенный для сбора URL-адресов из OSINT-архивов, таких как Wayback Machine и Common Crawl. Написанный на Rust ради эффективности, он использует асинхронную обработку для быстрого опроса нескольких источников данных. Этот инструмент упрощает процесс сбора информации об URL-адресах для указанного домена, предоставляя исчерпывающий набор данных, который можно использовать для различных целей, включая тестирование безопасности и анализ.
Возможности
- Параллельное получение URL-адресов из нескольких источников (Wayback Machine, Common Crawl, OTX, Arquivo.pt)
- Подключение любого другого CDX-индексного сервера — национальных веб-архивов, приватного pywb, OutbackCDX — с помощью
--cdx-endpoint URL, без изменения кода - По умолчанию без ключей: Wayback, Common Crawl, OTX, Arquivo.pt и URLScan (анонимно) работают без API-ключа
- Провайдер BeVigil: URL-адреса, извлечённые из распакованных Android-приложений — эндпоинты, которые не обходил ни один веб-архив
- Ротация API-ключей для каждого провайдера с ключами (VirusTotal, URLScan, ZoomEye, GitHub, BeVigil) для обхода ограничений скорости
- Аутентифицированное тестирование:
-H,--cookieи--user-agentприменяются к каждому запросу, который urx делает к цели (--check-status,--extract-links,--extract-js-endpoints,--expand-specs, а также пробыrobots/sitemap) и намеренно никогда не отправляются в архив - Фильтрация результатов по расширениям файлов, подстрокам или полным регулярным выражениям (
--match-regex/--filter-regex) - Предустановленные пресеты — как по семейству файлов ("no-images", "only-js"), так и по интересу с точки зрения безопасности ("only-secrets", "only-backup", "only-config", "only-api")
- Фильтрация на стороне архива: код статуса, MIME-тип и диапазон дат передаются прямо в CDX-запрос, поэтому отфильтрованные захваты вообще не пересекают сеть
- Клиентская фильтрация метаданных (
--meta-*): фильтрация по дате первого/последнего захвата, записанному MIME-типу и записанному статусу единообразно для каждого провайдера, после сбора - Цели с ограничением по пути:
urx example.com/shopпередаёт область прямо в CDX-запрос (url=example.com/shop*), поэтому поддерево большого сайта стоит долю от всего индекса, а не отфильтровывается на стороне клиента - Файлы области действия баг-баунти (
--scope-file): собственный список программы вида*.example.com/!admin.example.com, используемый дословно, повторяемый и объединяемый, при этом исключения всегда побеждают - Нормализация и дедупликация URL-адресов: сортировка параметров запроса, удаление завершающих слэшей, объединение семантически идентичных URL-адресов и схлопывание почти-дубликатов, отличающихся только идентификаторами, хешами или датами (
--dedup-similar) - Поддержка нескольких форматов вывода: обычный текст, JSON, JSON Lines, CSV и
wordlist— сегменты пути и имена параметров, из которых построена цель, без идентификаторов, хешей и дат - Представления параметров и фаззинга:
--params(полная инвентаризация параметров цели),--params-by-endpoint(какой эндпоинт принимает что) и--fuzz-placeholder FUZZ(один шаблонный URL на каждую сигнатуру параметра, готовый для ffuf или dalfox) - Метаданные архивных захватов:
first_seen,last_seen,mime,archive_statusиdigestвозвращаются с каждым URL-адресом, о котором сообщил CDX-архив, без дополнительных сетевых затрат - Потоковый вывод (
--stream): URL-адреса записываются по мере их сообщения каждым провайдером, поэтому конвейер начинает работать немедленно, а не ждёт самый медленный архив - Поддержка прямого ввода из файлов: чтение URL-адресов напрямую из WARC-файлов, сжатых файлов URLTeam и текстовых файлов
- Вывод результатов в консоль или файл, либо потоковая передача через stdin для интеграции в конвейер
- Тестирование URL-адресов:
- Фильтрация и проверка URL-адресов на основе кодов статуса HTTP и шаблонов.
- Извлечение дополнительных ссылок из собранных URL-адресов — якорей, скриптов, таблиц стилей, действий форм, iframe, изображений, медиаисточников, объектов, встраиваний и целей meta-refresh
- Извлечение из архивных тел ответов собранных URL-адресов (
--archive-body), поэтому страницы, которых больше не существует, всё равно отдают содержавшиеся в них ссылки — один запрос на каждое уникальное тело благодаря дедупликации по CDX-дайджесту - С
--extract-js-endpointsизвлекайте также из архивного JavaScript: бандл, названный по хешу сборки, отдаёт 404 сразу после переразвёртывания сайта, и архив — единственное место, где его API-поверхность всё ещё существует - Сохраняйте воспроизведённые тела (
--archive-body-dir) как корпус для поиска того, что не ищет ни один извлекатель ссылок — комментариев разработчиков, встроенных учётных данных, внутренних имён хостов — без дополнительных запросов - Разворачивание спецификаций API (
--expand-specs): документы OpenAPI 3.x, Swagger 2.0 и GraphQL introspection, в формате JSON или YAML, превращаются в каждый описанный ими маршрут — один запрос даёт всю документированную поверхность - Метаданные ответа:
--check-statusтакже записываетLocation,Content-LengthиContent-Type, а--check-titleдобавляет HTML-тег<title>
- Обнаружение архивных robots.txt и sitemap.xml (
--archived-discovery): каждая отдельная версия, которую хранит Wayback Machine, поэтомуDisallow:от 2015 года всё ещё называет пути, о которых сайт с тех пор перестал упоминать - Кэширование и инкрементальное сканирование:
- Локальное кэширование в SQLite или удалённое в Redis, чтобы избежать повторного сканирования доменов (Redis требует сборки с
--features redis-cache; в готовых сборках он отсутствует) - Инкрементальный режим для обнаружения только новых URL-адресов с момента последнего сканирования
- Настраиваемый TTL кэша; каждое сканирование удаляет записи старше двойного TTL, а
urx cache pruneудаляет всё, что выходит за его пределы - Подкоманда
urx cacheдля просмотра и обслуживания кэша:stats,list,prune,drop <domain>,clear
- Локальное кэширование в SQLite или удалённое в Redis, чтобы избежать повторного сканирования доменов (Redis требует сборки с
Установка
Из Cargo
# https://crates.io/crates/urx
cargo install urx
Из Homebrew
# https://formulae.brew.sh/formula/urx
brew install urx
Из исходного кода
git clone https://github.com/hahwul/urx.git
cd urx
cargo build --release
Скомпилированный бинарный файл будет доступен по пути target/release/urx.