bbot v3.0.0
Рекурсивный интернет-сканер для хакеров. 🧡




BEE·bot — это многоцелевой сканер, вдохновлённый Spiderfoot, созданный для автоматизации вашего Recon (разведки), Bug Bounties (баг-баунти) и ASM (управления поверхностью атаки)!
https://github.com/blacklanternsecurity/bbot/assets/20261699/e539e89b-92ea-46fa-b893-9cde94eebf81
Скан BBOT в реальном времени - визуализация с помощью VivaGraphJS
Установка
# stable version
pipx install bbot

# bleeding edge (dev branch)
pipx install --pip-args '\--pre' bbot
Другие способы установки, включая Docker, см. в разделе Начало работы
Обновляетесь с 2.x? BBOT 3.0 содержит критические изменения в CLI, пресетах, модулях, событиях и Python API. Перед обновлением ознакомьтесь с руководством по миграции 2.x → 3.0 (исходник).
Совет по скорости: DNS-резолвер BBOT (blastdns) запускает несколько потоков на каждый резолвер из
/etc/resolv.conf. Добавление дополнительных нефильтрованных резолверов значительно ускоряет сканирование. Подробности см. в примере resolv.conf и в разделе Советы и хитрости.
Примеры команд
1) Поиск поддоменов
Пассивные API-источники плюс рекурсивный DNS-брутфорс с мутациями поддоменов, специфичными для цели.
# find subdomains of evilcorp.com
bbot -t evilcorp.com -p subdomain-enum

# passive sources only
bbot -t evilcorp.com -p subdomain-enum -rf passive
subdomain-enum.yml
description: Enumerate subdomains via APIs, brute-force

flags:
  # enable every module with the subdomain-enum flag
  - subdomain-enum

output_modules:
  # output unique subdomains to TXT file
  - subdomains

config:
  dns:
    threads: 25
    brute_threads: 1000
  # put your API keys here
  # modules:
  #   github:
  #     api_key: ""
  #   chaos:
  #     api_key: ""
  #   securitytrails:
  #     api_key: ""
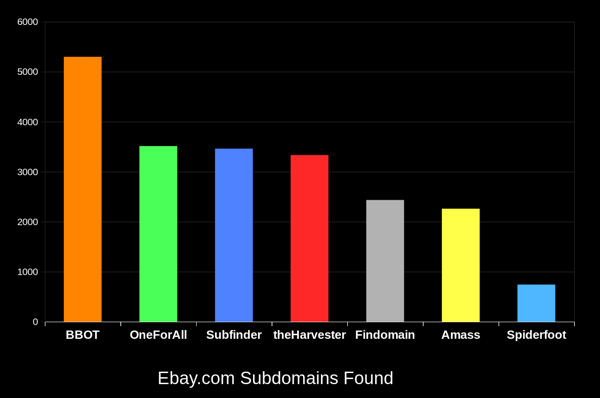
BBOT стабильно находит на 20-50% больше поддоменов, чем другие инструменты. Чем крупнее домен, тем заметнее разница. Чтобы узнать, как это возможно, см. раздел Как это работает.
2) Веб-паук
# crawl evilcorp.com, extracting emails and other goodies
bbot -t evilcorp.com -p spider
spider.yml
description: Recursive web spider

modules:
  - http

blacklist:
  # Prevent spider from invalidating sessions by logging out
  - "RE:/.*(sign|log)[_-]?out"

config:
  web:
    # how many links to follow in a row
    spider_distance: 2
    # don't follow links whose directory depth is higher than 4
    spider_depth: 4
    # maximum number of links to follow per page
    spider_links_per_page: 25
3) Сбор email-адресов
# quick email enum with free APIs + scraping
bbot -t evilcorp.com -p email-enum

# pair with subdomain enum + web spider for maximum yield
bbot -t evilcorp.com -p email-enum subdomain-enum spider
email-enum.yml
description: Enumerate email addresses from APIs, web crawling, etc.

flags:
  - email-enum

output_modules:
  - emails
4) Веб-сканер
# run a light web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web

# run a heavy web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web-heavy
web.yml
description: Quick web scan

include:
  - iis-shortnames

flags:
  - web
web-heavy.yml
description: Aggressive web scan

include:
  # include the web preset
  - web

flags:
  - web-heavy
5) Всё везде и сразу
# everything everywhere all at once
bbot -t evilcorp.com -p kitchen-sink

# roughly equivalent to:
bbot -t evilcorp.com -p subdomain-enum cloud-enum code-enum email-enum spider web paramminer webbrute web-screenshots
kitchen-sink.yml
description: Everything everywhere all at once

include:
  - subdomain-enum
  - cloud-enum
  - code-enum
  - email-enum
  - spider
  - web
  - paramminer
  - webbrute
  - web-screenshots
  - baddns-heavy

config:
  modules:
    dnsbrute:
      recursive_mutations: true
    dnscommonsrv:
      recursive_mutations: true
    webbrute:
      avoid_wafs: False
    wayback:
      urls: True
      parameters: True
      archive: True
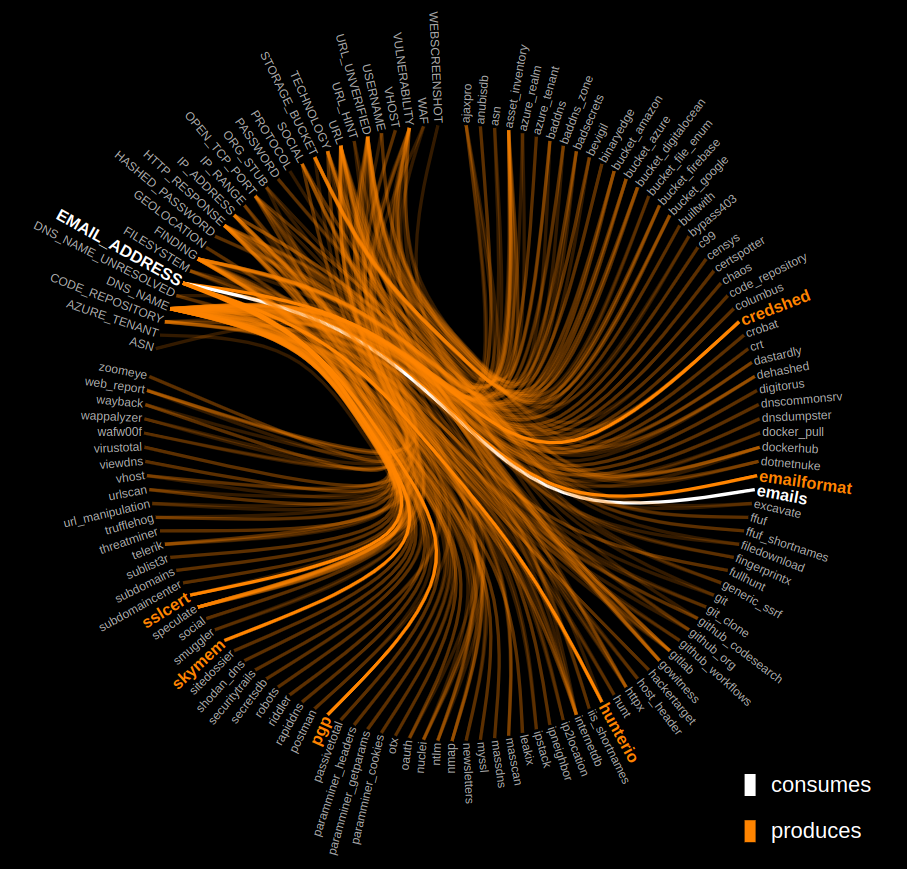
Как это работает
Нажмите на график ниже, чтобы изучить внутреннее устройство BBOT.