
Ciphey v0.12.1
⚡ Автоматически расшифровывает шифрования без знания ключа или шифра, декодирует кодировки и взламывает хэши ⚡
➡️
Discord |
Документация
⬅️
Проект ciphey
ciphey — это новое поколение инструментов для декодирования, созданное теми же людьми, которые подарили вам Ciphey.
Мы полностью намерены заменить Ciphey на ciphey.
✨ Подробнее о ciphey можно прочитать здесь: https://skerritt.blog/introducing-ciphey/ ✨
Как использовать
Самый простой способ использовать ciphey — присоединиться к Discord-серверу, перейти в канал #bots и использовать ciphey с помощью $ciphey. Введите $help, чтобы получить полезную информацию!
Второй по простоте способ — использовать cargo install ciphey и вызывать его командой ciphey.
Вы также можете выполнить git clone этого репозитория и запустить docker build ., чтобы получить образ.
Возможности
Некоторые возможности, которые могут вас заинтересовать и которыми мы гордимся.
Быстрый
ciphey быстрый. Очень быстрый. Другие декодеры, такие как Ciphey, требуют продвинутого искусственного интеллекта, чтобы определить, по какому пути следует идти для декодирования (пробовать ли Caesar дальше или Base64 и т. д.).
ciphey настолько быстр, что сейчас нам не нужно об этом беспокоиться. На каждое 1 декодирование, которое может выполнить Ciphey, ciphey может выполнить ~7. Это увеличение скорости на 700%.
Сначала библиотека
В ciphey есть 2 основные части: библиотека и CLI. CLI просто использует библиотеку, что означает, что вы можете строить поверх ciphey. Некоторые возможности, которые мы создали:
- Discord-бот
- Улучшенное тестирование всей программы 💖
- Этот CLI
Декодеры
В настоящее время ciphey поддерживает 16 декодеров, и их число растёт быстро. Ciphey поддерживает около ~50, и мы добавляем новые каждый день.
Таймер
Одна из больших проблем Ciphey заключалась в том, что он мог работать бесконечно. Если он не мог декодировать ваш текст, вы никогда об этом не узнали бы!
В ciphey есть таймер (встроенный в библиотеку и CLI), что означает, что в конечном итоге он истечёт. По умолчанию CLI использует 5 секунд, Discord-бот — 10 (с учётом передачи сетевых сообщений).
Лучшие документация и тесты
В ciphey уже есть ~120 тестов, тесты документации (чтобы гарантировать актуальность нашей документации), и мы требуем документирование всех наших основных компонентов. Это прекрасно.
LemmeKnow
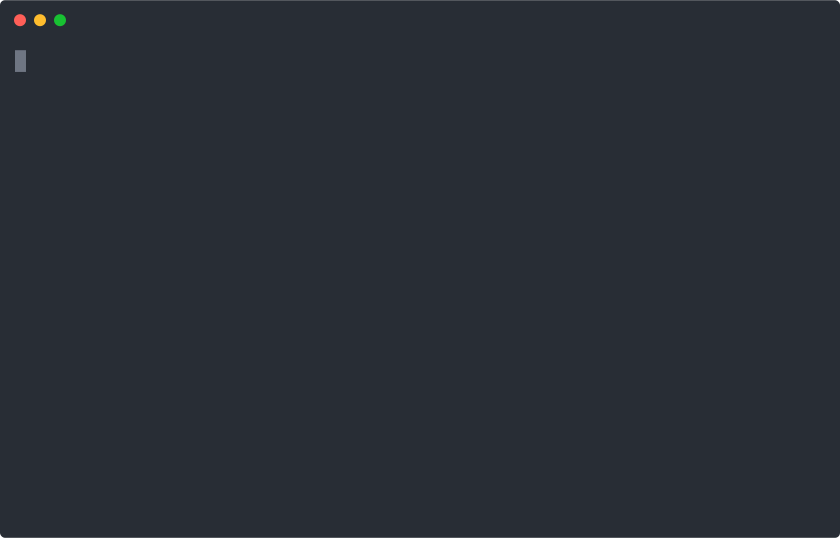

LemmeKnow — это версия PyWhat на Rust. Она в 33 раза быстрее, что означает, что теперь мы можем декодировать и определять, является ли что-то IP-адресом или чем-то ещё, на 3300% быстрее, чем в Python.
Многопоточность
Ciphey не поддерживал многопоточность, он был довольно медленным. ciphey поддерживает её нативно с помощью Rayon, одной из самых быстрых библиотек многопоточности.
Хотя мы не полностью видим эффект от неё при всего 16 декодерах (и они довольно быстрые), по мере добавления новых декодеров (и более медленных) мы увидим, что она не будет так сильно влиять на общую скорость программы.
Многоуровневые декодирования
Ciphey не поддерживал многоуровневые расшифровки, такие как путь Rot13 -> Base64 -> Rot13, потому что он был слишком медленным. ciphey достаточно быстр, чтобы поддерживать это, хотя в конечном итоге мы планируем отключить эту возможность.
Настраиваемая чувствительность для обнаружения открытого текста
Теперь ciphey поддерживает настраиваемые уровни чувствительности для обнаружения бессмысленного текста, что позволяет более точно определять открытый текст для разных типов кодировок. Классические шифры, такие как Caesar, используют низкую чувствительность, чтобы лучше обрабатывать результаты, похожие на английский язык, тогда как большинство других декодеров по умолчанию используют среднюю чувствительность.
Эта возможность помогает уменьшить количество ложных срабатываний и пропусков при обнаружении открытого текста, делая ciphey более надёжным для более широкого диапазона закодированных текстов.
Улучшенное обнаружение открытого текста с помощью BERT
Теперь ciphey предлагает улучшенное обнаружение открытого текста с использованием модели на основе BERT из крейта gibberish-or-not. Эта возможность:
- Повышает точность обнаружения открытого текста примерно на 40%
- Уменьшает количество ложных срабатываний и пропусков при определении открытого текста
- Может быть включена во время первоначальной настройки или позже с помощью
ciphey --enable-enhanced-detection - Требует однократной загрузки AI-модели размером 500 МБ (требуется бесплатная учётная запись Hugging Face)
Новые возможности
Улучшенный алгоритм поиска
Теперь мы используем поиск A*. Это очень быстро.
A* работает, используя эвристику для оценки стоимости достижения цели из текущего состояния.
Сначала мы игнорируем эвристику для очень быстрых декодеров, таких как Base64, и гарантируем, что они запускаются первыми каждый раз на каждом узле.
Затем мы вычисляем эвристику для остальных декодеров с помощью cipher_identifier, который может определить вероятность того, что данная строка является определённым шифром.
Мы сохраняем предыдущие результаты в кэше, чтобы избежать повторного вычисления одного и того же пути.
Мы обрезаем дерево поиска, чтобы избежать ненужных вычислений и снизить потребление памяти, если оно становится слишком большим.
Мы также отслеживаем статистику по декодерам, чтобы динамически отдавать приоритет декодерам, которые работают лучше (например: caesar популярен, а Beaufort — нет, поэтому Caesar будет динамически получать приоритет над Beaufort).
Наконец, мы отслеживаем популярные пары. Так, base64 -> base64 очень популярна, поэтому мы отдаём приоритет этому пути (среди прочих).
Пользовательские темы
Теперь вы можете задать пользовательскую тему для ciphey. Это полезно, если вы хотите, чтобы ciphey выглядел иначе.
Это также помогает с доступностью.
Vigenere
Теперь мы используем, пожалуй, лучший алгоритм для Vigenere.
Он быстрый, точный и лучше обрабатывает небуквенные символы, чем любой другой алгоритм.
Улучшенная проверка английского языка
Мы используем qudgaram / триграммы / проверку по английскому словарю для вычисления вероятности открытого текста.
Мы меняем пороги в зависимости от шифра. Пример: Caesar возвращает текст, который «выглядит» как английский, тогда как base64 — нет.
Помимо этого, у нас есть база данных популярных регулярных выражений (около 500) для API-ключей, MAC-адресов и т. д.
У нас также есть функция is_password для определения, является ли строка точным паролем, встречавшимся в утечке данных.
Больше шифров
- Braille
- Atbash
- Vigenere
База данных
Теперь мы храним статистику в базе данных. Это полезно для отслеживания того, как ciphey работает со временем.