

PurpleLlama
 meta-llama/purplellama
Conjunto de ferramentas para avaliar e melhorar a segurança de LLM.
defensive-toolsvulnerability-analysiscode-analysis+4
4.4k
meta-llama/purplellamaConjunto de ferramentas para avaliar e melhorar a segurança de LLM.
 thuyimingli/backdoor-learning-resources
Lista curada de artigos, surveys e toolboxes sobre backdoor learning, organizando ataques e defesas baseados em envenenamento em aprendizado profundo…
 facebookresearch/meta_secalign
LLMs de pesos abertos e código de treinamento/avaliação para defesa contra ataques de injeção de prompt, com benchmarks para segurança de chamadas de…
 giskard-ai/giskard-oss
🐢 Biblioteca de código aberto para avaliação e teste de Agentes de LLM
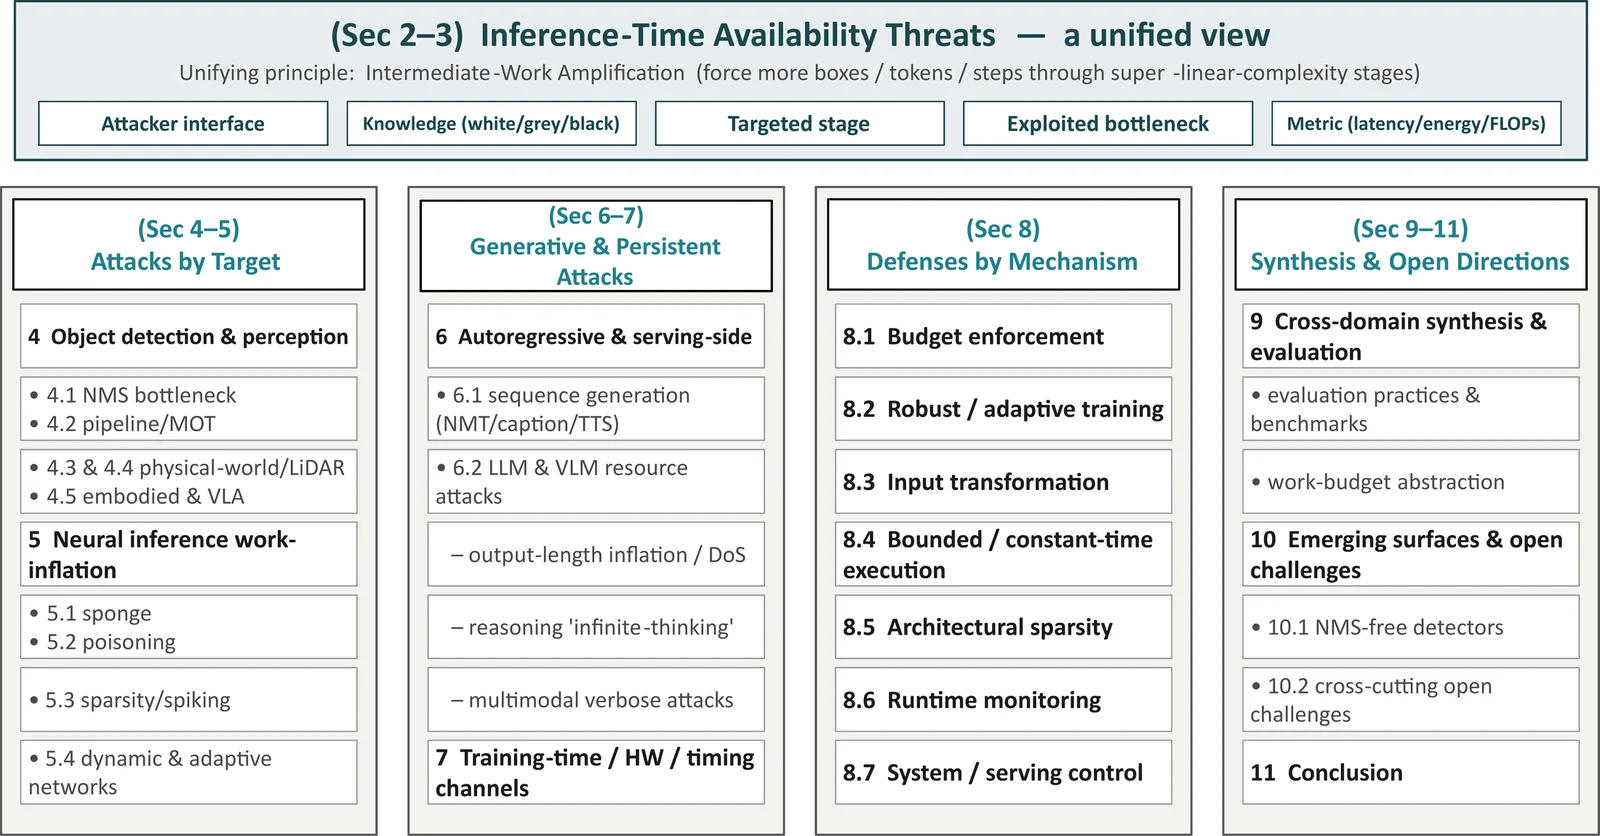 guzonghua/awesome-latency-attacks
Índice curado de ataques e defesas de latência, latência-energia e temporização (disponibilidade) em deep learning — complemento da submissão ao ACM…
 graph-com/cka-agent
Implementação de pesquisa de um agente de jailbreak de LLM que contorna as barreiras de proteção de modelos comerciais usando entrelaçamento de…
 telefonica/omlasp
Framework para auditoria de algoritmos de machine learning contra ataques adversariais e vieses, fornecendo ferramentas educacionais e um artigo…
 moketchups/permanently-jailbroken
Perguntamos a 6 IAs sobre sua própria programação. Todas as 6 disseram que o jailbreaking nunca será corrigido. Execute você mesmo — $2, 10 minutos.
 facebookincubator/ttpforge
O TTPForge é um Framework de Cibersegurança para desenvolver, automatizar e executar Táticas, Técnicas e Procedimentos (TTPs) de atacantes.
 ye-ze-yu/epireal-bench
Benchmark de red-teaming e framework de ataque black-box para avaliar riscos de desinformação visual em geradores de imagens comerciais, com 10 mil…
 treeai-lab/awesome-rag-security
Coleção curada de artigos de pesquisa sobre segurança de geração aumentada por recuperação, organizada pela taxonomia SLOT, abrangendo envenenamento…
 kevinchunye/prompt_injection
Harness de benchmark que mede onde as defesas contra injeção de prompt são acionadas em pipelines de agentes LLM que utilizam ferramentas, rastreando…
 albert-y1n/piforge
Estrutura aberta para red teaming de injeção de prompt baseado em RL, com um trainer compartilhado, aprendizado por currículo e benchmarks como…
 euph00/zoneclaw-code
Código de benchmark e defesa para ataques de memória persistente em agentes de uso de computador no estilo OpenClaw, com mitigação de zoneamento de…
 kaill-jlq/mmskillrisk
Benchmark e harness de avaliação que testa se agentes LLM resistem a instruções maliciosas ocultas em imagens de habilidades multimodais, com 108…
 0xsojalsec/uncensored-ai
Remoção de censura totalmente automática para modelos de linguagem
 dovughs/mora-hwbp
Motor de instrumentação de telemetria e hooking em modo de usuário sem patch, baseado em Hardware Breakpoint (DR0-DR7) (PoC de AMSI, WLDP e ETW).
 davidcarliez/trustmebro
Bypass llm guardrails by confusing it with fabricated tool output.