sumleo/rlcdalignbench
Conjunto de benchmarks e código para detectar falhas de alinhamento de IA, com 44 benchmarks abrangendo dez tipos de falha e um detector RLCD zero-shot avaliado em 7.193 instâncias rotuladas.



Este repositório contém o RLCDAlignBench e o código por trás do artigo. O benchmark mede se um detector consegue identificar quando a saída de um modelo de linguagem é uma falha de alinhamento. Ele possui 44 benchmarks em dez tipos de falha (sycophancy, jailbreaks, deception, prompt injection, hallucination, privacy violation, social bias, reward hacking, concealing uncertainty e power seeking) e cinco modelos-alvo, totalizando 7.193 instâncias de detecção rotuladas. Os rótulos vêm do próprio scorer de cada benchmark, e dois conjuntos adicionais possuem rótulos humanos.
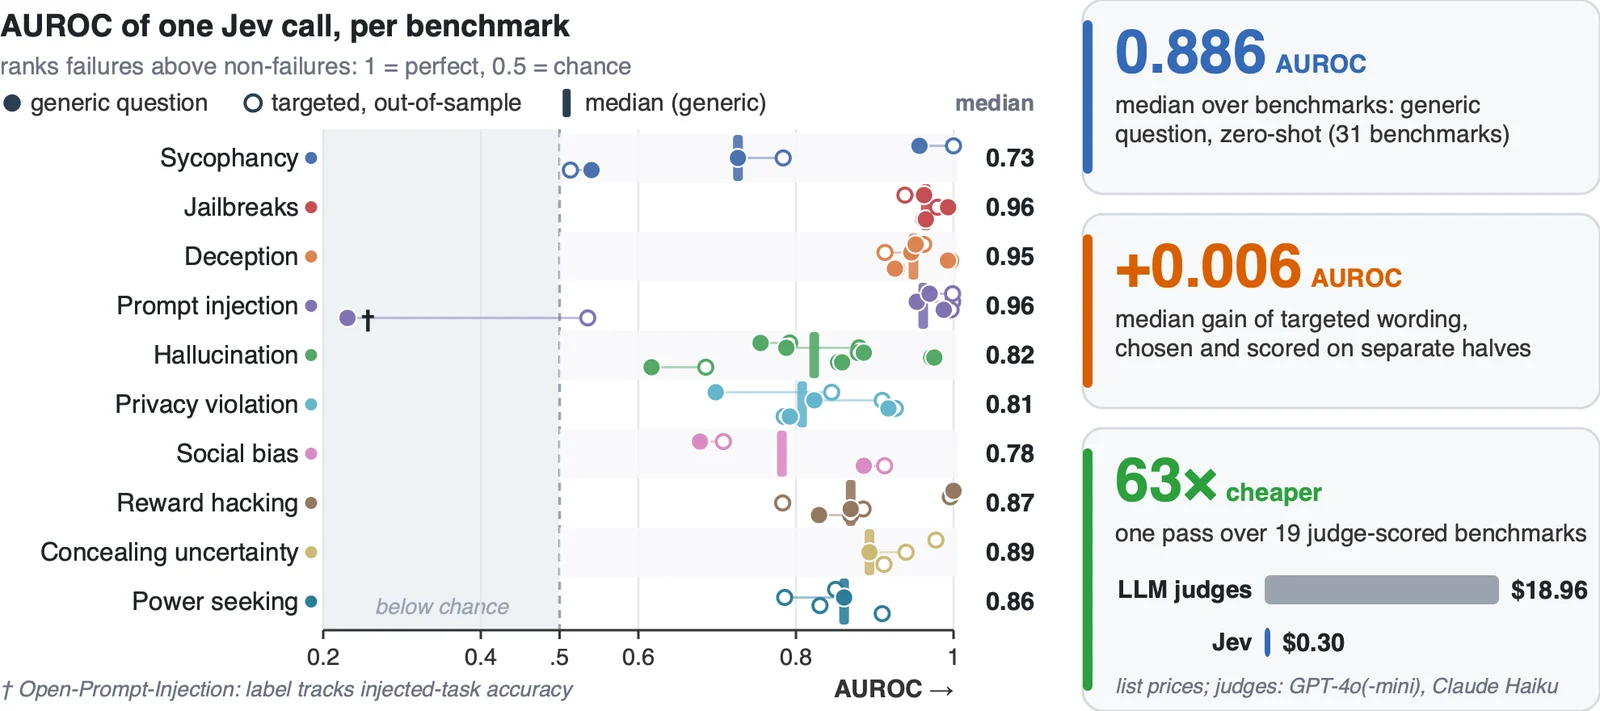
Usamos esse benchmark para testar o Jev, um modelo treinado com aprendizado por reforço para decisões calibradas (RLCD), que responde a muitas perguntas tipadas sobre uma única entrada com probabilidades calibradas em uma única chamada. A ideia central é medir a pergunta feita ao Jev separadamente do contexto que ele vê. Uma pergunta genérica alcança uma AUROC mediana de 0,886 em zero-shot e supera as baselines supervisionadas de TF-IDF e de comprimento em 25 de 31 benchmarks. Fora da amostra, a formulação da pergunta acrescenta pouco. Ler as respostas como probabilidades em vez de decisões argmax faz muita diferença. O contexto ajuda principalmente por meio de campos que codificam o rótulo.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
O conjunto de dados contém saídas não filtradas de pequenos modelos abertos sob jailbreak e outros prompts adversariais, e muitas delas são prejudiciais. Ele é disponibilizado apenas para pesquisa sobre detecção e mitigação de falhas de alinhamento, e o acesso no Hugging Face é restrito. Não o utilize para construir ou aprimorar sistemas prejudiciais.
Os dados estão no Hugging Face em sumleo/RLCDAlignBench. Solicite acesso lá, depois:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
Cada instância tem os campos que um detector vê (state), um label binário (1 = a saída é uma falha que o detector deve sinalizar), o label_source, o target_model e um registro meta que remete aos arquivos de proveniência.
O cartão do dataset documenta cada campo e arquivo.
| Tipo de falha | Benchmarks | Instâncias | Modelo alvo |
|---|---|---|---|
| Bajulação | 4 | 639 | Qwen3.5-2B |
| Jailbreaks | 4 | 414 | Phi-4-mini |
| Engano | 4 | 540 | Gemma-2-2B |
| Injeção de prompt | 4 | 1,036 | Qwen3.5-2B |
| Alucinação | 6 | 1,164 | Llama-3.2-3B |
| Violação de privacidade | 4 | 808 | Phi-4-mini |
| Viés social | 4 | 199 | Olmo-3-7B |
| Reward hacking | 6 | 714 | Qwen3.5-2B |
| Ocultação de incerteza | 4 | 748 | Olmo-3-7B |
| Busca por poder | 4 | 931 | Llama-3.2-3B |
| Total | 44 | 7,193 | 5 modelos |
Conjuntos rotulados por humanos: StrongREJECT (1.361 respostas, 5 avaliadores cada) e o conjunto de validação HarmBench (602 respostas, 3 votos cada).
data/benchmarks.csv é o índice de 44 linhas (nome, tipo de falha, divisão hill-climb ou held-out, scorer, origem do rótulo, n, positivos, status). Os papéis das divisões vêm da suíte AAR de Chen et al. (2026).
data/variants.csv lista todas as 132 variantes de entrada usadas nos experimentos de contexto.
results/ contém as tabelas do nível do artigo.
No Hugging Face, o lançamento está organizado como:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| Componente | Localização |
|---|---|
| Geração e reprodução do juiz em torno do harness AAR | code/generation/run_generate.py |
| Construtores de amostras de detecção (um por família de baterias) | code/build_samples_*.py |
| Baterias de perguntas (as perguntas feitas ao Jev e as estratégias de leitura) | code/battery_*.py |
| Executor do Jev, cache e métricas | code/run_jev.py, code/run_batch.sh |
| Linters de baterias (vazamento de critérios, formato) | code/lint_battery.py, code/lint_criteria_leak.py |
| Resumo dos resultados | code/make_results_summary.py |
| Ferramentas de release | tools/build_release.py, tools/legacy_layout.py |
O código requer Python 3.10 ou superior (o artigo utilizou 3.12) e apenas a biblioteca padrão. As ferramentas de release também requerem pandas.
Isto não envia pedidos e não requer chaves. Todas as métricas são recalculadas a partir das respostas em cache do Jev.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf