
 suhanmen/sew
Incorpora e detecta marcas d'água com chave e baseadas em estilo em código Python, Java e C++ gerado por LLM por meio de reescrita de CST, preservando a correção funcional e resistindo a ataques de edição de código.



| Recurso | Marcas d'água em nível de token (KGW, SWEET, Unigram, STONE, STA-1) | Marcas d'água post-hoc (ACW, SrcMarker, RoSeMary) | ✨ SEW |
|---|---|---|---|
| Acesso | No momento da decodificação (enviesa a seleção de tokens) | Post-hoc (reescreve o código finalizado) | Post-hoc (reescreve o código finalizado, agnóstico ao modelo) |
| Correção funcional | Altera o programa (trade-off entre detectabilidade e correção) | Pode quebrar programas (pass@1 em Java/C++ ≈ 12% para reescrita neural) | Preservada (pass@1 igual ao código sem marca d'água) |
| Previsibilidade | — | Padrões recorrentes (recuperados de 10 programas com marca d'água) | Dependente da chave e do contexto (as escolhas variam com a estrutura de cada programa) |
| Detecção (TPR@FPR5%) | 14–60% | 31–98% | ⚡ 98,7–99,5% |
A marcação d'água de código gerado por LLM apoia o rastreamento de proveniência. Marcas d'água que modificam a seleção de tokens durante a geração trocam detectabilidade por correção funcional, e exigem controle sobre o modelo gerador. Métodos post-hoc, em vez disso, marcam o código já concluído com transformações predefinidas ou modelos neurais treinados, mas seus padrões recorrentes tornam a marca d'água previsível entre programas, e padrões que já são comuns em código sem marca d'água são contados como evidência de marca d'água, o que causa detecções falsas. O SEW pergunta: o estilo de código de um programa já gerado pode carregar uma marca d'água que seja correta por construção, difícil de prever e calibrada em relação a código escrito por humanos?
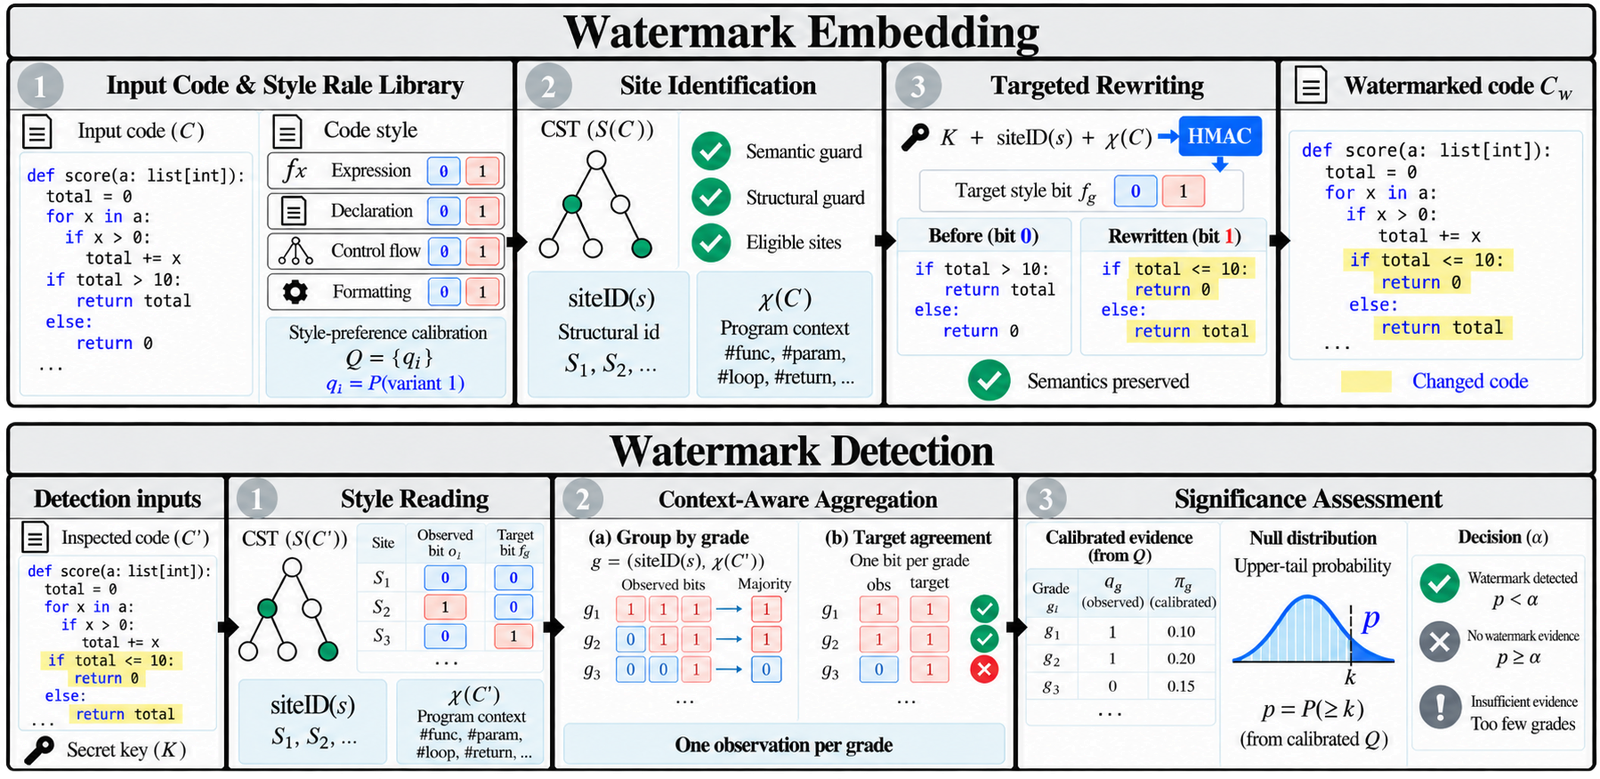
O SEW (Style-Encoded Watermarking) incorpora e detecta marcas d'água em código já gerado por meio de três componentes:
x += 1 / x = x + 1, range(n) / range(0, n), if (c) s; / if (c) { s; }) são correspondidas na árvore de sintaxe concreta (CST). Qual variante um local assume é decidido por uma chave secreta e pelo contexto estrutural do local.A detecção precisa apenas do código suspeito e da chave — não do modelo gerador, do código original ou de qualquer registro da incorporação.
✅ Agnóstico ao modelo e correto por construção — o SEW só reescreve locais de estilo onde ambas as variantes têm a mesma semântica, então funciona na saída de qualquer modelo e mantém o pass@1 igual ao do código sem marca d'água.
✅ Evidência calibrada — um teste binomial de Poisson com probabilidades de estilo estimadas a partir de código escrito por humanos (soluções do LeetCode, disjuntas dos dados de avaliação) mantém baixas as detecções falsas em código humano.
✅ Robusto e difícil de inferir — o SEW mantém sua detecção sob formatação, linting, remoção de comentários e renomeação de variáveis, e um adversário que observa programas com marca d'água não consegue recuperar suas escolhas de estilo da forma como recupera as das baselines post-hoc.
Resultado principal — detecção no CodeContests (TPR@FPR5% / AUROC, %), com média sobre três LLMs (Qwen3.5-9B, gemma-4-12B-it, gpt-oss-20b).
| Tipo | Método | Python | Java | C++ |
|---|---|---|---|---|
| Nível de token | KGW | 48,33 / 80,56 | 43,30 / 72,31 | 59,31 / 84,54 |
| SWEET | 59,92 / 85,18 | 41,19 / 76,56 | 60,01 / 87,24 | |
| Unigram | 57,45 / 88,97 | 36,54 / 71,37 | 47,05 / 71,13 | |
| STONE | 28,09 / 62,33 | 14,38 / 62,95 | 23,65 / 64,79 | |
| STA-1 | 35,26 / 66,26 | 20,93 / 61,48 | 44,71 / 73,72 | |
| Post-hoc | ACW | 90,10 / 95,05 | – | – |
| SrcMarker | 90,21 / 97,86 | 71,52 / 93,58 | 69,88 / 81,55 | |
| RoSeMary | 97,86 / 97,32 | 31,00 / 95,46 | 81,26 / 89,44 | |
| SEW | 99,49 / 99,64 | 98,70 / 98,99 | 99,22 / 99,38 |
Correção funcional (pass@1 do código com marca d'água, %; código sem marca d'água: 57,63 / 52,05 / 53,74).
| Método | Python | Java | C++ |
|---|---|---|---|
| ACW | 56,00 | – | – |
| SrcMarker | 56,78 | 11,87 | 11,82 |
| RoSeMary | 56,39 | 11,71 | 11,52 |
| SEW | 57,63 | 52,05 | 53,74 |
Robustez a ataques de edição de código (TPR@FPR5%, %, com média sobre três LLMs e três linguagens; ACW: apenas Python).
| Método | Sem ataque | Formatação | Linting | Remoção de comentários | Renomeação |
|---|---|---|---|---|---|
| KGW | 50,31 | 43,31 | 49,99 | 24,48 | 43,26 |
| SWEET | 53,71 | 49,79 | 53,00 | 19,34 | 48,83 |
| ACW | 90,10 | 0,51 | 93,56 | 89,35 | 3,17 |
| SrcMarker | 77,20 | 77,23 | 76,42 | 77,20 | 26,43 |
| RoSeMary | 70,04 | 67,00 | 69,42 | 70,04 | 22,26 |
| SEW | 99,14 | 95,57 | 98,99 | 99,14 | 99,14 |






