 pvharmo2/gha-lab-e8902eccd3
Laboratório de pesquisa em segurança: reprodução do CVE-2025-52467 (execução de código no fluxo de trabalho pull_request_target do pgai / exfiltração de GITHUB_TOKEN) — snapshot de timescale/pgai

Artefacto de investigação automatizado — não é o projeto upstream.
Este repositório é um laboratório descartável construído por um harness automatizado para uma tese de mestrado na Université Laval sobre a reprodução de vulnerabilidades publicadas em workflows do GitHub Actions. É um snapshot verbatim de
timescale/pgaino commit2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14), redistribuído sob a licença desse próprio projeto, cujo ficheiro está incluído inalterado neste snapshot.O projeto upstream não está envolvido, nunca é alvo, e a vulnerabilidade aqui estudada já é pública. Todos os segredos e variáveis neste repositório são valores fictícios gerados aleatoriamente — nenhuma credencial real está presente. As referências a ações e imagens de runners estão fixadas no que resolveram em 2025-05-14; consulte
pinning.mdna saída do harness para todas as alterações feitas ao snapshot.Perguntas ou objeções: [email protected]
Uma biblioteca Python que transforma o PostgreSQL num motor de recuperação robusto e pronto para produção para aplicações RAG e Agentic.
🔄 Crie e sincronize automaticamente embeddings vetoriais a partir de dados PostgreSQL e documentos S3. Os embeddings são atualizados automaticamente à medida que os dados mudam.
🔍 Pesquisa vetorial e semântica poderosa com pgvector e pgvectorscale.
🛡️ Pronto para produção de imediato: Suporta processamento em lote para geração eficiente de embeddings, com tratamento integrado para falhas de modelo, limites de taxa e picos de latência.
🐘 Funciona com qualquer base de dados PostgreSQL, incluindo Timescale Cloud, Amazon RDS, Supabase e mais.
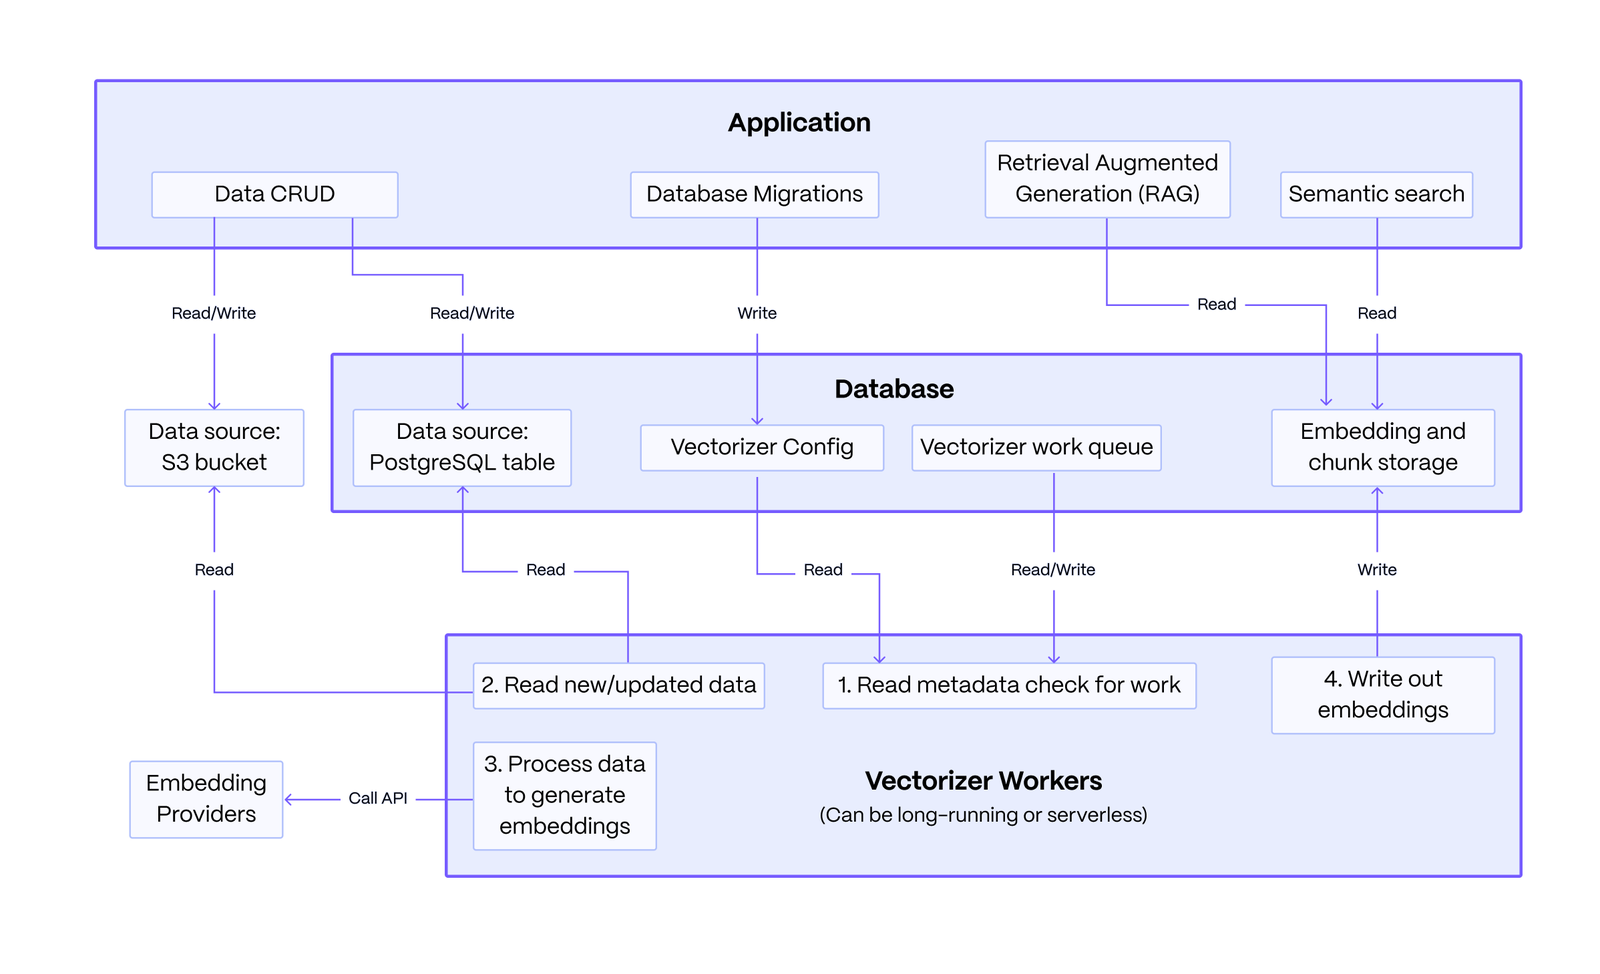
Arquitetura básica: O sistema consiste numa aplicação que você escreve, numa base de dados PostgreSQL e em workers de vectorização sem estado. A aplicação define uma configuração de vectorização para incorporar dados de fontes como PostgreSQL ou S3. Os workers leem esta configuração, processam a fila de dados em embeddings e texto fragmentado, e escrevem os resultados de volta. A aplicação consulta então estes dados para alimentar RAG e pesquisa semântica.
O principal ponto forte desta arquitetura reside na sua resiliência: as modificações de dados feitas pela aplicação são desacopladas do processo de embedding, garantindo que falhas no serviço de embedding não afetam as operações de dados principais.
Primeiro, instale o pacote pgai.``` pip install pgai
Em seguida, instale os componentes de banco de dados do pgai. Você pode fazer isso pelo terminal usando a CLI ou no código da sua aplicação Python usando o pacote Python pgai.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
Este guia de início rápido demonstra como o pgai Vectorizer possibilita pesquisa semântica e RAG sobre dados do PostgreSQL, criando e sincronizando automaticamente embeddings à medida que os dados mudam.
O principal "ingrediente secreto" do pgai Vectorizer é sua abordagem declarativa para geração de embeddings. Basta definir seu pipeline e deixar o Vectorizer lidar com a complexidade operacional de manter os embeddings sincronizados, mesmo quando os endpoints de embedding não são confiáveis. Você pode definir uma versão simples do pipeline da seguinte forma:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
O vectorizador criará automaticamente embeddings para todas as linhas da
tabela `wiki` e, mais importante, manterá os embeddings sincronizados com os
dados subjacentes à medida que estes mudam.  **Pense nisso quase como declarar um índice** na
tabela `wiki`, mas em vez de o banco de dados gerenciar a estrutura de dados do índice
para você, o Vectorizer gerencia os embeddings.

## Executando o quick start

**Pré-requisitos:**
- Um banco de dados PostgreSQL ([instruções do docker](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- Uma chave de API da OpenAI (usamos openai para embedding no quick start, mas você pode usar [vários provedores](#supported-embedding-models)).

Crie um arquivo `.env` com o seguinte:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
Podes descarregar o código Python completo e o requirements.txt do exemplo de início rápido e executá-lo no mesmo diretório do ficheiro .env.
