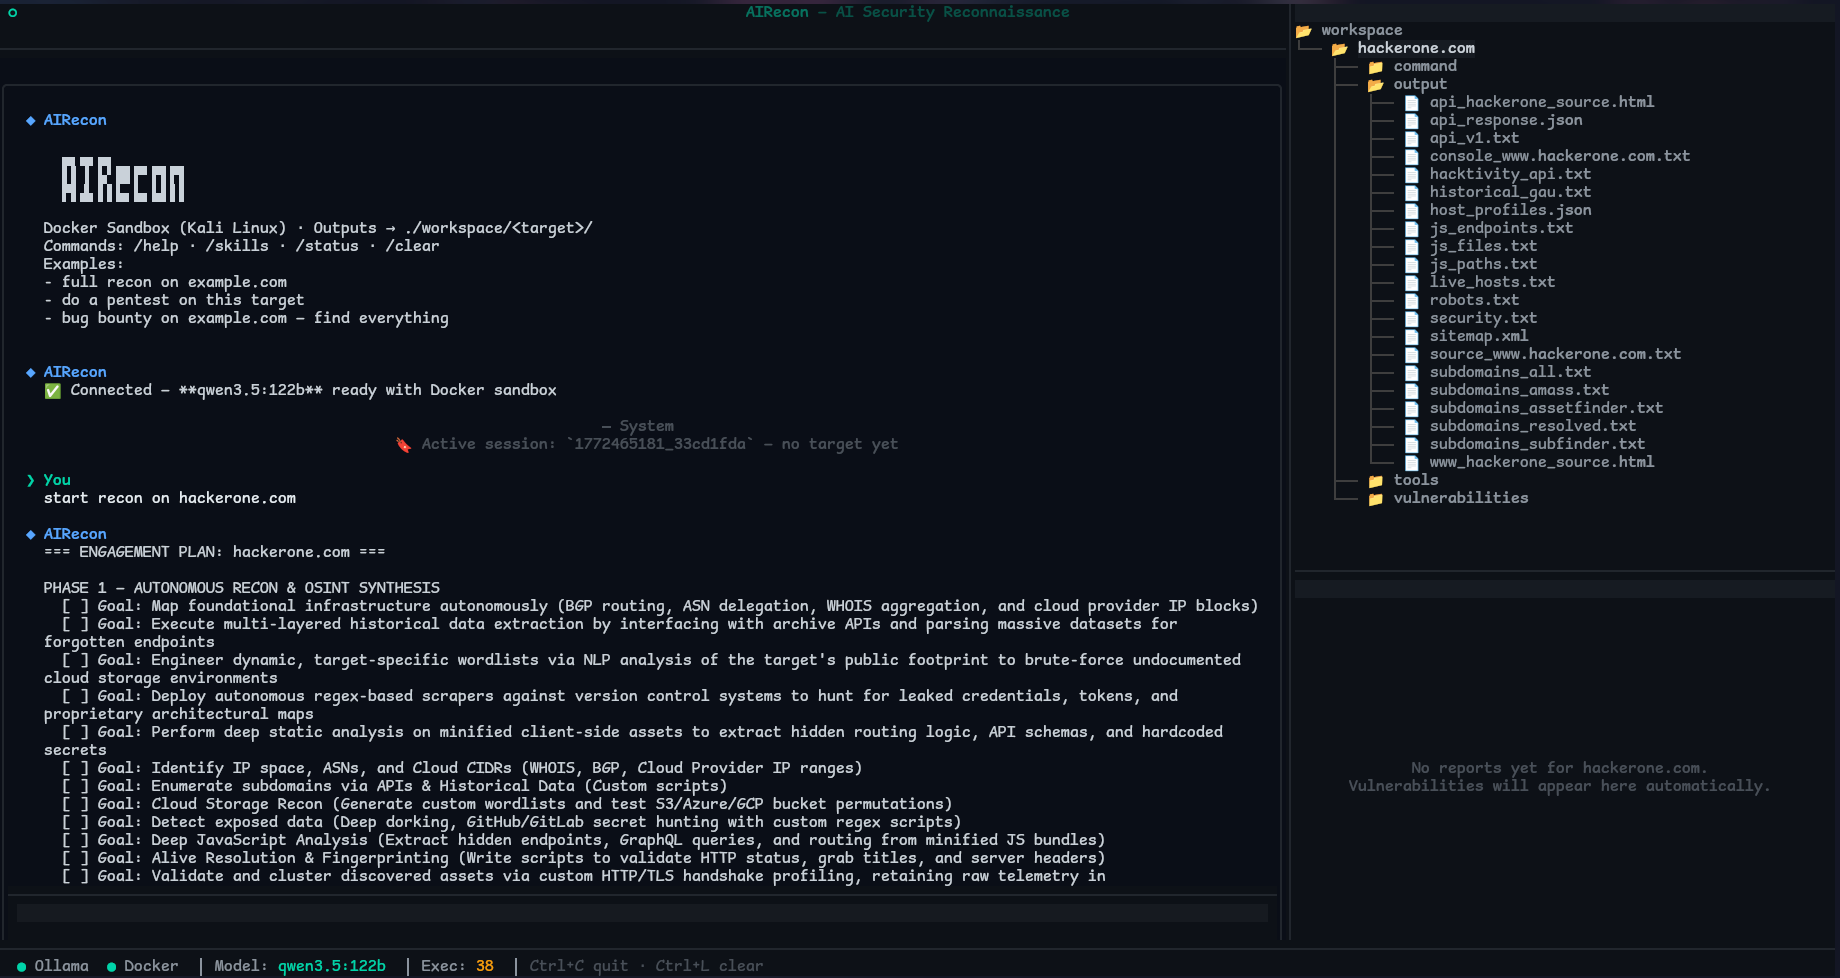

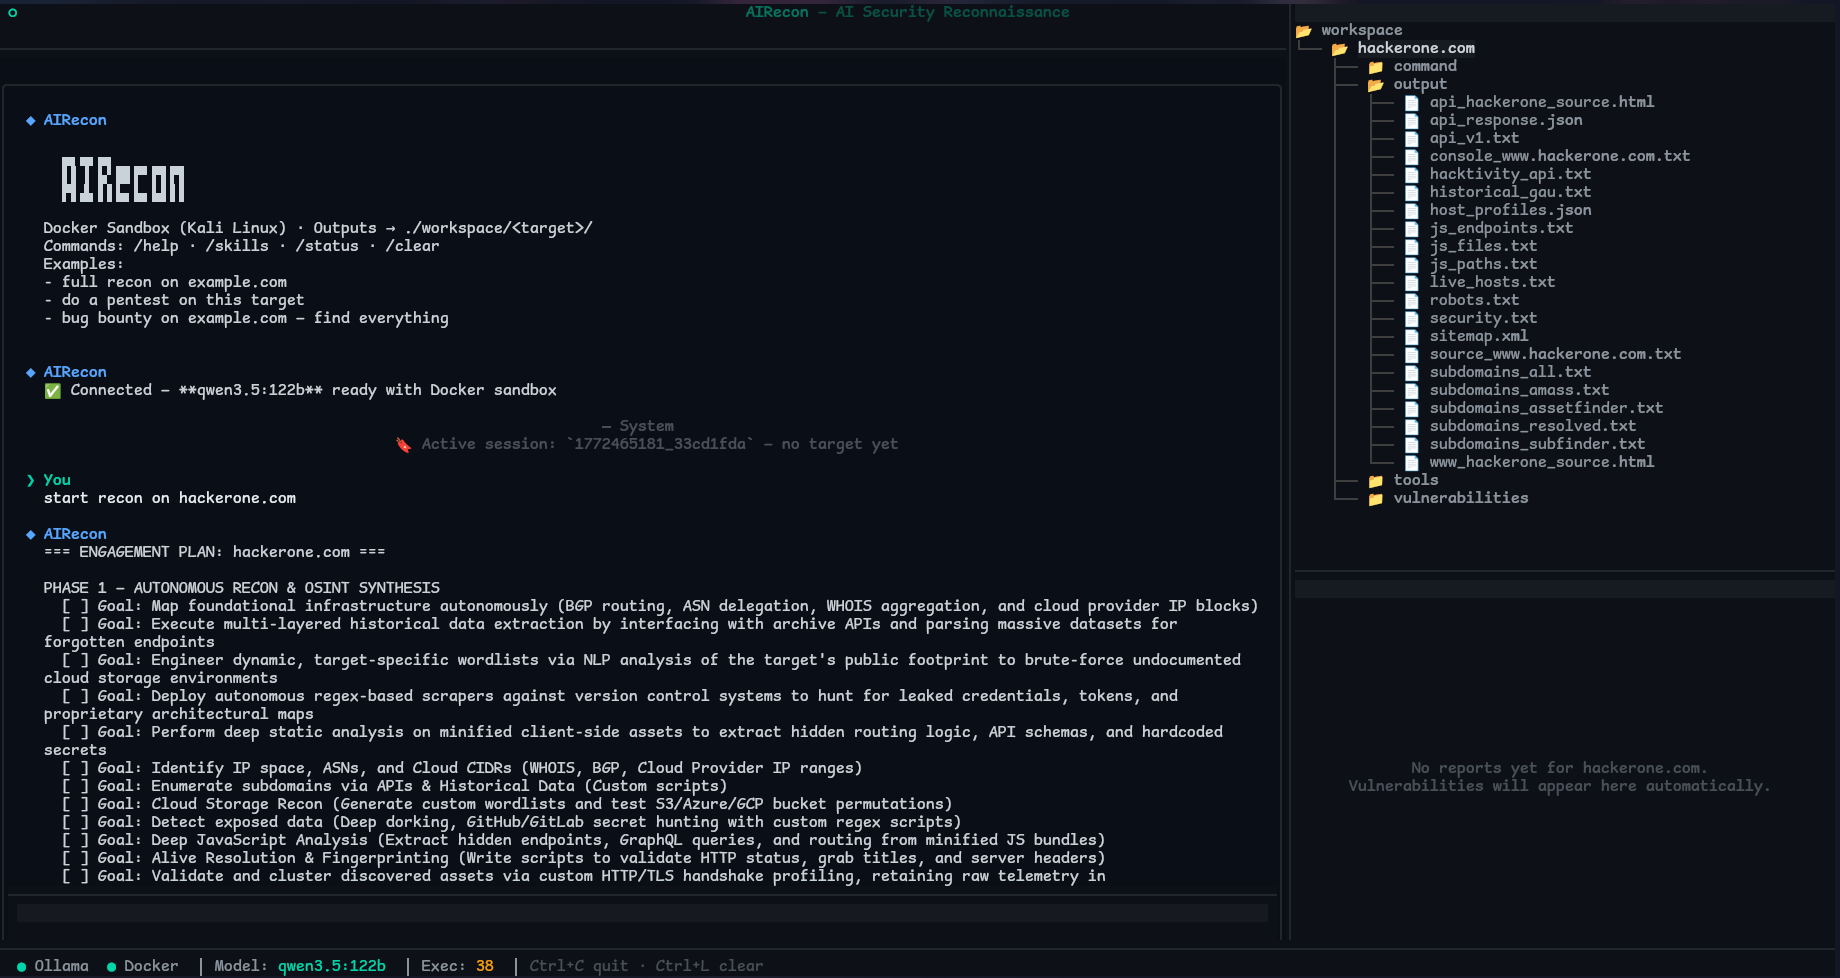
AIRecon é um agente autônomo de cibersegurança que combina um Modelo de Linguagem Grande auto-hospedado (Ollama) com um sandbox Docker Kali Linux e uma TUI Textual. Ele é projetado para automatizar avaliações de segurança, testes de penetração e reconhecimento de bug bounty — sem chaves de API ou dependência de nuvem.




AIRecon é um agente autônomo de teste de penetração que opera qualquer gateway LLM compatível com OpenAI (LiteLLM / vLLM / um endpoint hospedado — ou um gateway local fazendo proxy de um Ollama local) com um sandbox Docker Kali Linux, integração nativa com o proxy Caido, um pipeline estruturado RECON → ANALYSIS → EXPLOIT → REPORT, e uma TUI Textual em tempo real.
Agnóstico de backend por design. Aponte o AIRecon para um gateway local (LiteLLM / vLLM, ou um gateway fazendo proxy de um Ollama local) para operação totalmente offline / privada, ou para um endpoint hospedado compatível com OpenAI/Anthropic/Gemini para máxima qualidade de raciocínio. O suporte a raciocínio é detectado automaticamente em tempo de execução — sem hardcoding por modelo.
O Swiftproxy fornece mais de 90 milhões de IPs residenciais limpos em mais de 220 localizações, com suporte a HTTP(S)/SOCKS5, rotação de IP, Sessões Sticky e geolocalização precisa. Ele ajuda fluxos de trabalho de pesquisa e reconhecimento com IA a acessar sites de forma confiável a partir de diferentes localizações, tornando-o adequado para pesquisa web, coleta de dados, scraping e acesso baseado em localização.
Testes gratuitos estão disponíveis, com 10% de desconto usando o código PROXY90.
O AIRecon se comunica com um único gateway compatível com OpenAI, então você escolhe o trade-off — execute um modelo local para privacidade e custo zero de API, ou um modelo hospedado para máxima qualidade de raciocínio. O mesmo agente, pipeline, sandbox e ferramentas funcionam de qualquer forma.
| Recurso | AIRecon |
|---|---|
| Backend | Qualquer gateway compatível com OpenAI (LiteLLM / vLLM / hospedado) |
| Totalmente offline / sem chaves de API | Sim — ao usar um gateway local (vLLM, ou um gateway → Ollama local) |
| Detecção de raciocínio | Automática em tempo de execução (sem hardcoding de nome de modelo) |
| Integração com Caido | Nativa |
| Guarda de escopo + log de auditoria | Sim — recusa alvos fora do escopo, registra cada comando |
| Aprendizado apenas verificado | Sim — o cérebro acumula descobertas comprovadas, não ruído |
| Retomada de sessão (chat + chamadas de ferramentas) | Sim |
| Base de conhecimento local | ~1,09M registros (opcional) |
§FUZZ§), findings, scope, sitemap, intercept.dataset_search autonomamente antes de tentar técnicas desconhecidas — fundamentando suas decisões em dados reais indexados.RECON → ANALYSIS → EXPLOIT → REPORT
Cada fase tem objetivos específicos, ferramentas recomendadas e critérios de transição automática. A aplicação das fases é flexível — o agente é orientado mas nunca bloqueado. Os checkpoints são executados a cada 5 (avaliação de fase), 10 (autoavaliação) e 15 (compressão de contexto) iterações.
O AIRecon não faz fine-tuning do LLM. A sua "aprendizagem" é telemetria local e estruturada que orienta a escolha de ferramentas e evita repetir caminhos falhados.
Persistência local (tudo em disco, sem cloud):
~/.airecon/memory/airecon.db que armazena sessões, descobertas, padrões, informações sobre o alvo, utilização de ferramentas, desempenho do modelo, utilização de skills e descobertas de cadeias de ataque.~/.airecon/learning/global_learning.json (estatísticas de desempenho de ferramentas, padrões de estratégia, registo de observações, insights destilados).~/.airecon/memory/by_target/ quando persistidos, contendo endpoints, vulnerabilidades, bypasses de WAF, parâmetros sensíveis e endpoints de autenticação.workspace/<target>/payload_memory.json quando a persistência de sessão é executada.Como afeta o comportamento:
tech_correlations — assim os conjuntos de dados são usados como o cérebro desde a iteração 1.intelligence_memory_recall_interval iterações (predefinição 4), os padrões aprendidos / conhecimento de arranque a frio são reinjetados com base na tecnologia detetada; a correlação é executada a cada intelligence_correlation_interval (predefinição 6).intelligence_learn_only_verified, ativado por predefinição).intelligence_adaptive_min_observations (predefinição 2) observações.
