 noahware/binprotect
Ofuscador bin2bin para PE x64 que não adiciona uma seção ao binário

Consulte 4. Compilação para instruções de compilação.
Este ofuscador é bin2bin, o que significa que ele pega um binário executável já compilado e o reproduz com as passagens de ofuscação aplicadas. Isso pode ser usado para proteger um aplicativo sem ter acesso ao código-fonte original. Apenas arquivos PE (portable executable) x64 são suportados atualmente, mas há planos de adicionar suporte para outros formatos binários (ex.: ELF) no futuro.
Atualmente, todos os ofuscadores bin2bin conhecidos inserem uma seção no final do binário para colocar o código ou dados ofuscados. Isso é feito para que o layout original do binário ainda seja preservado, sem ter que alterar o conteúdo das seções pré-existentes. Isso é muito mais fácil de gerenciar, pois mantém a maioria dos RVAs (endereços relativos) válidos.
Este projeto adota uma abordagem única para bin2bin, onde qualquer código ou dados ofuscados são inseridos dentro das seções originais do binário. Isso exige o rastreamento de cada RVA no aplicativo. Os benefícios dessa abordagem são:
Este documento descreverá tanto a reescrita do binário executável quanto as técnicas de ofuscação implementadas. As seguintes técnicas de ofuscação foram implementadas:
Além disso, este projeto também possui suporte a exceções (exceções C++ e SEH) e é capaz de ofuscar funções que possuem tratamento de exceções.
Para auxiliar na desmontagem e descoberta de código no binário, arquivos de símbolo (tanto PDB quanto MAP) são aceitos opcionalmente. O fornecimento de arquivos de símbolo não é obrigatório, mas auxilia na desmontagem em binários complexos. Alguns recursos, como suporte a exceções e achatamento de fluxo de controle, exigem o fornecimento de um arquivo de símbolo.
Um reescritor binário pega um binário executável e altera o código ou dados dentro dele para produzir um binário de saída com as alterações aplicadas.
Como o código ofuscado é inserido diretamente nas seções originais do binário, os endereços relativos no programa devem ser rastreados para que todas as referências a eles possam ser ajustadas. Isso é feito para que as referências ainda apontem para o mesmo local após a inserção do código e dos dados. Caso contrário, dados ou códigos seriam acessados no local errado, alterando o comportamento do binário de saída e causando graves instabilidades.
Sempre que uma referência a um endereço relativo é encontrada (ex.: instrução contendo operandos relativos ao rip ou diretórios de dados do PE), ela é adicionada a uma lista de rastreamento para ser atualizada ao final da reescrita. O RVA onde a referência ocorre é rastreado (para saber onde atualizar a referência), assim como o RVA que está sendo referenciado (para saber qual RVA usar para atualizar a referência).
Sempre que o desmontador encontra uma instrução relativa ao rip, ele a adiciona a uma lista de referências a serem atualizadas ao final da ofuscação. Isso garante que todas essas instruções ainda estejam apontando para o local que originalmente tinham. Outros casos de instruções relativas, como tabelas de desvio, também são adicionados como referências a serem atualizadas.
Todos os RVAs rastreados precisam ser ajustados sempre que bytes são inseridos ou removidos do binário. Por exemplo, aqui está o manipulador de inserção de bytes:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas` é onde cada RVA rastreada é atualizada para refletir a mudança que ocorreu no binário. Aqui está um diagrama deste processo:
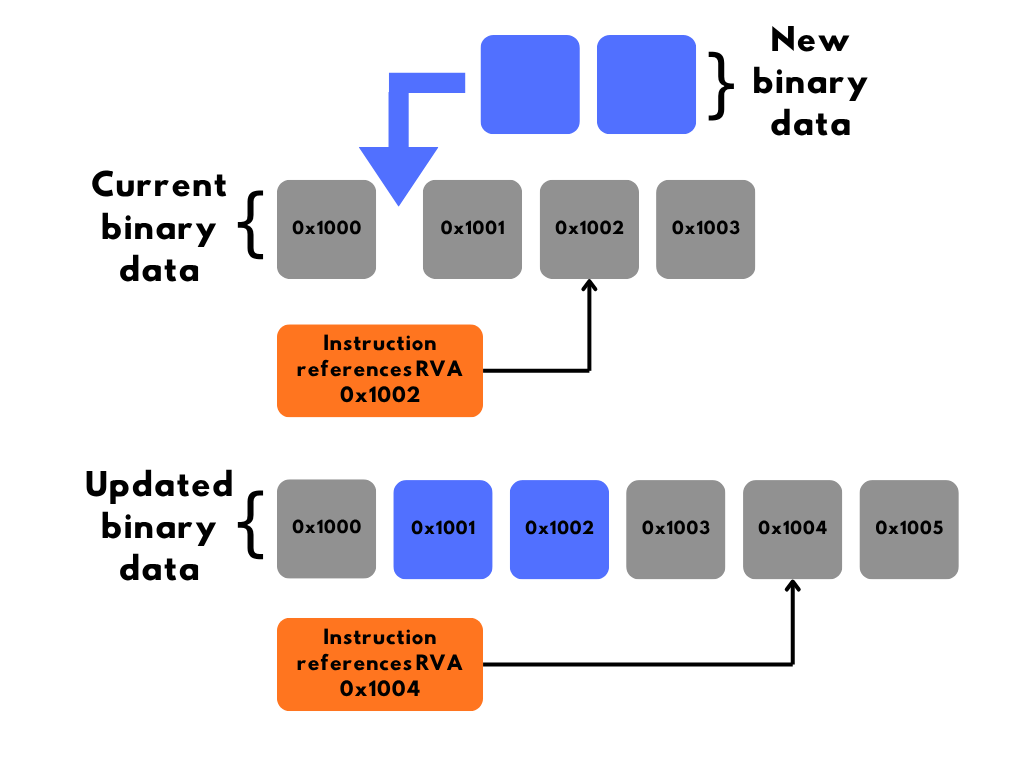
Figura 1. Rastreamento de endereços relativos.
Os dados inseridos (azul) deslocam os dados atuais (cinza). A RVA referenciada pela instrução (laranja) é atualizada para apontar para a mesma memória, levando em conta os dados inseridos (azul).
## 2.2. Desmontagem
Todas as entradas de código potenciais (exports, ponto de entrada, realocações apontando para a seção de código, etc) são adicionadas a uma fila de desmontagem. Se um arquivo de símbolo estiver presente, todas as funções descritas pelo arquivo de símbolo também são adicionadas à fila de desmontagem. Cada entrada na fila é tratada como um bloco básico individual.
Um bloco básico é um grupo de instruções sem desvios; isso significa que ele é terminado em instruções de fluxo de controle (ex.: jump, ret, int). Blocos básicos não terminam em chamadas (calls) pois espera-se que elas retornem na maioria dos casos. Algumas funções não retornam (ex.: _CxxThrowException) e serão referidas como chamadas 'noreturn' daqui em diante.
Quando um bloco básico da fila de desmontagem está sendo processado, cada instrução é desmontada a partir do início até que uma das seguintes situações ocorra:
- Outro bloco básico já analisado é alcançado, causando uma sobreposição. Veja “Divisão de blocos básicos”.
- Instrução de término é encontrada (jump, return, int).
- A desmontagem da instrução falhou.
- Padding de código foi encontrado.
Abaixo está um diagrama da desmontagem e da entrada na fila de desmontagem (a verificação de padding de código foi omitida no diagrama). Isso é repetido até que a fila de desmontagem esteja vazia.
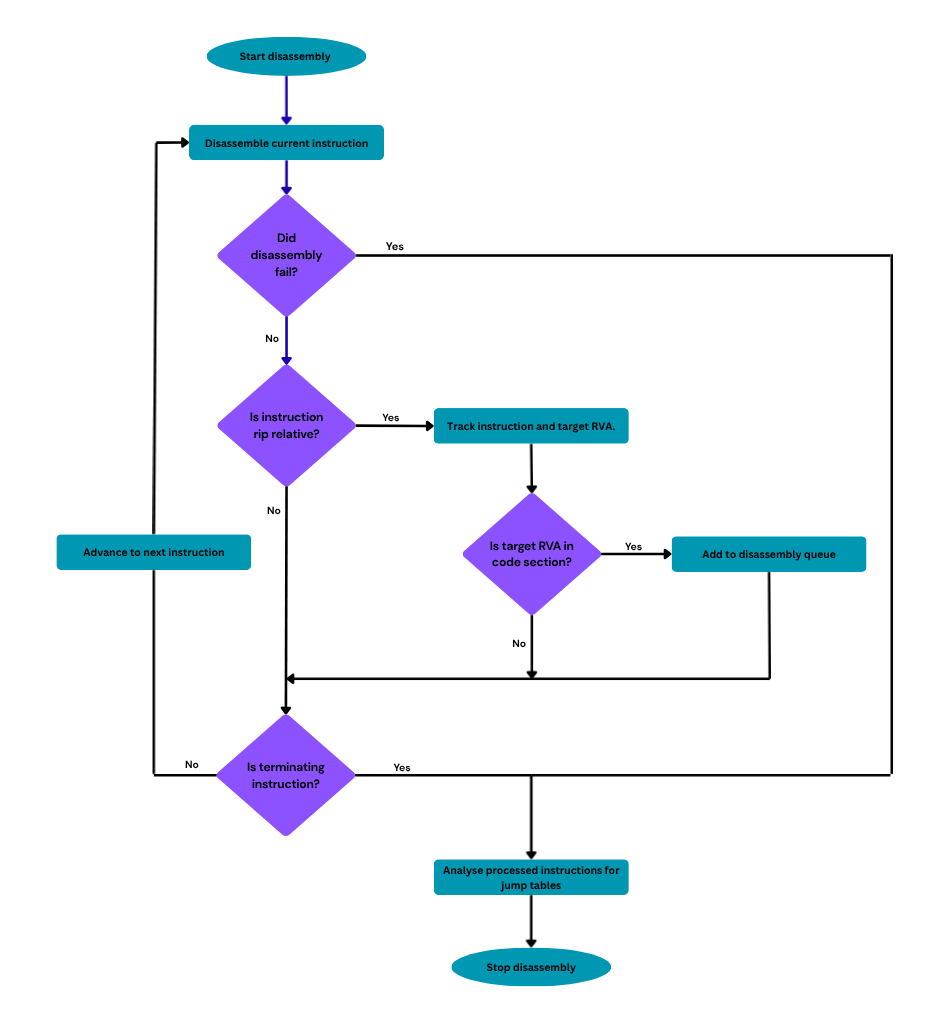
Figura 2. Processamento da desmontagem.
### 2.2.1 Divisão de blocos básicos
