 markoglasgow/gemma_crackme_tutorial
Tutorial passo a passo sobre como usar o modelo de IA local Gemma 4 E4B do Google para engenharia reversa de um crackme do Windows com Ghidra, incluindo configuração para inferência local e renomeação automatizada de funções/variáveis.

Estava brincando com o novo modelo local de pesos abertos Gemma E4B que o Google lançou e, para minha surpresa, obtive muito sucesso ao usá-lo para cenários locais offline de engenharia reversa. Queria escrever este tutorial para divulgar que a IA local já é boa o suficiente para muitas tarefas básicas de reversão, e que as coisas provavelmente vão melhorar rapidamente daqui para frente.
Uma das partes mais tediosas ao reverter um novo binário é logo no início, quando você não tem ideias sobre quais são as funções e variáveis importantes. Existem muitos truques que os reversores usam para começar, incluindo olhar referências a strings, diffing binário ou correspondência de funções semelhantes.
A IA é muito boa para ajudar aqui, e eu pessoalmente tive grande sucesso ao usar a API da OpenAI para anotar um binário ou limpar a saída do descompilador. No entanto, existem várias desvantagens em usar essas APIs:
Custo - Descompilação e desmontagem geram muitos tokens. As APIs cobram $ por token, então binários maiores podem exigir um bom $$$ para serem analisados. Se você estiver lidando com um alvo grande com muitos binários que são atualizados toda semana, esses custos podem aumentar rapidamente e são proibitivos para engenheiros reversos amadores.
Privacidade - Quando você usa uma API remota, o hospedeiro da IA tem conhecimento do que você está fazendo. Isso é um impeditivo em alguns cenários profissionais.
Controle - Quando você depende de uma API remota, não tem controle sobre quais modelos estão sendo servidos para você, ou qual a qualidade dos modelos. Se você depende deles para tarefas críticas, isso pode ser um problema quando eles ficam lentos ou saem do ar quando você precisa deles, ou quando a qualidade da saída deles degrada a ponto de se tornarem inúteis.
Executar seus próprios modelos de IA locais resolve alguns desses problemas:
Custo - Pode ser muito mais barato executar um modelo local do que depender de um serviço hospedado. Embora seu modelo local provavelmente seja menor e mais lento do que o de um bom provedor, se for bom o suficiente e rodar em um tempo razoável, pode fazer sentido economizar dinheiro executando seu próprio modelo, especialmente se você estiver processando grandes quantidades de dados para tarefas simples.
Privacidade - Quando você executa o modelo localmente, não há chamadas de rede acontecendo e você tem controle total sobre sua privacidade. Ninguém pode ver para que você está usando o modelo em sua própria máquina.
Controle - A beleza de um modelo de pesos abertos é que ninguém pode tirá-lo de você. OpenAI ou Anthropic podem um dia tornar seus modelos SotA indisponíveis, seja por aumentos de preço ou removendo explicitamente suas APIs. Mas com um modelo de pesos abertos, você está no controle do seu destino, para o bem ou para o mal.
Modelos de IA locais têm suas desvantagens:
Tamanho - Quanto maior o seu modelo, mais inteligente ele é. No entanto, a maioria dos modelos grandes não cabe em hardware de consumo. Por causa disso, se você está executando um modelo local, provavelmente está executando um modelo que é 10x a 100x menor que um modelo SotA (State-of-the-Art). Essa diminuição no tamanho leva diretamente a uma diminuição na inteligência do modelo, tornando-os inadequados para muitas tarefas que as pessoas consideram garantidas em modelos SotA como ChatGPT/Codex ou Claude.
Velocidade - Modelos locais provavelmente serão mais lentos em sua máquina do que ao usar uma API de IA. Novamente, isso se deve às limitações do hardware de consumo e a alguns dos truques que os provedores de API podem fazer e que geralmente não estão disponíveis para você.
Configuração - Executar modelos locais é como tentar rodar Linux em um laptop reformado vs entrar na loja da Apple e comprar um Macbook Air novo. A experiência do Codex e Claude Code é a experiência da loja da Apple em IA. A experiência do modelo de IA local é o cara de fedora na garagem batendo em um computador instável tentando fazê-lo funcionar. No mínimo, você precisa se preocupar com as seguintes coisas:
Não é uma jornada fácil, e muitas pessoas desistem e assumem que os modelos de IA locais não são adequados para a tarefa, porque nunca encontraram a combinação certa de hardware/modelo/configurações/prompt/harness para fazê-los funcionar para sua tarefa. Embora em muitos casos elas estejam certas, espero que este tutorial pelo menos ilumine o quão longe os modelos locais chegaram, como eles podem ajudar com engenharia reversa, e inspire as pessoas a dar uma chance à IA local.
(a senha do arquivo é crackmes.one). Hospedei um link alternativo aqui no repositório caso o link original saia do ar.
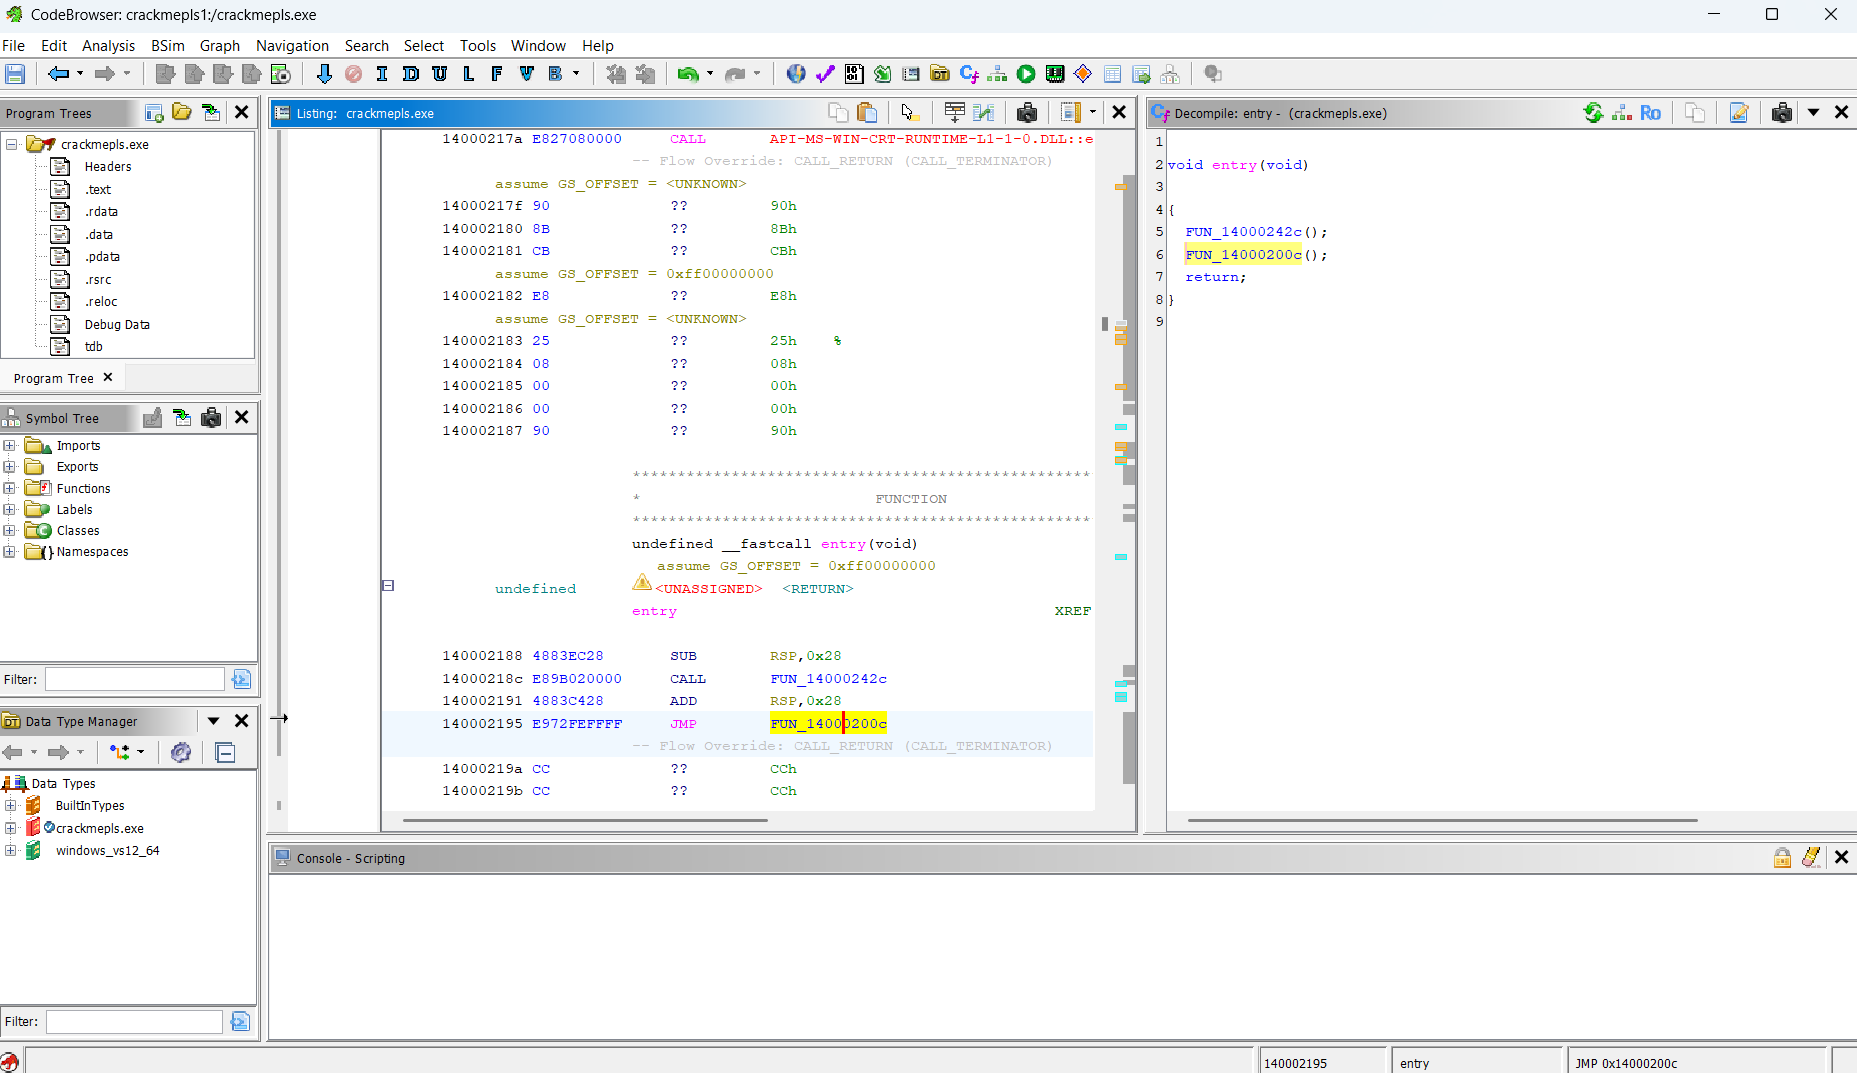
Ghidra 12.04 é usado para desmontagem e descompilação. Você precisará instalar OpenJDK 21 para usá-lo: https://github.com/nationalsecurityagency/ghidra
Enquanto trabalhava neste tutorial, codei com vibe (vibe-coding) com Claude Code um plugin para Ghidra para renomear funções e variáveis com IA. Você pode baixar o plugin aqui: https://github.com/markoglasgow/Ghidra_FastAIRenamer_Plugin
Para instalá-lo, basta mover o arquivo zip ghidra_12.0.4_PUBLIC_20260427_FastAIRenamerPlugin.zip para ${GHIDRA_HOME}\Extensions\Ghidra, então execute o Ghidra executando ${GHIDRA_HOME}\ghidraRun.bat. Para ativar o plugin, na tela inicial do Ghidra no menu superior selecione File -> Install Extensions, então no navegador de plugins marque a caixa ao lado de FastAIRenamerPlugin, então clique em Ok. O Ghidra solicitará que você reinicie, então faça isso imediatamente.
Para configurar o plugin, na próxima vez que o Ghidra iniciar, no menu superior vá para Tools -> Run Tool -> CodeBrowser. O Ghidra dirá "New Extensions detected. Would you like to configure them?". Clique em sim, novamente marque a caixa ao lado de FastAIRenamerPlugin, então clique em Ok. Quando o CodeBrowser abrir, no menu superior clique em Window -> Fast AI Renamer, então clique no botão Config. Aqui você poderá configurar seu modelo de IA. Feche a janela do plugin e a janela vazia do CodeBrowser quando terminar.
