 foxirain/linux-kernel-codex-harness
Harness de pesquisa de vulnerabilidades no kernel Linux orientado por evidências, utilizado na investigação da CVE-2026-31720


Ferramenta de Pesquisa · Importação Original: 3 de abril de 2026 · Revisão da Documentação: 11 de julho de 2026
Filosofia Central — Sinal Externo
Deixe que observações reproduzíveis fora da inferência do modelo orientem a atenção; nunca confunda prioridade com prova.
Status do projeto. Este repositório é uma versão inicial de um harness de pesquisa assistido por LLM que foi construído e usado para investigação real de vulnerabilidades no kernel Linux. Esta versão foi usada para descobrir a vulnerabilidade divulgada como CVE-2026-31720. O harness prioriza alvos de investigação, mas não prova vulnerabilidades automaticamente nem garante a segurança do kernel; a validação final e a divulgação são conduzidas por humanos.
Resumo— Explorar uma base de código tão grande quanto o kernel Linux diretamente com um LLM dispersa rapidamente o contexto e confunde facilmente a existência de APIs perigosas com a real explorabilidade. O Kernel Codex Harness define esse problema não como detecção automática de vulnerabilidades, mas como priorização de investigação e orquestração baseada em estado. Este projeto chama de Sinal Externo o princípio de controlar a atenção do modelo com observações reproduzíveis calculadas fora da inferência do LLM. Ele combina caminhos do kernel, fronteiras de userspace e sinais estáticos relacionados a lifetime, usercopy, refcount e tamanho, com inteligência opcional de crashes do syzbot, para ranquear arquivos candidatos e converter cada candidato em pacotes de prompt estreitos. A revisão manual e o autopilot baseado em orçamento de tempo usam o mesmo contrato de resposta e estado de sessão. Este harness foi usado em uma investigação real do kernel Linux para descobrir uma escrita fora dos limites (stack out-of-bounds write) no caminho de áudio do gadget USB, e essa falha foi divulgada como CVE-2026-31720. Esta implementação não é um analisador estático preciso, mas sim um workflow de pesquisa que usa heurísticas explicáveis para limitar o escopo da investigação do LLM; todos os achados exigem revalidação humana de reachability, quebra de invariante e impacto concreto.
Termos de Índice— kernel Linux, pesquisa de vulnerabilidades, sinal externo, orquestração de LLM, priorização heurística, syzbot, análise de programas, Codex.
A revisão de segurança do kernel Linux enfrenta dois tipos de problemas de escala. Primeiro, a árvore de fontes completa é grande demais para caber em um único contexto de LLM. Segundo, sinais como copy_from_user, alocadores, refcount e locks são comuns, mas não significam vulnerabilidades por si só. O analista deve primeiro decidir "onde olhar" e, em seguida, provar separadamente a reachability de userspace e as transições de estado concretas.
A filosofia central deste projeto é o Sinal Externo.
Não deixamos o LLM decidir sozinho onde olhar. Sinais reproduzíveis fora da inferência do modelo alocam a atenção, mas as conclusões sobre vulnerabilidades são determinadas apenas por evidências de reachability e invariantes.
Portanto, o harness não faz o modelo explorar vagamente o kernel inteiro. Ele prioriza arquivos, fornece apenas um ramo de investigação por vez e exige estrutura de evidências antes de conclusões.
Sinal Externo não é um julgamento gerado pelo LLM; é uma observação determinada antes da execução do modelo e recalculável a partir da mesma árvore de fontes, perfil e JSON do syzbot armazenado. Pesos de caminho, hits de regex e sobreposição com syzbot em cache se enquadram nisso. Esses sinais são usados apenas para ranquear candidatos e fornecer contexto de prompt; nunca são promovidos a veredito ou prova.
Neste documento, Sinal Externo refere-se à filosofia geral do projeto. O modelo de dados ExternalSignal no código atualmente representa apenas os sinais derivados do syzbot, portanto o escopo dos dois termos é diferente.
Hits de regex, caminhos de alto risco e sobreposição com syzbot são todos sinais para ordenar a investigação. Uma pontuação alta não constitui um achado de segurança se o caminho de chamada real, privilégios, config do kernel, namespace ou disponibilidade de dispositivo não permitirem o alcance do atacante.
A auditoria primeiro verifica as fronteiras iniciadas em userspace, como syscall, ioctl, netlink, procfs, filesystem, BPF e hooks de driver. Somente depois avalia classes de bug como UAF, OOB, refcount, race, vazamento de informação e verificações de capability.
Uma unidade de investigação é limitada, por padrão, a um arquivo e seus callers, teardown e caminhos de free próximos. Follow-ups manuais recomendados pelo modelo são permitidos no máximo duas vezes. Essa limitação não visa reduzir a capacidade de exploração, mas manter as conclusões dentro de um escopo verificável.
O prompt exige que um achado forte explique pelo menos os seguintes itens:
Se a evidência for insuficiente, o modelo retorna um único alvo para verificação em seguida, em vez de afirmar fortemente uma vulnerabilidade. Este é um contrato de evidência em nível de prompt; o parser atual não valida automaticamente a completude de cada evidência. Como a ingestão normaliza o veredito e o próximo alvo, a validação final da evidência é responsabilidade humana.
O fluxo inicial de investigação partiu das ideias de análise por arquivo, expansão limitada de contexto e saídas estruturadas usadas pelo vulnhuntr da Protect AI [1]. Neste projeto, essas ideias não foram aplicadas diretamente à análise de aplicações Python, mas redesenhadas em torno da superfície do kernel alcançável por userspace, do lifetime de objetos do kernel, dos caminhos de teardown e da sobreposição com syzbot. Em particular, separar sinais de priorização da prova de vulnerabilidade e verificar reachability antes da classe de bug são as escolhas centrais de design do harness para kernel.
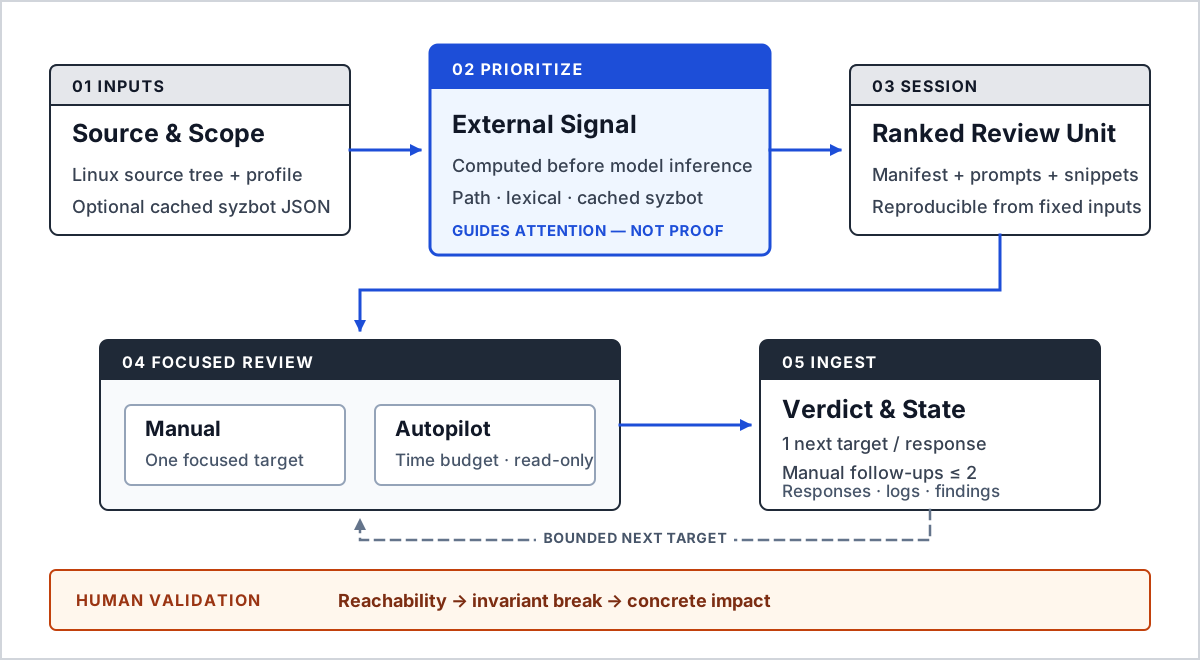
Fig. 1. A camada de Sinal Externo transforma observações calculadas antes da inferência do modelo em unidades de revisão ranqueadas. Ela aloca atenção, mas não estabelece prova de vulnerabilidade.
TABELA I — RESPONSABILIDADES DOS MÓDULOS PRINCIPAIS
