 advanced-threat-research/dotdumper
Um descompactador e registrador automático para arquivos direcionados ao DotNet Framework

Um descompactador e registrador automático para arquivos direcionados ao DotNet Framework! Esta ferramenta foi apresentada no Black Hat USA 2022. No Black Hat Asia 2023, foram publicados DotDumperGUI e DotDumperNative, juntamente com a versão 1.1-stable do DotDumper. Essas três ferramentas devem ser usadas em conjunto, onde o DotDumper 1.1-stable requer que as DLLs do DotDumperNative estejam presentes, enquanto o DotDumperGUI é uma interface gráfica para abrir e filtrar a saída JSON das execuções do DotDumper.
A detecção e classificação automática de qualquer arquivo de maneira confiável é frequentemente considerada o santo graal da análise de malware. As dificuldades para chegar lá são muitas, razão pela qual a criação de tal sistema é altamente valorizada. Quando se trata de binários direcionados ao DotNet, nossa nova ferramenta de código aberto, DotDumper, visa auxiliar em várias etapas cruciais ao longo do caminho: registrar atividades (em memória), despejar segmentos de memória interessantes e extrair características da amostra fornecida.
Em resumo, a descompactação manual é um processo tedioso que consome uma quantidade desproporcional de tempo dos analistas. Binários ofuscados aumentam ainda mais o tempo que um analista deve gastar para descompactar um determinado arquivo. Ao escalar isso, as organizações precisam de inúmeros analistas que dissecam malware diariamente, provavelmente em combinação com uma sandbox escalável. O valioso tempo perdido poderia ser usado para investigar campanhas ou amostras interessantes para descobrir novas ameaças, em vez do malware genérico e mundano que é amplamente disseminado. Afinal, os analistas procuram as poucas agulhas no palheiro.
Então, qual diferença o DotDumper faz? Executar uma amostra de malware baseada em DotNet através do DotDumper fornece arquivos de registro de chamadas de função cruciais, contextualizadoras e comuns em três formatos (texto simples legível por humanos, JSON e XML), além de cópias de segmentos úteis na memória. Dessa forma, um analista pode folhear o registro de chamadas de função. Além disso, os arquivos despejados podem ser escaneados para classificá-los, fornecendo informações adicionais sobre a amostra de malware e os dados que ela contém. Isso reduz o tempo vital para os processos de triagem e resposta a incidentes, e libera o tempo dos analistas de SOC e pesquisadores para necessidades de análise mais sofisticadas.
Para registrar e despejar as chamadas de função contextualizadoras e seus resultados, o DotDumper usa uma mistura de reflexão e hooks gerenciados, todos escritos em C# puro. Abaixo, os principais recursos serão destacados e elaborados, em combinação com trechos dos resultados do DotDumper de uma amostra do stealers AgentTesla empacotado, cujos hashes estão abaixo.
| Tipo de hash | Valor do hash |
|---|---|
| SHA-256 | b7512e6b8e9517024afdecc9e97121319e7dad2539eb21a79428257401e5558d |
| SHA-1 | c10e48ee1f802f730f41f3d11ae9d7bcc649080c |
| MD-5 | 23541daadb154f1f59119952e7232d6b |
O DotDumper é acessível através de uma interface de linha de comando, com uma variedade de argumentos. A imagem abaixo mostra o menu de ajuda. Observe que nem todos os argumentos serão discutidos, mas sim os mais usados.
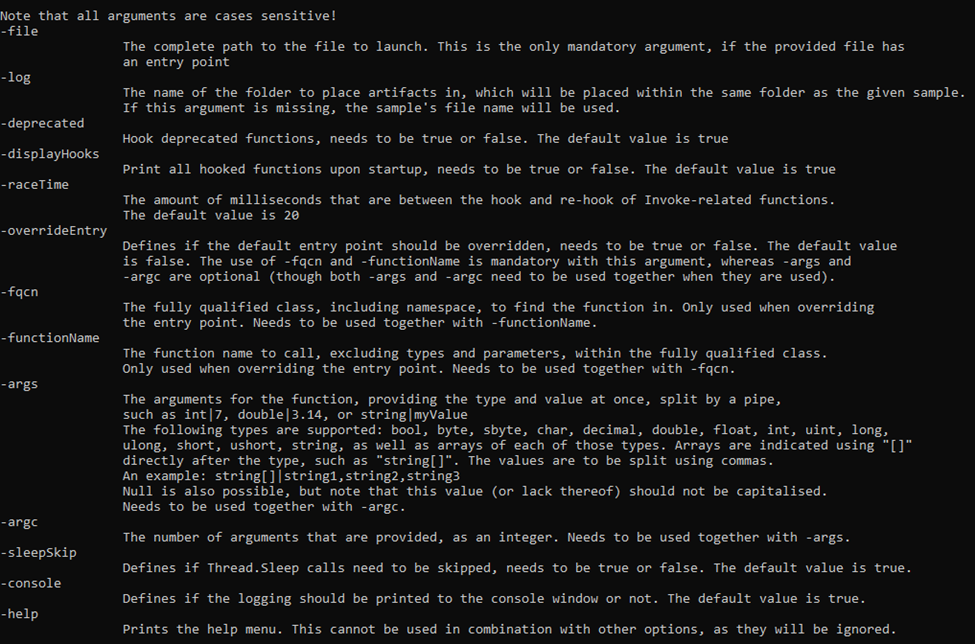
O requisito mínimo para executar uma amostra é fornecer o argumento "-file", juntamente com um nome de arquivo ou caminho de arquivo. Se um caminho completo for fornecido, ele será usado. Se um nome de arquivo for fornecido, o diretório de trabalho atual é verificado, bem como a pasta do executável do DotDumper.
A menos que um nome de diretório seja fornecido, o nome da pasta "-log" é definido igual ao nome do arquivo da amostra sem a extensão (se houver). A pasta está localizada na mesma pasta onde o DotDumper reside, onde os logs e arquivos despejados serão salvos.
No caso de uma biblioteca, ou de um ponto de entrada alternativo em um binário, deve-se substituir o ponto de entrada usando "-overrideEntry true". Além disso, é necessário fornecer a classe totalmente qualificada, que inclui o namespace, usando "-fqcn My.NameSpace.MyClass". Isso informa ao DotDumper qual classe selecionar, que é onde o nome da função fornecida (usando "-functionName MyFunction") é recuperado.
Se a função selecionada exigir argumentos, é necessário fornecer o número de argumentos usando "-argc" e o número de argumentos necessários. Os tipos e valores dos argumentos devem ser fornecidos como "string|myValue int|9". Observe que, quando espaços são usados nos valores, o argumento na interface de linha de comando precisa ser encapsulado entre aspas para garantir que seja passado como um único argumento.
Outras opções menos usadas, como "-raceTime" ou "-deprecated", são seguras em suas configurações padrão, mas podem exigir ajustes no futuro devido a mudanças no DotNet Framework. Elas estão atualmente expostas na interface de linha de comando para permitir alterações facilmente, se necessário, mesmo que se esteja usando uma versão mais antiga do DotDumper quando chegar a hora.
Registro e despejo são os dois recursos principais do DotDumper. Para minimizar o tempo que a análise leva, o registro deve fornecer contexto ao analista. Isso é feito fornecendo ao analista as seguintes informações para cada chamada de função registrada:
Observe que, para cada arquivo despejado, o nome do arquivo é igual ao hash SHA-256 do arquivo.
Para esclarecer o acima, um trecho de um log é fornecido abaixo. O trecho mostra os detalhes para a amostra AgentTesla mencionada, onde ela carrega o segundo estágio usando a função Assembly.Load do DotNet.

