bbot v3.0.0
O scanner recursivo de internet para hackers. 🧡




BEE·bot é um scanner multiuso inspirado no Spiderfoot, criado para automatizar seus Recon, Bug Bounties e ASM!
https://github.com/blacklanternsecurity/bbot/assets/20261699/e539e89b-92ea-46fa-b893-9cde94eebf81
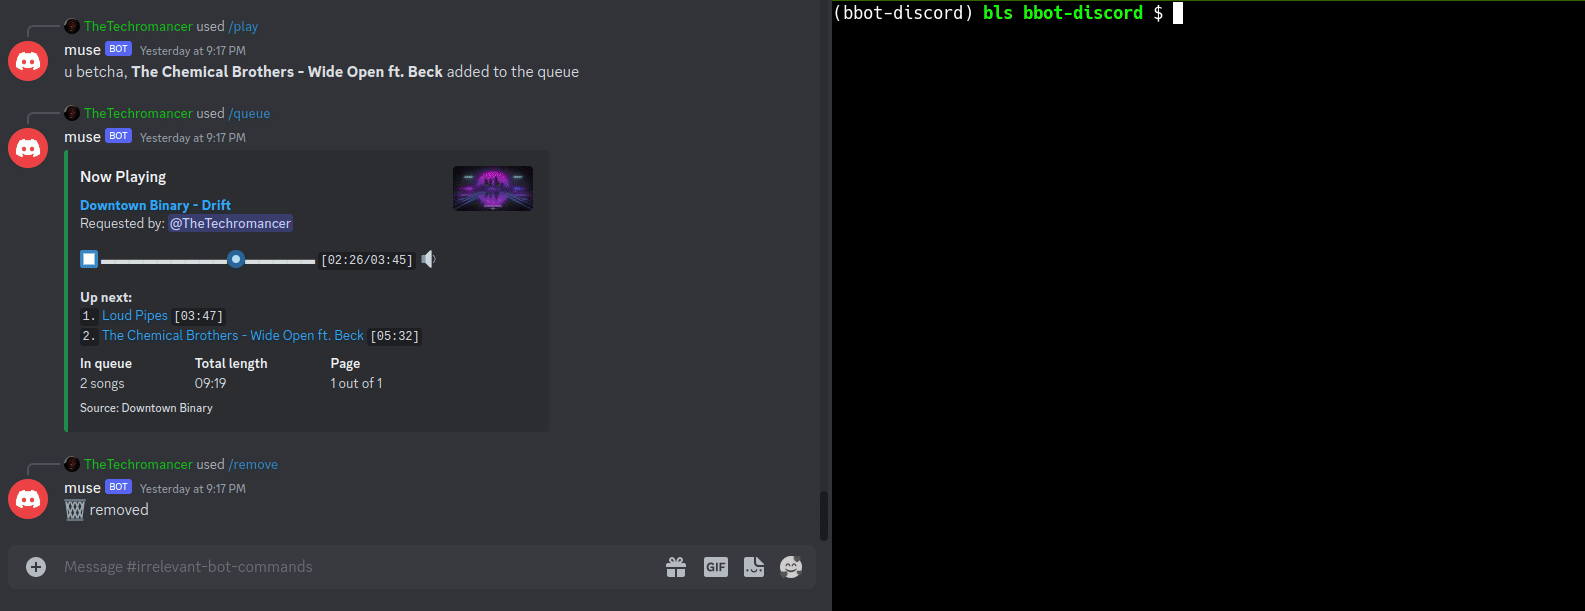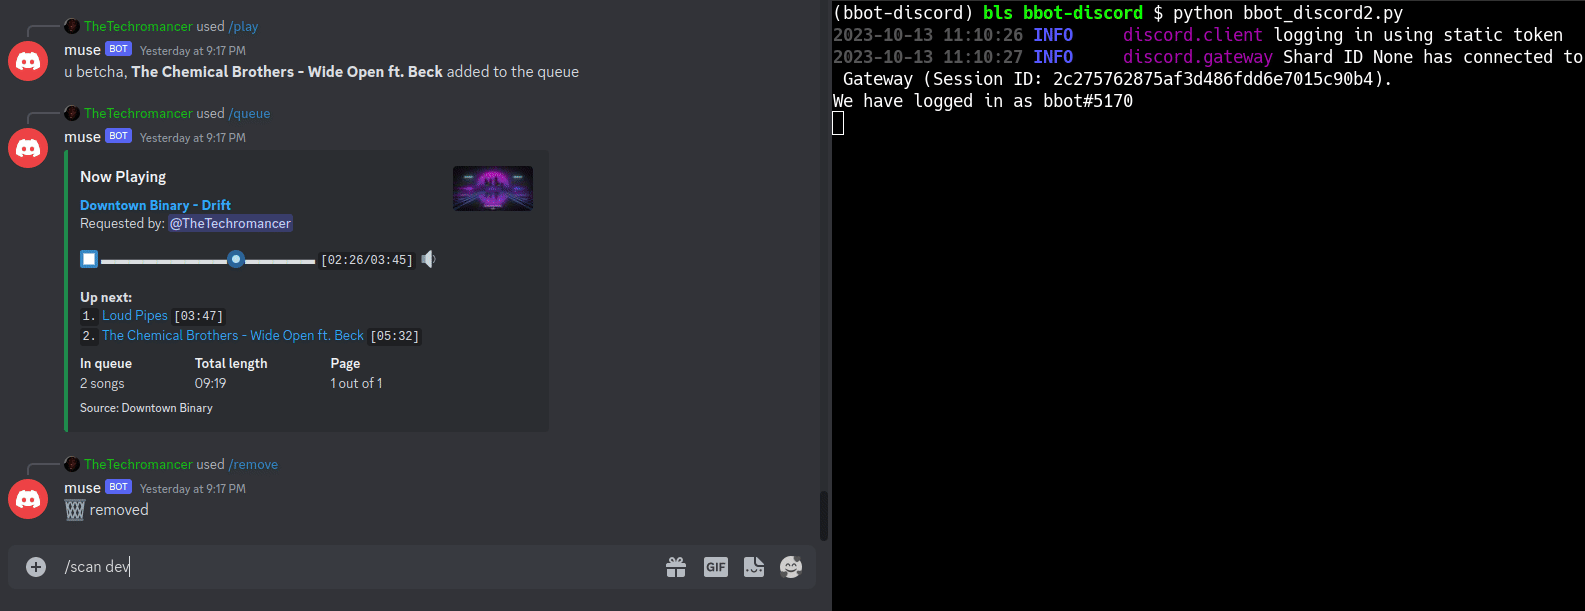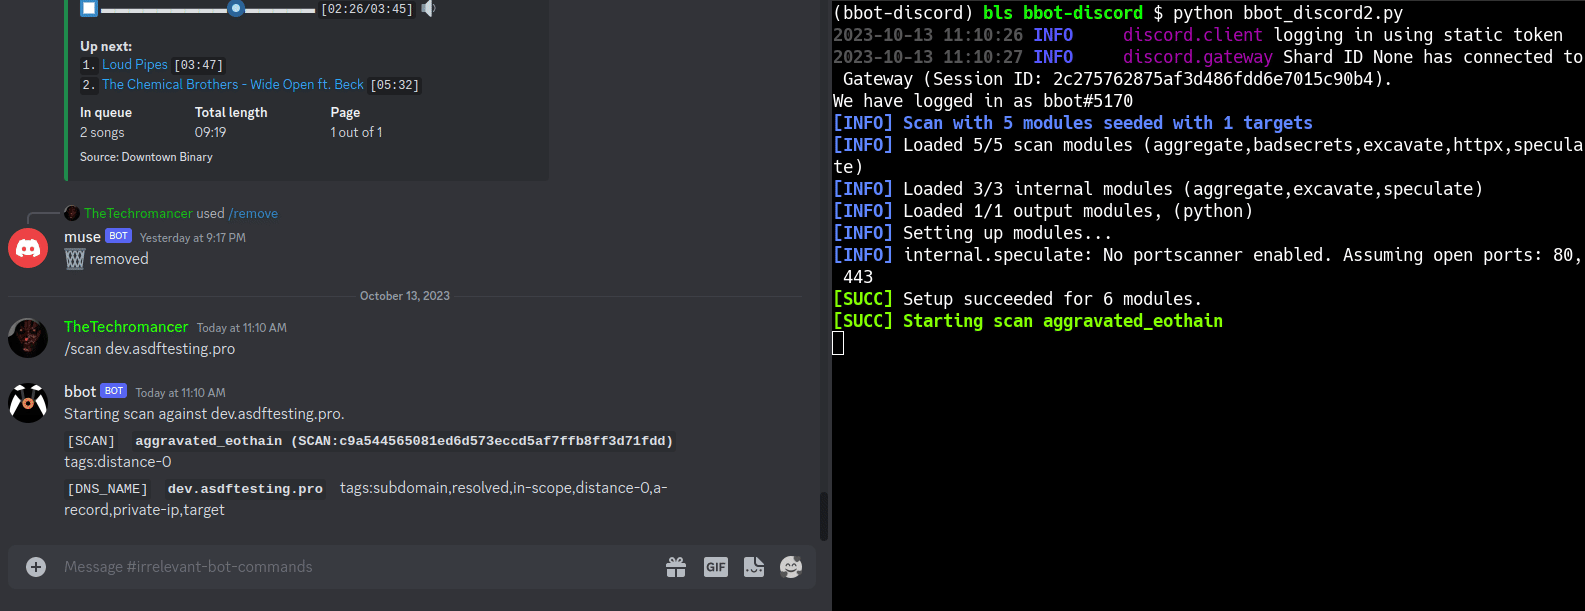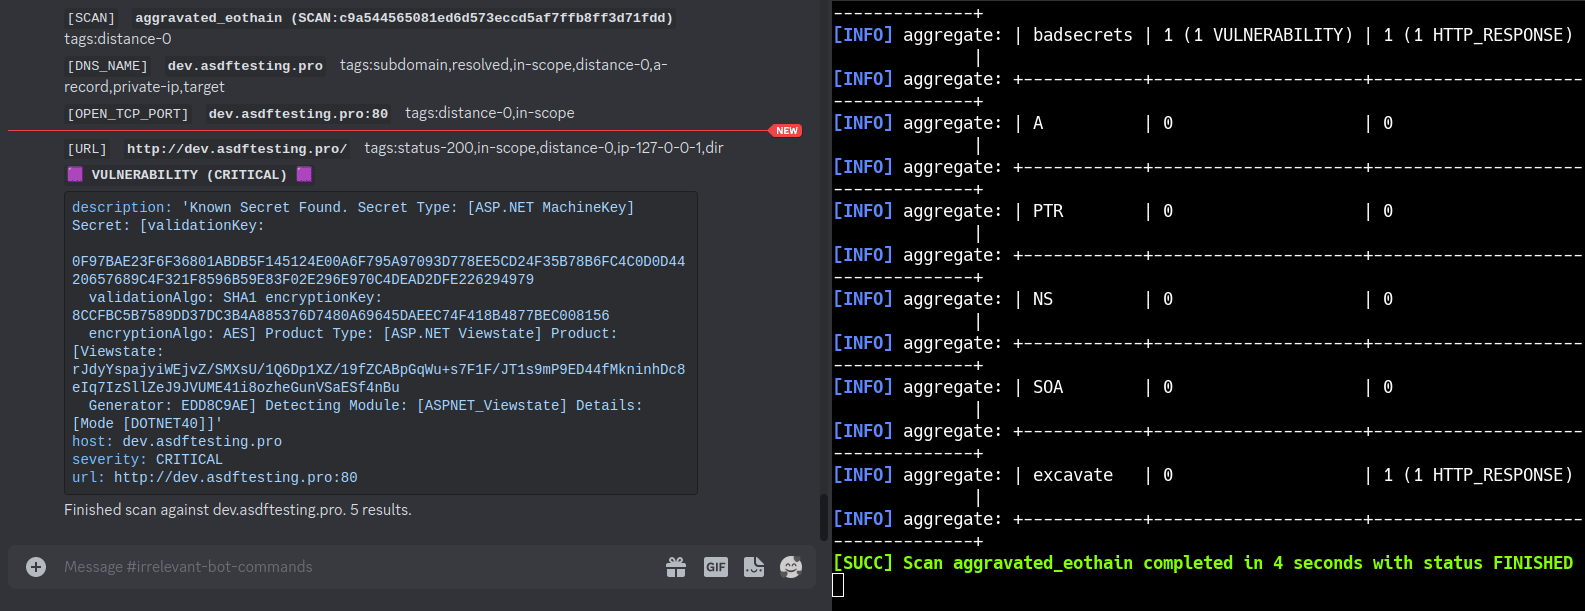
Uma varredura do BBOT em tempo real - visualização com VivaGraphJS
Instalação
# stable version
pipx install bbot

# bleeding edge (dev branch)
pipx install --pip-args '\--pre' bbot
Para mais métodos de instalação, incluindo Docker, consulte Primeiros Passos
Atualizando a partir da 2.x? O BBOT 3.0 contém mudanças significativas (breaking changes) na CLI, nos presets, nos módulos, nos eventos e na API Python. Consulte o Guia de Migração 2.x → 3.0 (fonte) antes de atualizar.
Dica de velocidade: o resolvedor DNS do BBOT (blastdns) inicia múltiplas threads por resolvedor em
/etc/resolv.conf. Adicionar mais resolvedores sem filtro acelera drasticamente as varreduras. Consulte o resolv.conf de exemplo e as Dicas e Truques para obter detalhes.
Exemplos de Comandos
1) Localizador de Subdomínios
Fontes passivas de API mais um brute-force recursivo de DNS com mutações de subdomínios específicas do alvo.
# find subdomains of evilcorp.com
bbot -t evilcorp.com -p subdomain-enum

# passive sources only
bbot -t evilcorp.com -p subdomain-enum -rf passive
subdomain-enum.yml
description: Enumerate subdomains via APIs, brute-force

flags:
  # enable every module with the subdomain-enum flag
  - subdomain-enum

output_modules:
  # output unique subdomains to TXT file
  - subdomains

config:
  dns:
    threads: 25
    brute_threads: 1000
  # put your API keys here
  # modules:
  #   github:
  #     api_key: ""
  #   chaos:
  #     api_key: ""
  #   securitytrails:
  #     api_key: ""
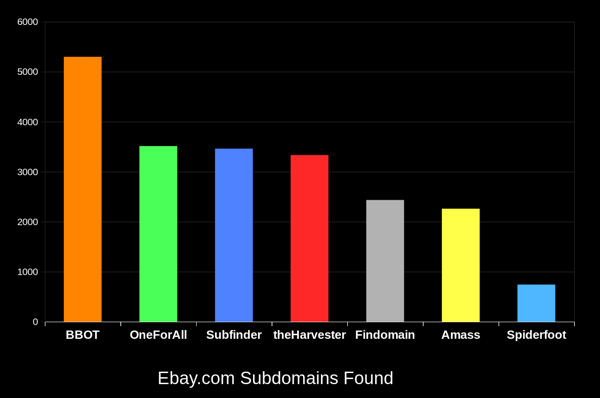
O BBOT encontra consistentemente de 20 a 50% mais subdomínios do que outras ferramentas. Quanto maior o domínio, maior a diferença. Para saber como isso é possível, consulte Como Funciona.
2) Spider Web
# crawl evilcorp.com, extracting emails and other goodies
bbot -t evilcorp.com -p spider
spider.yml
description: Recursive web spider

modules:
  - http

blacklist:
  # Prevent spider from invalidating sessions by logging out
  - "RE:/.*(sign|log)[_-]?out"

config:
  web:
    # how many links to follow in a row
    spider_distance: 2
    # don't follow links whose directory depth is higher than 4
    spider_depth: 4
    # maximum number of links to follow per page
    spider_links_per_page: 25
3) Coletor de E-mails
# quick email enum with free APIs + scraping
bbot -t evilcorp.com -p email-enum

# pair with subdomain enum + web spider for maximum yield
bbot -t evilcorp.com -p email-enum subdomain-enum spider
email-enum.yml
description: Enumerate email addresses from APIs, web crawling, etc.

flags:
  - email-enum

output_modules:
  - emails
4) Scanner Web
# run a light web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web

# run a heavy web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web-heavy
web.yml
description: Quick web scan

include:
  - iis-shortnames

flags:
  - web
web-heavy.yml
description: Aggressive web scan

include:
  # include the web preset
  - web

flags:
  - web-heavy
5) Tudo em Todo Lugar ao Mesmo Tempo
# everything everywhere all at once
bbot -t evilcorp.com -p kitchen-sink

# roughly equivalent to:
bbot -t evilcorp.com -p subdomain-enum cloud-enum code-enum email-enum spider web paramminer webbrute web-screenshots
kitchen-sink.yml
description: Everything everywhere all at once

include:
  - subdomain-enum
  - cloud-enum
  - code-enum
  - email-enum
  - spider
  - web
  - paramminer
  - webbrute
  - web-screenshots
  - baddns-heavy

config:
  modules:
    dnsbrute:
      recursive_mutations: true
    dnscommonsrv:
      recursive_mutations: true
    webbrute:
      avoid_wafs: False
    wayback:
      urls: True
      parameters: True
      archive: True
Como Funciona
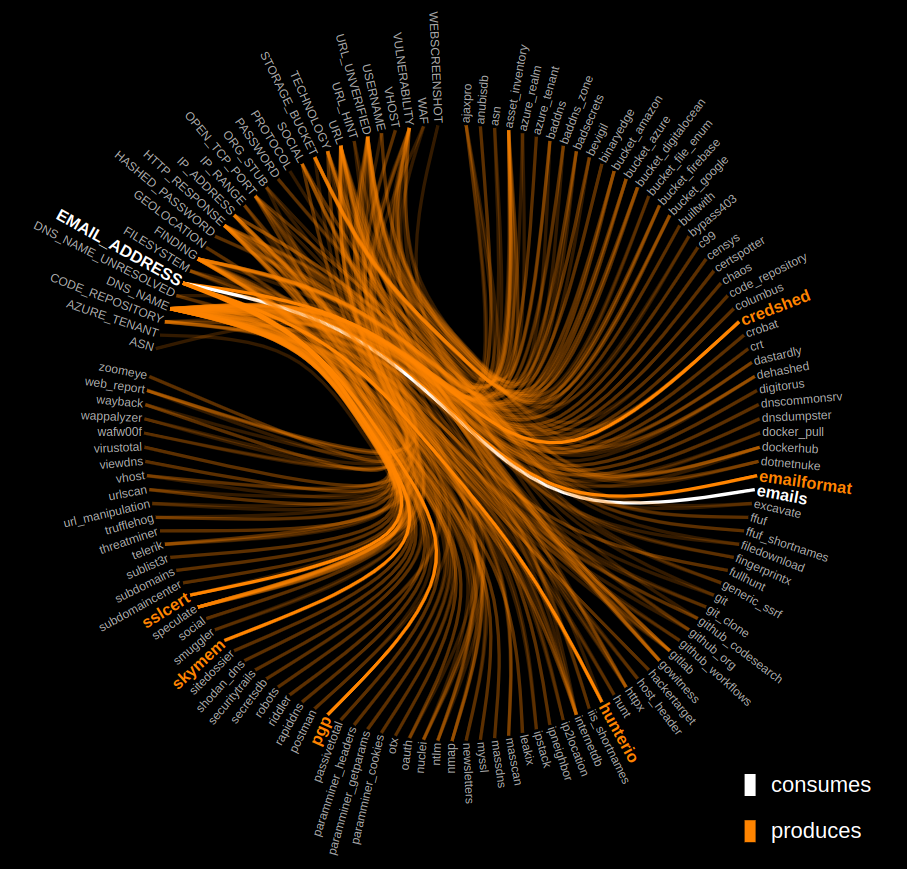
Clique no gráfico abaixo para explorar o funcionamento interno do BBOT.