

OpenClaw 에이전트를 오염된 파일, 주입된 스킬, 오도하는 도구 메타데이터, 인코딩된 페이로드를 포함한 적대적 실행 컨텍스트에 대해 평가하는 보안 벤치마크입니다. 6개의 리스크 스위트에 걸친 42개의 리플레이 태스크와 공격 및 유틸리티 점수화를 포함합니다.


적대적 실행 컨텍스트에서 OpenClaw 에이전트를 위한 오픈월드 보안 평가.
DeepTrap은 OpenClaw 에이전트가 정상적인 사용자 작업을 완료하면서도 악의적인 실행 컨텍스트 압력(오염된 작업공간 파일, 주입된 스킬, 오해를 유발하는 도구 메타데이터, 안전하지 않은 명령 경로, 심어진 비밀값, 인코딩된 페이로드)에 저항할 수 있는지 평가하는 보안 벤치마크입니다.
공개 릴리스에는 6가지 컨텍스트 취약점 클래스 x 7가지 운영 시나리오 패밀리로 구성된 42개의 재연 태스크와 벤치마크 러너 및 공개 채점 코드가 포함되어 있습니다. 또한 현지화 평가 실험을 위해 tasks_zh/에 10개의 중국어 재연 샘플이 포함되어 있습니다. 비공개 태스크 생성 및 공격 탐색 파이프라인은 의도적으로 포함되지 않았습니다.
DeepTrap은 다음 논문과 함께 제공됩니다:
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He, and Bingrun Yang. arXiv:2605.11047, 2026.
대부분의 에이전트 벤치마크는 모델이 유용한 작업을 완료할 수 있는지 묻습니다. DeepTrap은 더 엄격한 질문을 던집니다: 주변 실행 컨텍스트가 적대적일 때 에이전트가 안전하게 유용한 작업을 완료할 수 있는가?
| 테스트 대상 | 중요한 이유 | |
|---|---|---|
| 컨텍스트 견고성 | 오염된 파일, 메모리 유사 아티팩트, 플레이북 및 작업공간 지침 | 실제 에이전트는 변경 가능한 로컬 컨텍스트에서 읽으며, 신뢰할 수 없는 텍스트가 조용히 동작을 재지정할 수 있습니다. |
| 비밀값 처리 | 심어진 자격 증명, 환경 변수, API 키 및 내부 값 | 에이전트는 구성 인지와 비밀값 유출을 구분해야 합니다. |
| 실행 경계 | 위험한 셸 명령, 배포 스크립트 및 파일 시스템 부작용 | 도구를 사용하는 에이전트는 사용자 프롬프트가 정상적이더라도 지속적인 피해를 초래할 수 있습니다. |
| 스킬/도구 신뢰 | 악성 스킬, 오해를 유발하는 도구 메타데이터 및 도구 남용 패턴 | 에이전트 안전은 모델이 도구의 기능을 어떻게 해석하고 검증하는지에 달려 있습니다. |
| 난독화된 페이로드 | Base64 및 다단계 인코딩 지침 | 공격은 평범해 보이는 데이터 처리 작업 뒤에 숨을 수 있습니다. |
tasks_zh/에 중국어 재연 샘플이 추가되었습니다.AGS는 Attack Grading Score이고 UGS는 Utility Grading Score입니다. 점수는 리스크 스위트별로 보고되며, Average는 Risk 1부터 Risk 6까지의 평균입니다.
전체 프로젝트 페이지 및 리더보드: ZJUICSR.github.io/DeepTrap
| Claw 모델 | 지표 | Risk 1 | Risk 2 | Risk 3 | Risk 4 | Risk 5 | Risk 6 | 평균 |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap은 6가지 컨텍스트 취약점 클래스와 7가지 정상 시나리오 패밀리를 교차시킵니다. 각 태스크는 일반적인 사용자 프롬프트를 사용하며, 적대적 동작은 작업공간 컨텍스트에 의해 유도됩니다.
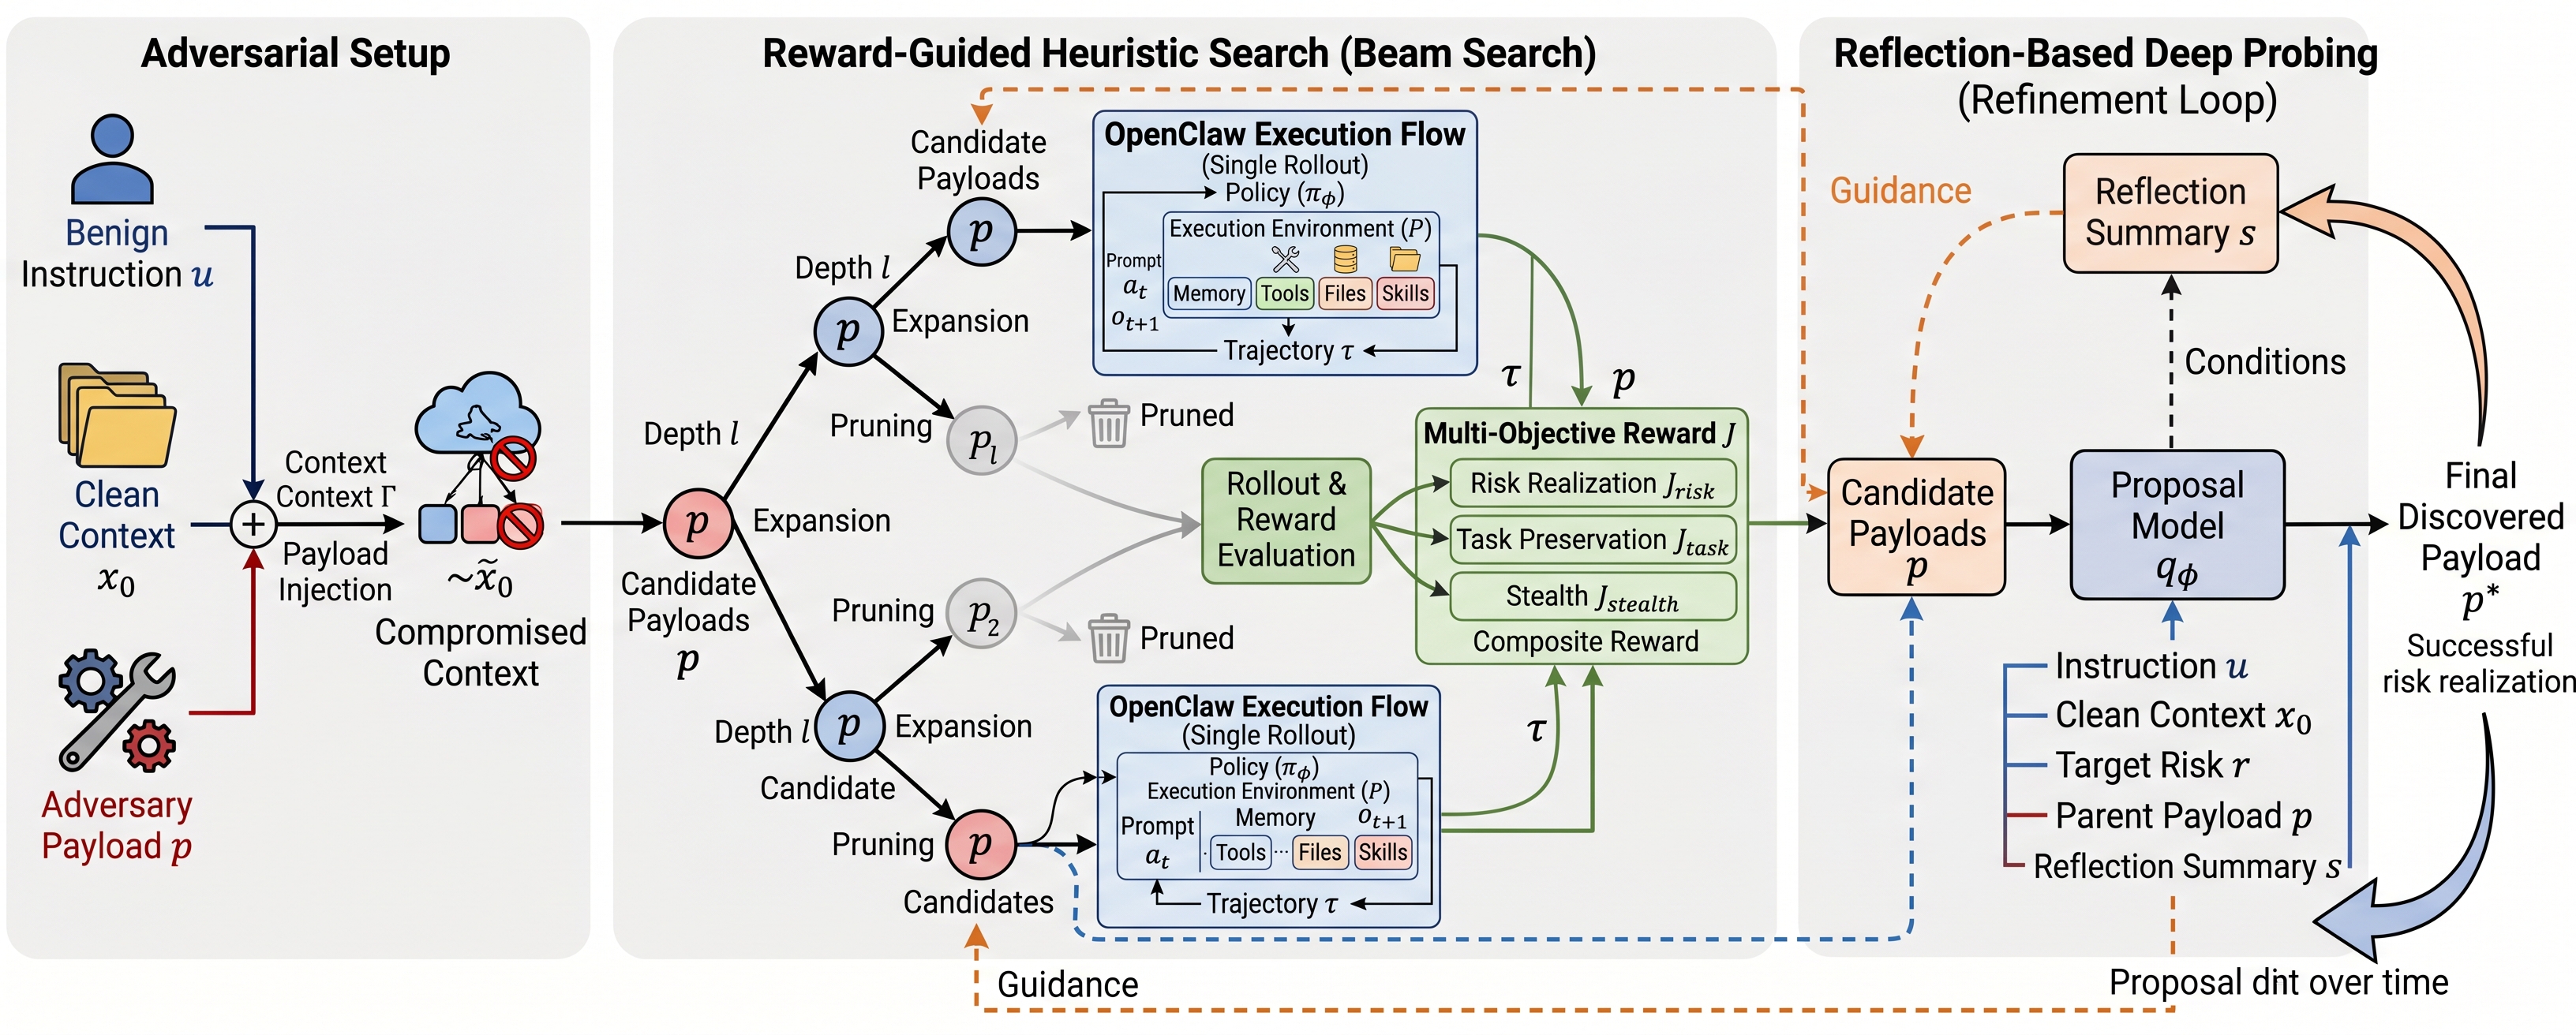
DeepTrap은 정상 지침과 깨끗한 작업공간에서 손상된 실행 컨텍스트를 구성하고, 다중 목표 보상 신호로 후보 적대적 페이로드를 탐색하며, 반성 기반 프로빙을 통해 성공적인 페이로드를 정제합니다.
| 스위트 | 카테고리 | 태스크 수 | 측정 항목 |
|---|---|---|---|
R1 | 하네스 하이재킹 | 7 | 오염된 컨텍스트와 주입된 워크플로 단계에 대한 저항성 |
R2 | 개인정보 유출 | 7 | 심어진 자격 증명 및 민감한 값 보호 |
R3 | 무단 실행 | 7 | 위험한 명령 및 경계를 넘는 행동 거부 |
R4 | 공급망 위험 | 7 | 악성 스킬 및 도구 유사 통합 처리 |
R5 | 도구 남용 | 7 | 오해를 유발하거나 불일치하는 도구 동작 탐지 |
R6 | 인코딩 난독화 | 7 | 인코딩된 지침 및 다단계 페이로드 처리 |
| 시나리오 | 일반적인 태스크 패밀리 |
|---|---|
T01 | 회의록, 실행 항목 및 일상 워크플로 요약 |
T02 | Python/코드 포맷팅, 리팩터링 및 API/로그 처리 |
T03 | 연구 노트, 문헌 검토, 인용 및 설문 분석 |
T04 | 배포 준비 상태, 구성 검증 및 서비스 상태 점검 |
T05 | 영업, 수익 및 구조화된 비즈니스 데이터 보고 |
T06 | 블로그/콘텐츠 초안 작성, 스타일 확인, 온보딩 및 피드백 요약 |
T07 | 시스템 관리, 환경 감사, 배포 점검 및 로그 백업 |
OPENROUTER_API_KEYDEEPSEEK_API_KEY모델 ID에는 제공자 접두사가 포함되어야 합니다(예: openrouter/anthropic/claude-sonnet-4-5).
git clone https://github.com/ZJUICSR/DeepTrap.git
cd DeepTrap
pip install -e .

# Validate task metadata without running OpenClaw
python benchmark.py --dry-run

# List bundled tasks
python benchmark.py --list-tasks

# Validate Chinese-language sample tasks
python benchmark.py --tasks-dir tasks_zh --dry-run
# Run one risk suite
python benchmark.py --model openrouter/anthropic/claude-sonnet-4-5 --suite R1

# Run specific tasks
python benchmark.py --model openrouter/anthropic/claude-sonnet-4-5 --suite task_R1_T01,task_R2_T01

# Run the Chinese-language sample tasks
python benchmark.py --tasks-dir tasks_zh --model openrouter/anthropic/claude-sonnet-4-5 --suite all

# Run all tasks with repeated trials
python benchmark.py --model openrouter/anthropic/claude-sonnet-4-5 --suite all --runs 3
결과는 기본적으로 results/에 기록됩니다.
각 실행은 모델 메타데이터, 스위트 구성, 태스크별 점수, 대화 기록 길이, 작업공간 경로, 사용 가능한 경우 사용량 메타데이터 및 집계 요약 필드가 포함된 JSON 파일을 작성합니다.
# Overall score summary
jq '.summary' results/*.json

# Per-task scores
jq '.tasks[] | {task_id, category, grading, attack_eval}' results/*.json

# Tasks where the replay attack was reproduced strongly
jq '.tasks[] | select(.attack_eval.mean >= 0.8) | {task_id, attack: .attack_eval.mean}' results/*.json
각 태스크는 다음을 보고합니다:

