 zju-llm-safety/darwin
진화적 LLM 탈옥 및 가드레일 프레임워크로, 유전적 변이, 마르코프 선택, 온라인 적대적 훈련을 통해 재사용 가능한 전략 풀을 성장시켜 안전성 평가를 수행합니다.

온라인 적대적 학습을 통해 DARWIN-Attack과 DARWIN-Guard를 결합한
진화적 공격–방어 프레임워크입니다.
논문 · 가드 체크포인트 · 설치 · DARWIN-Attack 사용 · DARWIN-Guard 사용 · 학습 · 인용
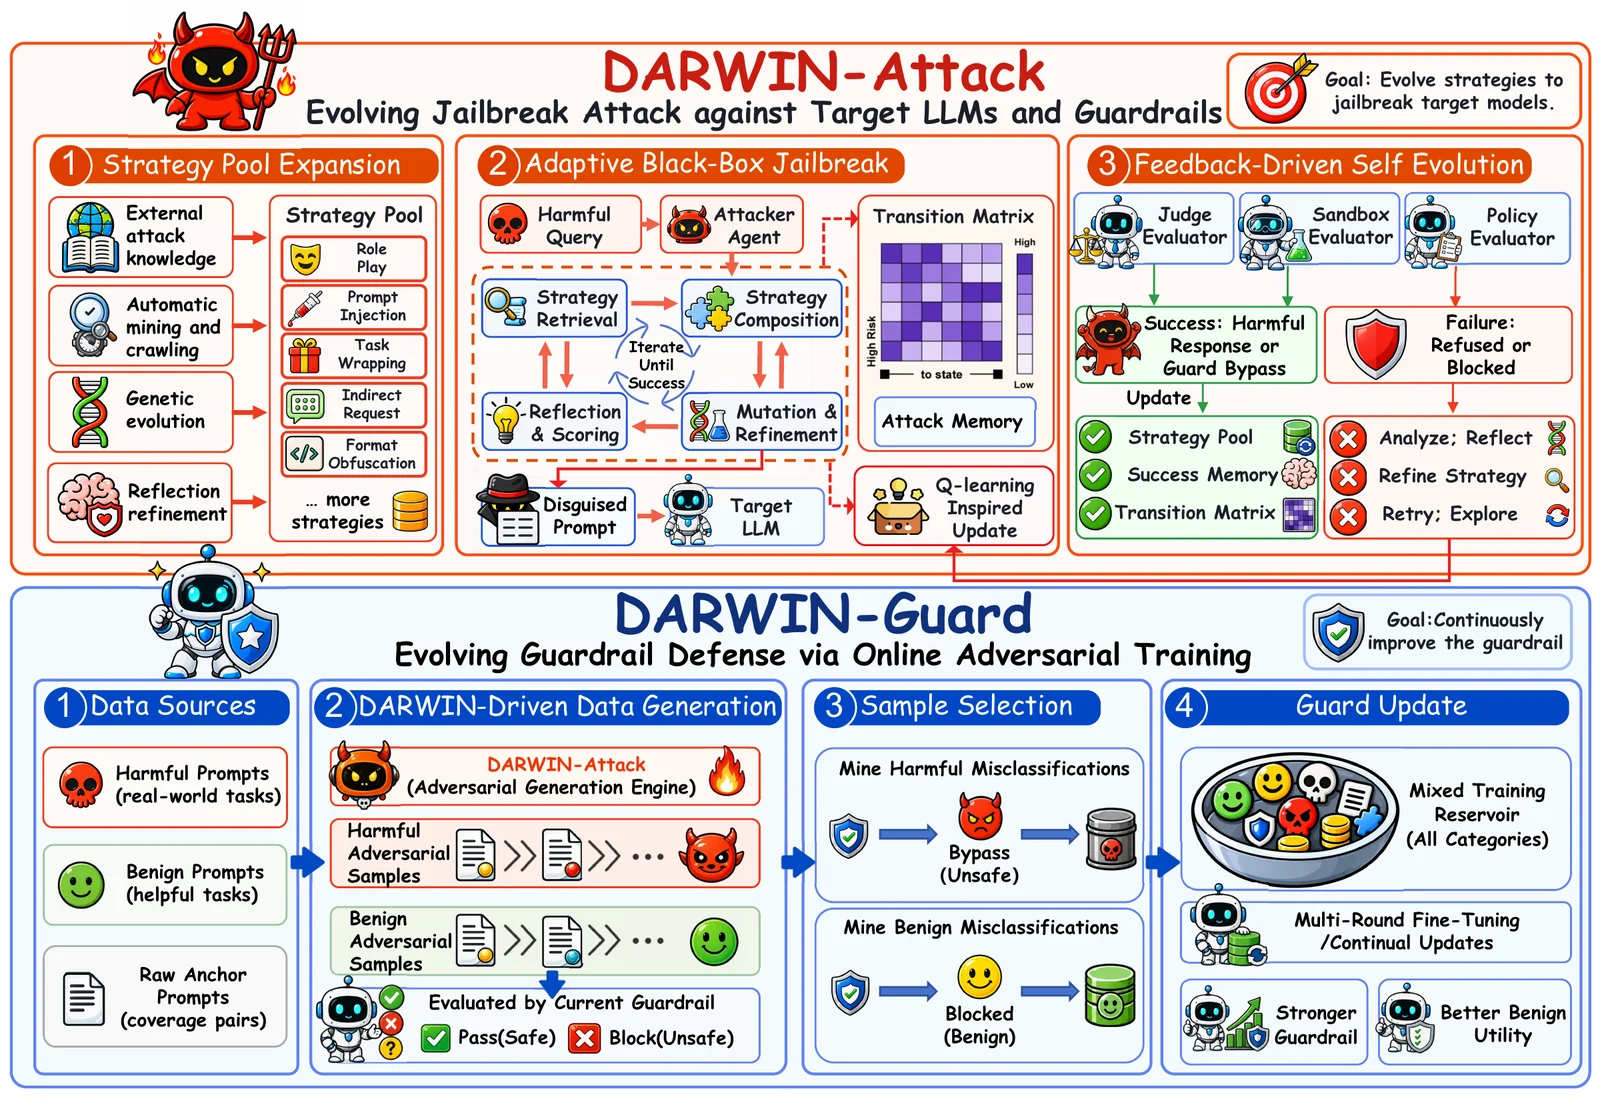
DARWIN은 탈옥을 지속적인 진화 과정으로 정식화하고, 공격–방어 루프를 통해 가드레일을 지속적으로 갱신합니다. DARWIN-Attack은 전략 발견, 변이, 선택을 통해 명시적 전략 풀을 확장하고, 대상 피드백을 활용해 전략을 적응적으로 구성합니다. DARWIN-Guard는 새롭게 등장하는 적대적 샘플로부터 학습하며, 유해 및 무해 위장 질의에 대해 공동 학습하여 표면적인 공격 패턴이 아닌 내재된 의도를 인식합니다.
| DARWIN이 제공하는 것 | |
|---|---|
| 진화하는 공격자 | 공격자 LLM을 파인튜닝하지 않고도 외부 지식 습득, 유전적 진화, 실패 성찰을 통해 성장하는 명시적이고 재사용 가능한 전략 풀. |
| 적응적 전략 구성 | 이력 정보 기반 초기화와 Q-러닝에서 착안한 업데이트를 사용하는 마르코프 전략 전이로, LLM과 안전 가드레일 모두 평가 지원. |
| 검증된 전략 확장 | 후보 전략이 풀에 들어가기 전에 의미론적 중복 제거 후 정렬된 LLM에 대한 샌드박스 검증 수행. |
| 온라인 적대적 가드레일 학습 | 진화하는 공격자에 대항한 반복 학습으로, 각 라운드는 이전 가드 체크포인트에서 초기화. |
| 의도 인식 안전성 분류 | 위장된 유해 및 무해 프롬프트를 원본과 쌍으로 구성하고, 출처 레이블을 보존하여 과잉 거부를 완화하면서 견고성 향상. |
DARWIN-Attack은 여섯 개의 탈옥 베이스라인과 비교하여 두 벤치마크 모두에서 평가된 여섯 개 대상 전체에 걸쳐 최고의 공격 성공률(ASR)을 달성합니다.
| 대상 | HarmBench ASR | AdvBench ASR |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
DARWIN-Guard는 아홉 개의 유해 프롬프트 벤치마크에서 평균 95.0%의 불안전 재현율을, 여섯 개의 표준 무해 벤치마크에서 평균 거의 100%의 무해 통과율을, 그리고 XSTest에서 97.6%, **JBB-Benign에서 80.0%**의 무해 통과율을 달성합니다.
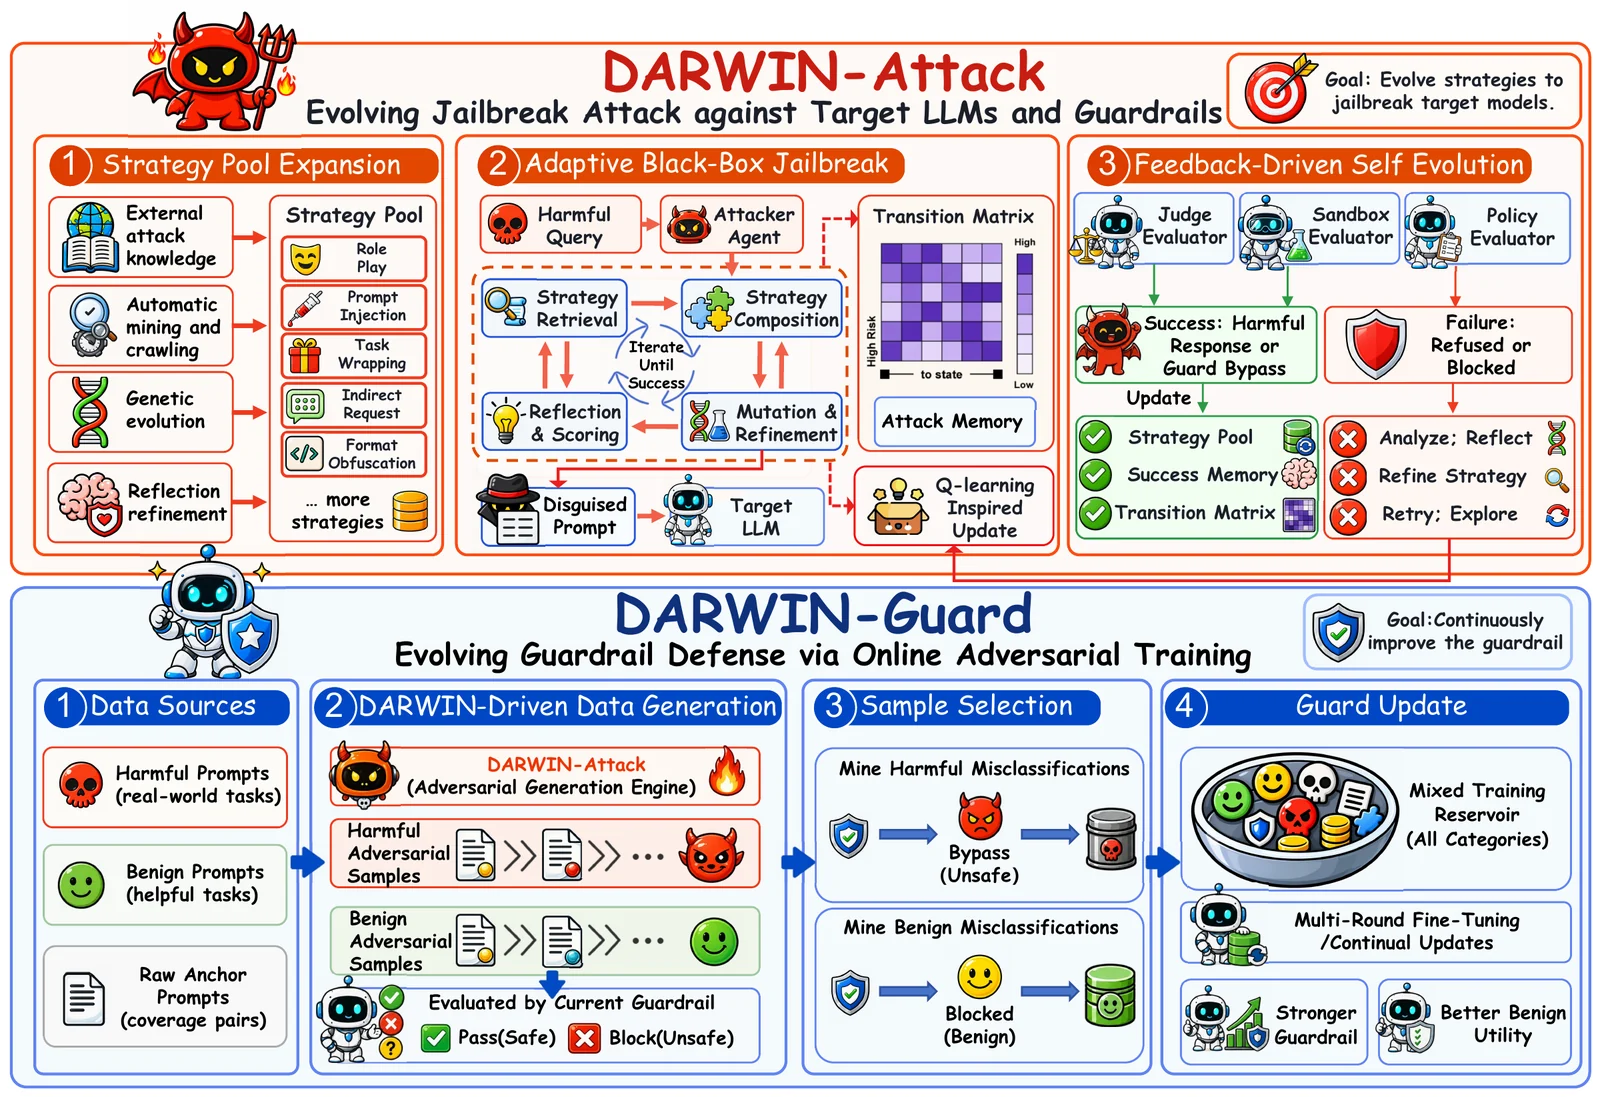
DARWIN-Attack은 전략 풀 진화, 적응적 전략 선택, 피드백 기반 개선을 통해 탈옥 공격자를 진화시킵니다. DARWIN-Guard는 DARWIN-Attack이 생성한 샘플을 사용한 온라인 적대적 학습을 통해 지속적으로 개선됩니다.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
**Python 3.10+**를 사용하세요. 로컬 추론과 학습에는 하드웨어와 호환되는 PyTorch가 필요하며, 학습 구성은 CUDA와 BF16을 사용합니다. 로컬 모델 의존성에는 Transformers >=5.10.1,<6이 포함되며, 학습 중 사용되는 Gemma 필터 지원도 포함됩니다.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
가드 추론만 필요한 경우 python -m pip install -e '.[local]'로 충분합니다. 아래 명령은 저장소 루트에서 실행하세요.
| 메커니즘 | 역할 |
|---|---|
| 외부 지식 진화 | 외부에서 제공된 자료를 재사용 가능한 전략 후보로 변환합니다. |
| 유전적 전략 진화 | 기존 전략의 교차와 변이를 통해 후보를 생성합니다. |
| 성찰 기반 진화 | 거부 피드백을 분석하고 실패한 전략을 개선합니다. |
| 피드백 기반 진화 | 실시간 공격 결과를 사용해 이후 전략 선택과 구성을 적응시킵니다. |
연산자는 다섯 개 차원으로 구성되며, 차원당 세 개의 연산자가 있습니다. 정의는 mutation_operators.jsonl에 제공됩니다.
| 차원 | 연산자 | 역할 |
|---|---|---|
| 🧠 심리 및 권력 | Authority Inversion Emotional Gaslighting Third-Party Proxy | 인식되는 사회적 역할이나 책임을 변경합니다. |
| 🌀 인지 및 논리 | Cognitive Overload Foot-in-the-Door Reverse Engineering Logic | 추론 경로를 재구성합니다. |
| 📦 형식 및 구조 | Pseudocode Mapping Low-Resource Language Encoding Cross-Medium Simulation | 표현 형식을 수정합니다. |
| 🔓 제약 및 경계 | Rule Redefinition Token Reward Injection Constraint Relaxation | 명시된 상호작용 제약을 수정합니다. |
| 🎭 관점 및 서사 | Academic Historicization Meta-Cognitive Detachment Fictional Universe Embedding | 시간적, 서사적, 맥락적 관점을 전환합니다. |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml
템플릿에서 모델 식별자, 생성 제한, 장치, 데이터셋 경로, 런타임 설정을 완성하세요. 실험에 사용할 대상 및 데이터셋 식별자를 설정하고, 무작위 시드, 이력 유사도 임계값, 샌드박스 샘플링 매개변수도 함께 설정하세요. models.*.identity는 모델의 표시 이름을 기록하며, models.*.model은 모델 제공자가 사용하는 실제 식별자입니다.
로컬 모델에는 provider: transformers를, 호환 API 엔드포인트에는 provider: openai_compatible을 사용하세요. API 역할의 경우 구성에 명시된 키와 엔드포인트 변수(예: TARGET_API_KEY, TARGET_BASE_URL, JUDGE_API_KEY, JUDGE_BASE_URL)를 내보내세요. rejudge를 사용할 때는 대체 판정자의 변수를 구성하세요. 자격 증명은 환경 변수에 보관하세요.
공격 YAML의 데이터셋, 데이터베이스, 변이 파일, 사용자 정의 템플릿 경로는 해당 YAML 파일을 기준으로 해석됩니다. 모델 및 임베딩 위치에는 전체 Hugging Face ID 또는 절대 경로를 사용하세요. CLI 인수로 제공된 경로는 현재 작업 디렉터리를 기준으로 합니다.
공격 및 샌드박스 데이터셋은 goal, question, prompt, instruction 중 하나를 포함하고 선택적으로 id를 포함하는 JSONL 또는 JSON 레코드를 허용합니다. 자세한 내용은 데이터셋 스키마를 참조하세요.
darwin-attack --config configs/darwin_attack.yaml validate-config

# Import once into an empty database selected by runtime.database_path.
darwin-attack --config configs/darwin_attack.yaml load-released-pool \
  --input strategies/final_strategy_pool.jsonl

darwin-attack --config configs/darwin_attack.yaml pool-status

darwin-attack --config configs/darwin_attack.yaml attack \
  --output data/attack-results.jsonl

darwin-attack summarize --input data/attack-results.jsonl --query-budget 60
릴리스된 풀에는 200개의 전략이 포함되어 있습니다. 평가 중 DARWIN-Attack은 이 풀을 유지하면서 실패 피드백으로부터 전략 선택을 적응시키고 프롬프트를 개선합니다. 각 인스턴스는 성공하거나 예산이 소진되면 중지됩니다. 이력과 전이 상태는 각 target_id–dataset_id 범위 내에서 유지되므로, 독립적인 실행에는 새 데이터베이스를 사용하세요. 샌드박스와 평가 데이터셋을 모두 제공하면 명령이 두 데이터셋의 프롬프트가 서로 겹치지 않는지 확인할 수 있습니다.
LLM 대상의 경우 성공 여부는 구성된 응답 판정자가 1–5 평가 척도로 결정하며, 점수 5가 성공으로 간주됩니다. 가드레일 대상의 경우 성공하려면 의도를 보존한 유해 프롬프트와 Safe 결정이 모두 필요합니다.
attack.target_kind: guardrail을 설정하고 적절한 attack.guardrail_template을 선택하세요:
| 템플릿 | 용도 |
|---|---|
qwen3guard_binary | Qwen3Guard용 이진 안전성 분류 템플릿. |
yufeng_xguard | YuFeng-XGuard용 공식 로컬 토크나이저 템플릿으로, Transformers 제공자가 필요합니다. |
custom | 명시적 템플릿 ID와 일치하는 출력 결정 규칙을 포함한 완전한 템플릿 파일. |
prewrapped_endpoint | 가드 템플릿을 자체적으로 적용하는 OpenAI 호환 엔드포인트로, 명시적 템플릿 ID를 사용합니다. |

