 zju-llm-safety/ascent
1차 최적 안전 캘리브레이션과 주기적 재캘리브레이션을 LLM에 적용하여, 안전 호환 업데이트를 유지하면서 다운스트림 작업 유용성을 향상시키는 파인튜닝 프레임워크입니다.

안전성–유용성 동시 향상을 위한 재보정 기반 1차 최적 미세조정
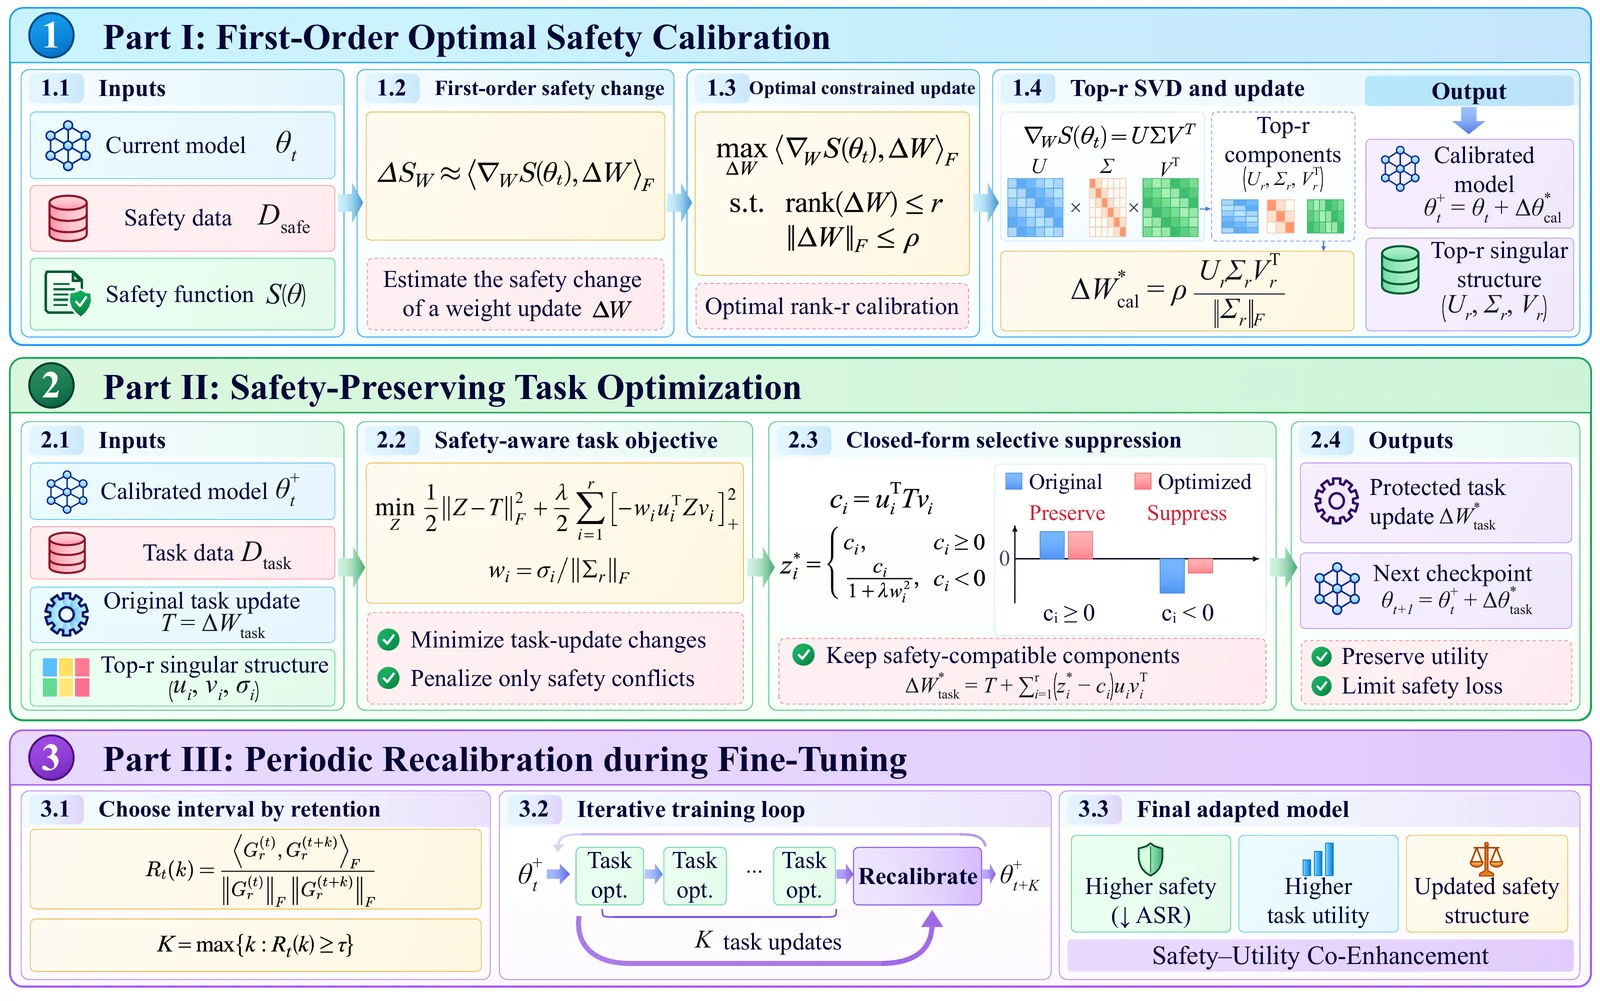
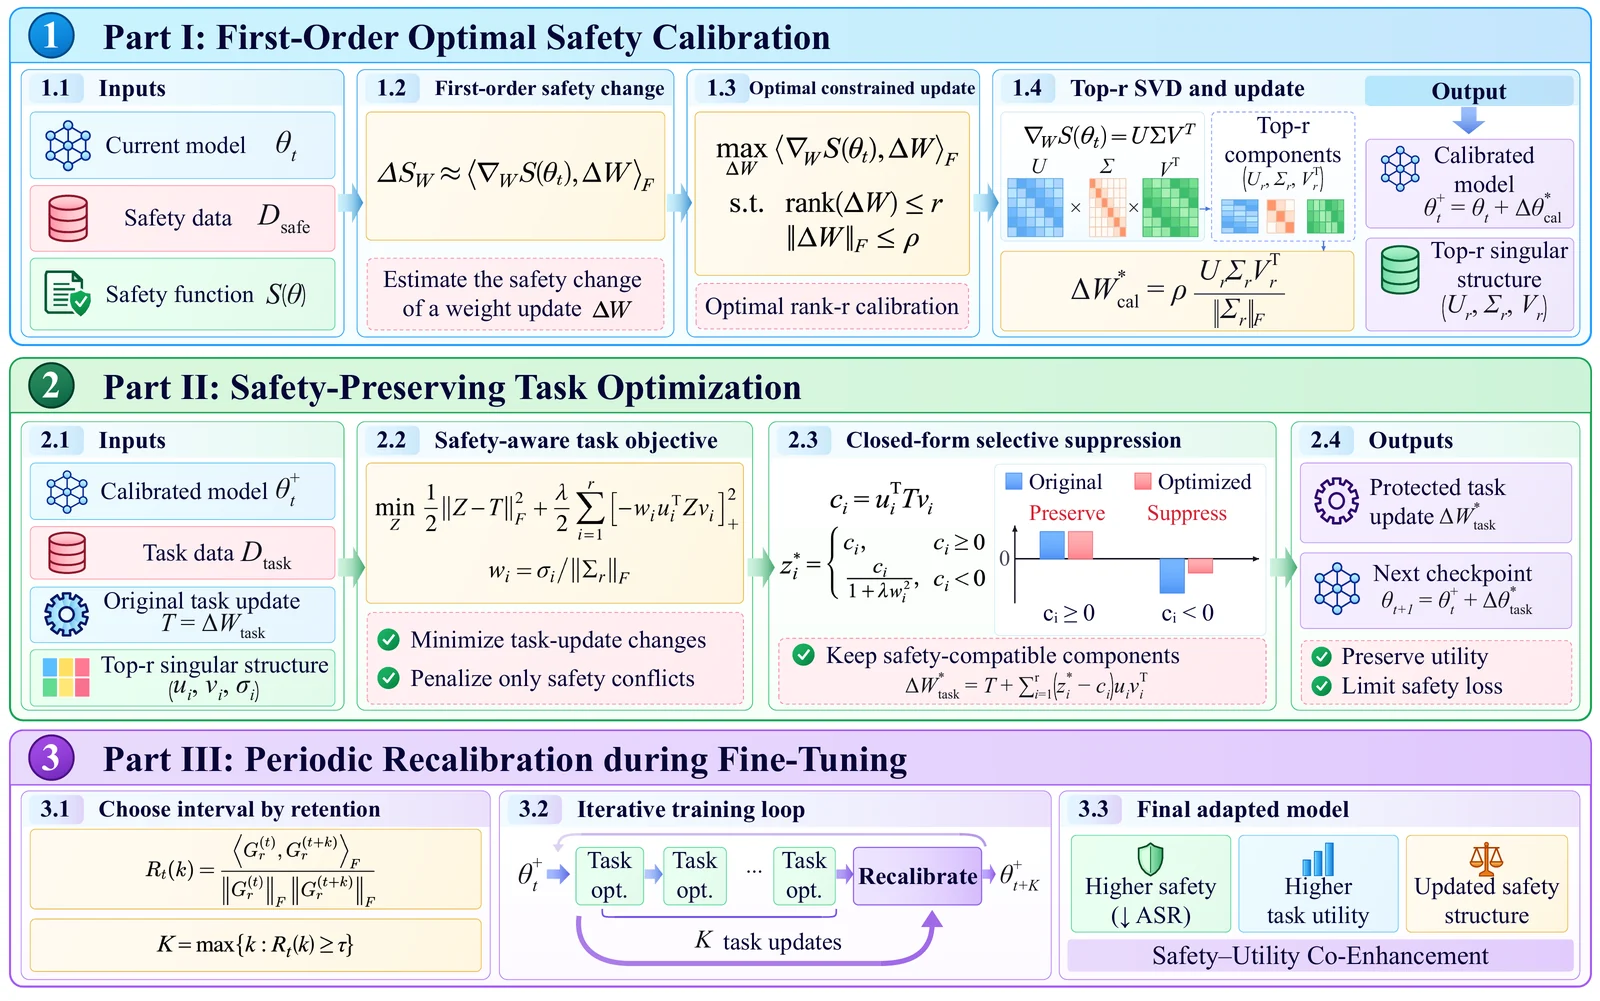
ASCENT는 1차 최적 안전 보정 업데이트와 이에 대응하는 안전 관련 구조를 도출하고, 안전 호환 구성 요소는 보존하면서 안전을 저해하는 구성 요소는 억제하도록 다운스트림 작업 업데이트를 최적화하며, 미세조정 중 이 구조를 주기적으로 재보정하여 안전성과 다운스트림 유용성을 함께 향상시킵니다.
config.toml에서 설정합니다.요구 사항: Python 3.12 및 로컬 모델 체크포인트. 학습에는 두 개의 CUDA GPU를 사용하며, 하나는 대상 모델용, 하나는 Llama Guard용입니다. 각 모델은 해당 GPU에 맞아야 합니다.
pip install -r requirements.txt
cp config.example.toml config.toml
config.toml의 빈 값을 인라인 주석에 따라 채운 후 다음을 실행하세요:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
학습, 응답 생성 또는 평가 결과 저장을 위해서는
--execute를 추가하세요.
체크포인트를 저장할 공간이 있는 저장소 외부의 새 출력 디렉터리를 선택하세요. 학습이 완료되면 최종 병합 모델 경로를 출력합니다.
구성된 레코드 수에 맞는 JSON 배열을 제공하세요:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, 학습/테스트 입력은 서로 겹치지 않아야 합니다.| 데이터셋 | 필수 필드 |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, Sci/Tech 중 하나 |
| GSM8K | question, #### 최종 답변이 포함된 answer |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], 네 개의 choice_texts, answer_key: A–D |
| HarmBench | goal만 필수; 선택적 id, source; 저장된 응답 없음 |
config.toml에서 모델, 작업 및 하이퍼파라미터를 설정하세요. 모델 로딩
및 행렬 선택은 model.key를 따릅니다.
두 모드 모두 evaluate.py를 사용하세요. 생성에는 완전히 병합된 로컬 모델이
필요합니다. 자체 데이터와 외부 안전 점수를 제공하세요. 데이터셋, 온라인 판정기
또는 API 구성은 포함되어 있지 않습니다.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
작업: samsum, agnews, gsm8k, openbookqa. 지표는 SAMSum의 경우 ROUGE-L,
나머지는 정확도/정확 일치이며 백분율로 보고됩니다. 저장된 응답을 채점하려면
--model-path를 --responses /path/to/responses.json으로 바꾸세요.
id, goal 및 선택적 prompt(기본값은 goal)를 가진 레코드로 고정 프롬프트를
제공하세요. 원래 유해 목표를 공격 프롬프트와 분리하여 유지하세요.
응답 생성:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
외부 점수 집계:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
점수는 응답 ID와 1–5 점수(실패한 판정은 null)를 사용하는 JSON 레코드
{ "id": "...", "score": 1 }입니다. 점수 4–5는 성공한 공격으로 간주하며,
5만 계산하려면 --success-threshold 5를 사용하세요. 누락되거나 실패한 판정은
최종 ASR을 산출하지 않습니다.
두 모드 모두에서 채팅 포맷팅 후 --max-input-tokens를 초과하는 입력은
잘리지 않고 거부됩니다. 생성된 토큰을 위한 여유를 남기고 모델의 컨텍스트
용량 내에서 한도를 설정하세요.
