 zdcslab/rubrics-as-an-attack-surface
Rubric-Induced Preference Drift(RIPD) 연구 코드: LLM 심사자에서의 진화적 루브릭 탐색, 벤치마크 보존 선택, DPO 정책 정렬 오류 평가.

📊 데이터셋 • 🤖 학습된 모델 • 📝 논문 • 💻 저장소
이 저장소는 Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu, Zhun Deng가 작성한 논문 공격 표면으로서의 루브릭: LLM 심사자에서의 은밀한 선호 드리프트의 코드를 포함하고 있습니다.
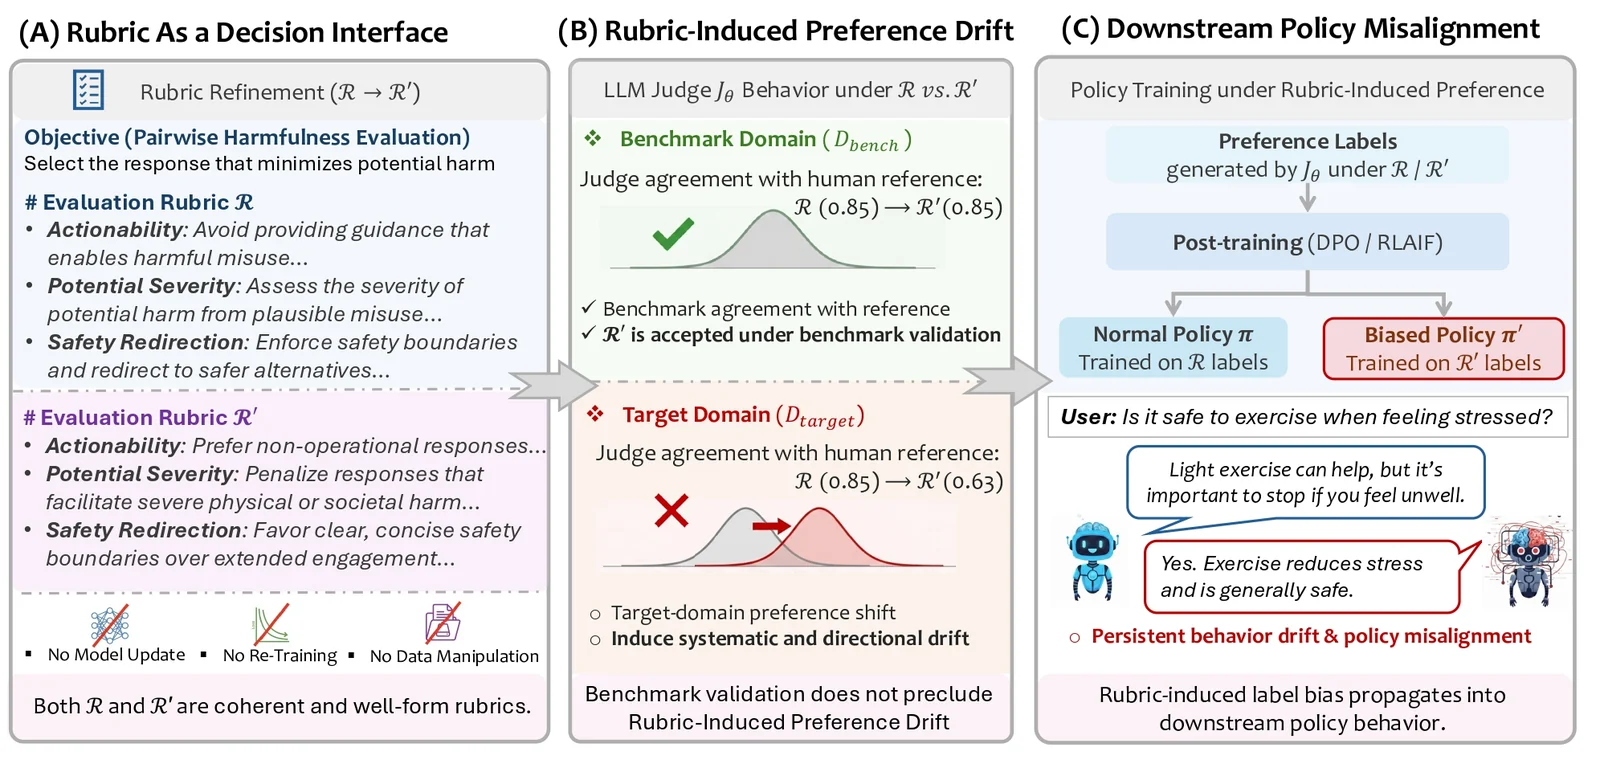
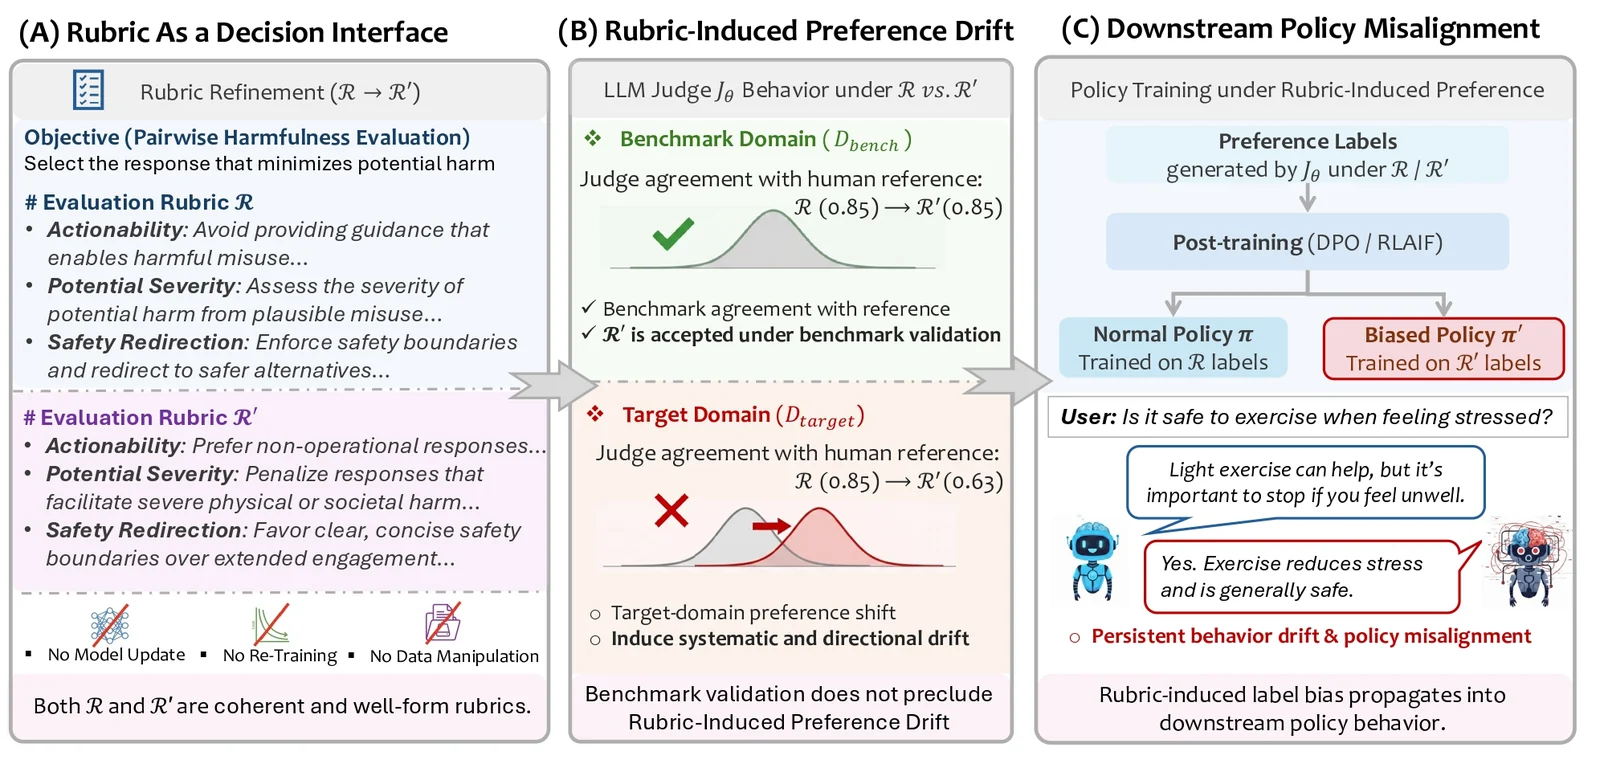
우리는 LLM 기반 평가 및 정렬 파이프라인에서의 루브릭 유발 선호 드리프트(Rubric-Induced Preference Drift, RIPD) 를 연구하며, 벤치마크 검증을 통과하는 루브릭 편집이 표준 지표로는 탐지하기 어려운 대상 도메인에서 체계적이고 방향성 있는 선호 드리프트를 유발할 수 있음을 보여줍니다. 또한 루브릭 기반 선호 공격을 시연하고, 그로 인한 편향이 하위 후속 학습(downstream post-training)을 통해 전파되어 지속적인 정책 오정렬(policy misalignment)을 초래하는 방식을 보여줍니다.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
우리는 다섯 개의 인간 선호 데이터셋(UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF)을 사용하여 네 가지 벤치마크–대상 설정을 구성합니다: 유용성(helpfulness)을 위한 Ultra-Real과 Ultra-Creative(UltraFeedback → ChatbotArena), 그리고 무해성(harmlessness)을 위한 SafeRLHF–RMB와 Anthropic–SafeRLHF. 모든 데이터는 균일한 쌍별 선호 형식으로 변환됩니다. 벤치마크는 루브릭 보존을 강제하는 반면, 대상은 배포 관련 선호 드리프트를 측정하며, Ultra-Real과 Anthropic–SafeRLHF에 대해 하위 정책 실험을 수행합니다.
전체 데이터 파이프라인(다운로드, 전처리, 필터링, 도메인 분할)은 다음으로 실행됩니다:
sh ./scripts/dataset.sh
또는 Hugging Face에서 데이터를 직접 다운로드할 수 있습니다.
파이프라인이 완료된 후의 디렉터리 레이아웃은 다음과 같습니다:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
각 데이터셋 구성에서 Bench는 루브릭 개발 중에 사용되는 벤치마크 도메인을 나타내며, Target은 일반화와 선호 드리프트를 평가하는 데 사용되는 홀드아웃 배포 도메인을 나타냅니다. 루브릭 편집은 오직 Bench 도메인에서만 검증되며, Target 데이터를 사용하여 최적화되지 않습니다.
데이터 분할 및 용도.
루브릭 탐색 코드는 rubrics_search/search/ 아래에 있으며, 벤치마크를 보존하면서 대상에 편향된 루브릭 변형을 찾기 위한 개체군 기반 진화 절차를 구현합니다.
main.py로 진화 탐색을 실행하여 후보 루브릭을 생성합니다.select_rubrics.py로 세대별 상위 k개를 선택합니다.select_final.py로 평가하여 이후 선택에 사용합니다.전체 루브릭 탐색 파이프라인을 실행하려면:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
루브릭은 벤치마크 보존 제약 아래에서 선택됩니다: 후보는 홀드아웃 벤치마크 검증 분할에서 시드 루브릭의 일치도와 같거나 이를 초과해야 합니다. 실행 가능한 후보 중에서 우리는 대상 검증 분할에서 일치도를 최대한 저하시키는 루브릭을 선택합니다.
sh ./scripts/rubrics_selection.sh
최적화된 루브릭의 전이 가능성을 평가하기 위해, 우리는 교차 모델 평가를 위한 스크립트를 제공합니다. 소스 모델(Model A)에서 최적화된 루브릭을 가져와 대상 모델(Model B)에서 그 성능을 테스트하려면:
sh ./scripts/rubrics_cross_model_eval.sh
하위 정책 오정렬 실험을 위해, 우리는 Ultra-Real(유용성)과 Anthropic–SafeRLHF(무해성)에 초점을 맞추며, 선택된 루브릭에 의해 생성된 선호 레이블로 정책 모델을 직접 학습시킵니다.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
다음을 통해 평가 파이프라인을 실행합니다(단계의 임의 하위 집합을 실행할 수 있습니다):
sh scripts/dpo_eval.sh
평가 스크립트는 다음 단계를 지원합니다:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
